Baseten
Déploiement
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
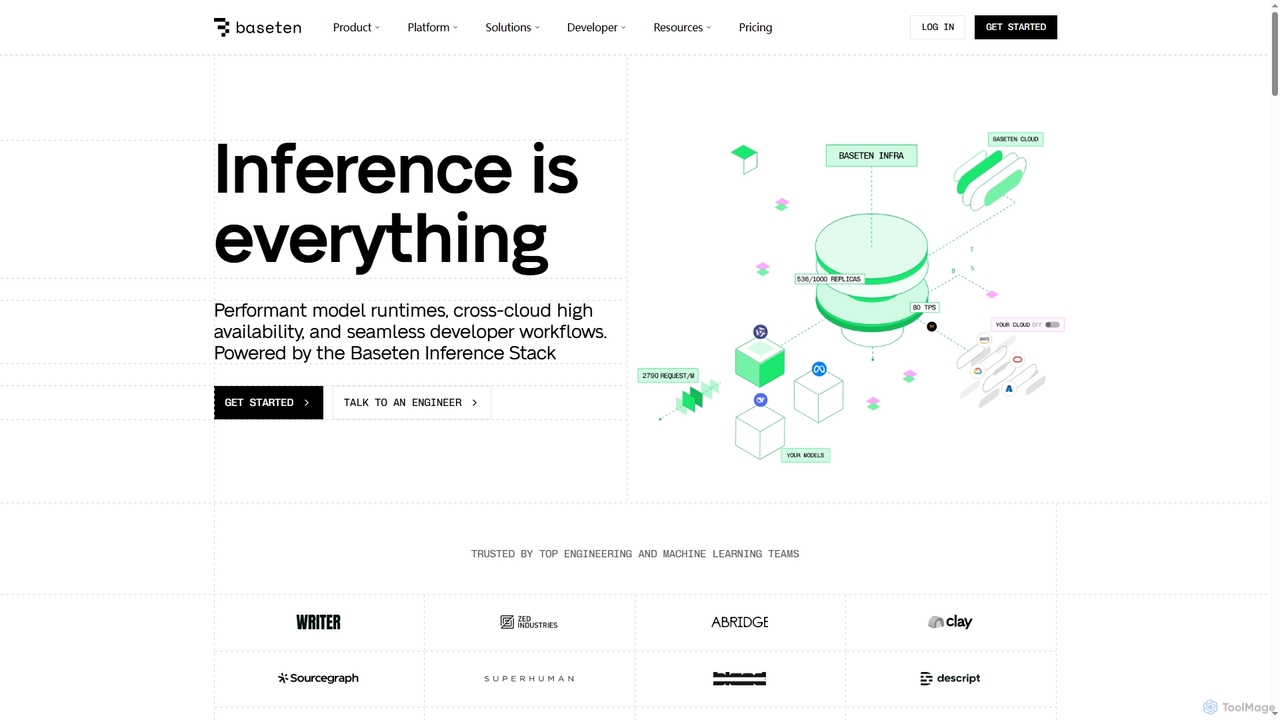
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
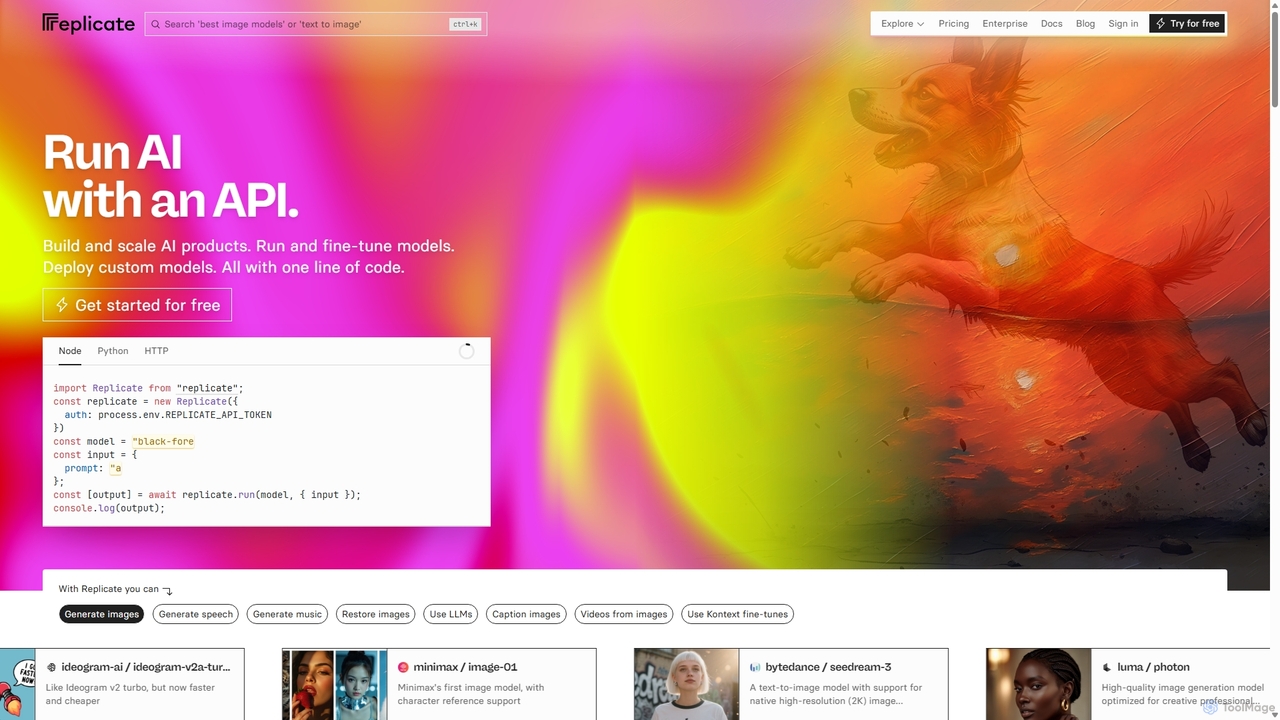
Replicate est une plateforme cloud pour les développeurs permettant d'exécuter, d'affiner et de déployer des modèles d'IA via une API simple. Elle élimine le besoin de gérer une infrastructure complexe, offrant un accès à des milliers de modèles avec une tarification à l'usage et une mise à l'échelle automatique.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Données clés | Baseten | Replicate |
|---|---|---|
| Pricing model | Freemium | Paid |
| Product type | Web | Web |
| Primary focus | Déploiement | Apprentissage automatique |
| Publics et métiers | Chercheur en IA · Directeur Technique · Scientifique de données · Ingénieur en Machine Learning · Chef de Produit · Développeur de logiciels | Chercheur en IA · Scientifique de données · Ingénieur DevOps · Ingénieur en Machine Learning · Chef de Produit · Développeur de logiciels · Fondateur de startup |
| Catégories | Déploiement · Apprentissage automatique · Cloud Computing | Apprentissage automatique · Plateforme en tant que service · API |
| Added | 1 nov. 2025 | 8 sept. 2025 |
| Mis à jour | 19 nov. 2026 | 19 nov. 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Baseten est une plateforme complète conçue pour déployer, servir et mettre à l'échelle des modèles d'IA dans des environnements de production. Elle fournit l'infrastructure, les outils et l'expertise nécessaires pour commercialiser rapidement et efficacement des produits d'IA. Propulsée par le Baseten Inference Stack, elle offre des runtimes de modèles performants, une haute disponibilité inter-cloud et une expérience centrée sur le développeur pour les charges de travail d'inférence critiques.
1. Choisissez votre méthode de déploiement : Utilisez les API de modèles pour un accès instantané à des modèles pré-optimisés pour le prototypage, ou créez un déploiement dédié pour des modèles personnalisés, affinés ou open-source.
2. Empaquetez votre modèle avec Truss, le standard open-source de Baseten, qui prend en charge n'importe quel framework d'apprentissage automatique.
3. Déployez votre modèle dans votre environnement préféré : le cloud entièrement géré de Baseten, votre propre VPC pour l'auto-hébergement, ou une configuration hybride combinant les deux.
4. Mettez à l'échelle votre application automatiquement en fonction du trafic, en bénéficiant de fonctionnalités telles que des démarrages à froid rapides et une disponibilité de 99,99 %.
5. En option, tirez parti de l'infrastructure de Baseten optimisée pour l'inférence pour entraîner vos modèles afin d'obtenir les meilleures performances de production possibles.
Baseten est idéal pour construire des applications d'IA exigeantes et en temps réel. Les cas d'utilisation incluent l'alimentation d'agents téléphoniques d'IA à faible latence, le développement de produits d'IA générative pour la création d'images et de texte, le service de modèles d'intégration à haut débit pour la recherche et la récupération, et le déploiement de LLM sur mesure pour des industries spécialisées comme la finance et la santé.
Les principaux avantages de Baseten sont ses performances exceptionnelles, sa rentabilité et sa scalabilité. En optimisant l'ensemble de la pile d'inférence, il réduit considérablement la latence et augmente le débit, comme en témoigne l'aide apportée à des clients comme Bland AI pour atteindre des temps de réponse inférieurs à 400 ms. Son modèle de paiement à l'utilisation élimine les coûts liés au temps d'inactivité, tandis que la mise à l'échelle automatique basée sur le trafic garantit la fiabilité en cas de croissance rapide. La plateforme est également certifiée SOC 2 Type II et conforme à la norme HIPAA, garantissant une sécurité de niveau entreprise.
Baseten propose une structure de tarification à plusieurs niveaux conçue pour la croissance :
- Basic : Un plan de paiement à l'utilisation à partir de 0 $/mois. Il comprend l'accès aux déploiements dédiés, aux API de modèles, aux démarrages à froid rapides, et est conforme aux normes SOC 2 Type II et HIPAA.
- Pro : Un plan sur devis personnalisé qui ajoute un accès prioritaire aux GPU très demandés, des ressources de calcul dédiées, des limites de taux plus élevées et un support pratique via Slack et Zoom.
- Enterprise : Un plan sur devis personnalisé pour un contrôle total, offrant l'auto-hébergement dans votre VPC, des SLA personnalisés, une sécurité avancée et la possibilité d'utiliser les engagements cloud existants.
L'utilisation est facturée selon deux modèles :
- API de modèles : Prix par million de jetons d'entrée et de sortie. Par exemple, Kimi K2 coûte 0,60 $/1M de jetons d'entrée et 2,50 $/1M de jetons de sortie.
- Déploiements dédiés : Facturés à la minute de temps de calcul. Par exemple, une instance GPU A10G est facturée 0,02012 $ par minute, et un GPU H100 coûte 0,10833 $ par minute.
Replicate est une plateforme cloud conçue pour démocratiser l'accès à l'intelligence artificielle, en permettant à tout développeur de logiciels d'exécuter, d'affiner (fine-tuning) et de déployer facilement des modèles d'apprentissage automatique. Sa mission principale est de supprimer l'immense complexité traditionnellement associée à la gestion de l'infrastructure ML. Au lieu de se battre avec des serveurs d'API, des pilotes CUDA, l'approvisionnement de GPU et la gestion des dépendances, les développeurs peuvent exploiter la puissante API de Replicate pour intégrer des modèles d'IA de pointe dans leurs applications avec seulement quelques lignes de code. La plateforme héberge des milliers de modèles open-source de la communauté, couvrant un large éventail d'applications allant de la génération d'images et de vidéos à l'analyse de texte et au traitement audio.
Démarrer avec Replicate est conçu pour être simple, s'adaptant à différents niveaux de complexité.
1. Exécuter des modèles existants : La manière la plus simple d'utiliser Replicate est d'exécuter l'un des milliers de modèles préexistants disponibles dans sa bibliothèque publique. Cela peut être réalisé avec un seul appel d'API. Par exemple, en Python, vous pouvez générer une image avec un modèle comme FLUX Dev :import Replicate
output = Replicate.run(
"black-forest-labs/flux-dev",
input={
"prompt": "Un astronaute chevauchant une licorne arc-en-ciel, cinématique, dramatique"
}
)
print(output)
Cela abstrait toute la complexité du backend, permettant aux développeurs de se concentrer sur la logique de leur application.
2. Affiner les modèles (Fine-Tune) : Pour des tâches plus spécifiques, vous pouvez affiner des modèles existants avec vos propres données. C'est particulièrement utile pour créer des modèles qui reconnaissent une personne, un objet ou un style artistique spécifique. Le processus consiste à créer une tâche d'entraînement via l'API, en fournissant votre jeu de données (par exemple, un fichier zip d'images) et un mot déclencheur. Replicate gère le processus d'entraînement et crée une nouvelle version de modèle personnalisée que vous pouvez utiliser.
3. Déployer des modèles personnalisés : Si vous avez votre propre modèle d'apprentissage automatique, vous pouvez le déployer sur l'infrastructure de Replicate. Cela se fait à l'aide de Cog, l'outil open-source de Replicate pour empaqueter les modèles ML dans des conteneurs standard et reproductibles. Vous définissez l'environnement de votre modèle dans un fichier cog.yaml (en spécifiant la version de Python, les paquets, les exigences GPU) et son interface de prédiction dans un fichier predict.py. Après avoir testé localement avec cog predict, vous pouvez pousser le conteneur vers Replicate avec cog push, et il devient instantanément disponible via la même API simple que les modèles publics.
Cog pour empaqueter et déployer vos propres modèles, vous offrant un contrôle et une flexibilité totale.La polyvalence de Replicate le rend adapté à un large éventail d'applications :
Le principal avantage de Replicate est sa simplification radicale du MLOps. Il abstrait les parties difficiles du déploiement de modèles d'apprentissage automatique à grande échelle.
Cog.Replicate fonctionne sur un modèle de tarification transparent à l'usage. Vous ne payez que pour les ressources de calcul que vous utilisez, facturées à la seconde.
La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.
Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 70.97% | 188.5K |
| 🇨🇦Canada | 8.11% | 21.5K |
| 🇻🇳Vietnam | 7.87% | 20.9K |
| 🇮🇳India | 7% | 18.6K |
| 🇩🇪Germany | 6.05% | 16.1K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Direct | 85.63% | 227.4K |
| Référence | 10.77% | 28.6K |
| 3.6% | 9.6K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 37.37% | 469.1K |
| 🇮🇳India | 27.74% | 348.3K |
| 🇨🇳China | 13.53% | 169.9K |
| 🇬🇧United Kingdom | 11.64% | 146.1K |
| 🇩🇪Germany | 9.72% | 122K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Direct | 92.92% | 1.2M |
| Référence | 5.48% | 68.8K |
| 1.6% | 20.1K |
Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.
Vous pouvez déployer des modèles open-source et personnalisés sur Baseten. La plateforme prend en charge n'importe quel modèle construit dans n'importe quel framework via Truss, son standard open-source pour l'empaquetage et le service de modèles. Vous pouvez également commencer avec des modèles prêts à l'emploi de la bibliothèque de modèles de Baseten.
Vous avez un contrôle total sur les GPU que vos modèles utilisent. Baseten fournit une liste complète des GPU actuellement disponibles dans sa référence de types d'instance. Si vous avez besoin d'un type de GPU spécifique qui n'est pas listé, vous pouvez contacter leur équipe pour le demander.
Non, vous ne payez pas pour le temps d'inactivité. Vous ne payez que pour le temps où votre modèle utilise activement les ressources de calcul sur Baseten, ce qui inclut le déploiement, la mise à l'échelle ou l'exécution de prédictions. Vous avez un contrôle total sur le comportement de mise à l'échelle de votre modèle.
Oui, Baseten est certifié SOC 2 Type II et conforme à la norme HIPAA, garantissant qu'il répond à des normes élevées de sécurité et de protection des données adaptées aux applications d'entreprise et de santé.
Oui, avec le plan Enterprise, vous pouvez auto-héberger Baseten dans vos propres VPC. Cela vous permet de conserver un contrôle total sur la sécurité, la résidence des données et d'utiliser vos engagements cloud existants.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.