Crawlbase
Collecte de données
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Collecte de données
Extraction de Données
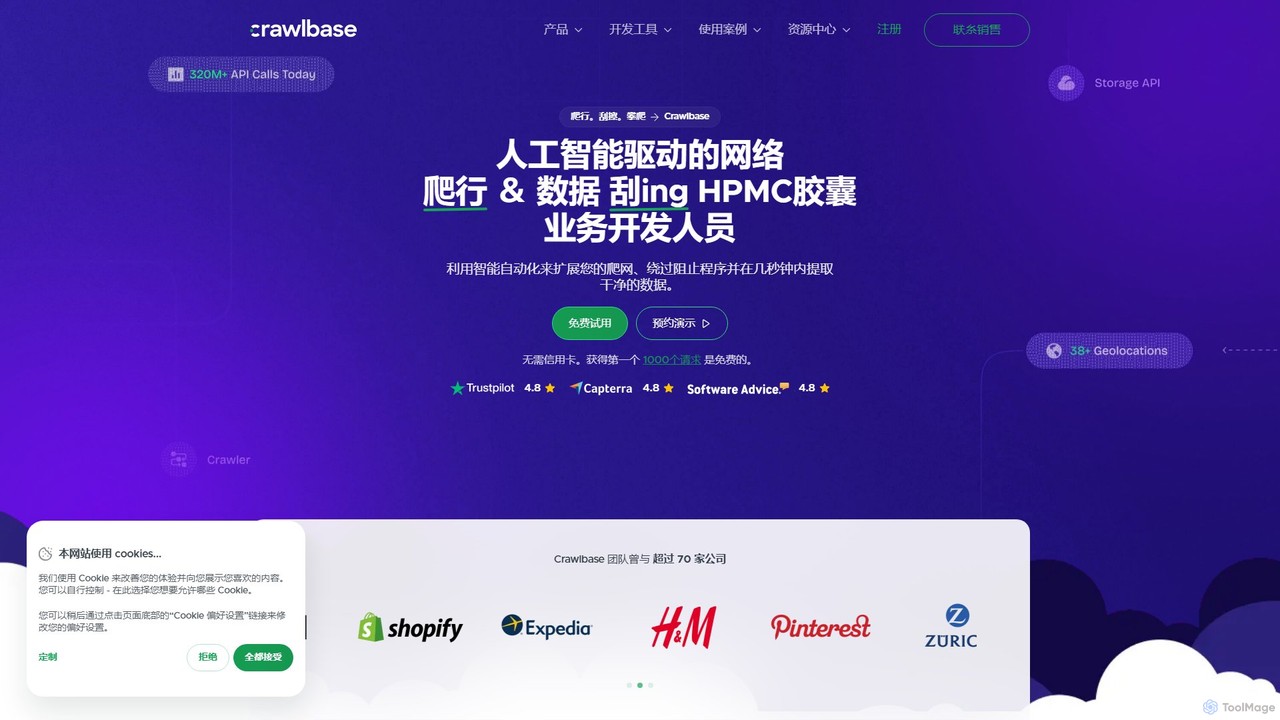
Crawlbase est une plateforme de web scraping et de crawling alimentée par l'IA, conçue pour les développeurs et les entreprises. Elle simplifie l'extraction de données en gérant les proxys, les CAPTCHA et les systèmes anti-bots, vous permettant de crawler anonymement n'importe quel site web et de récupérer des données propres et structurées à grande échelle. Elle offre une suite d'outils comprenant une API de Crawling, un Smart Proxy et un Stockage Cloud.
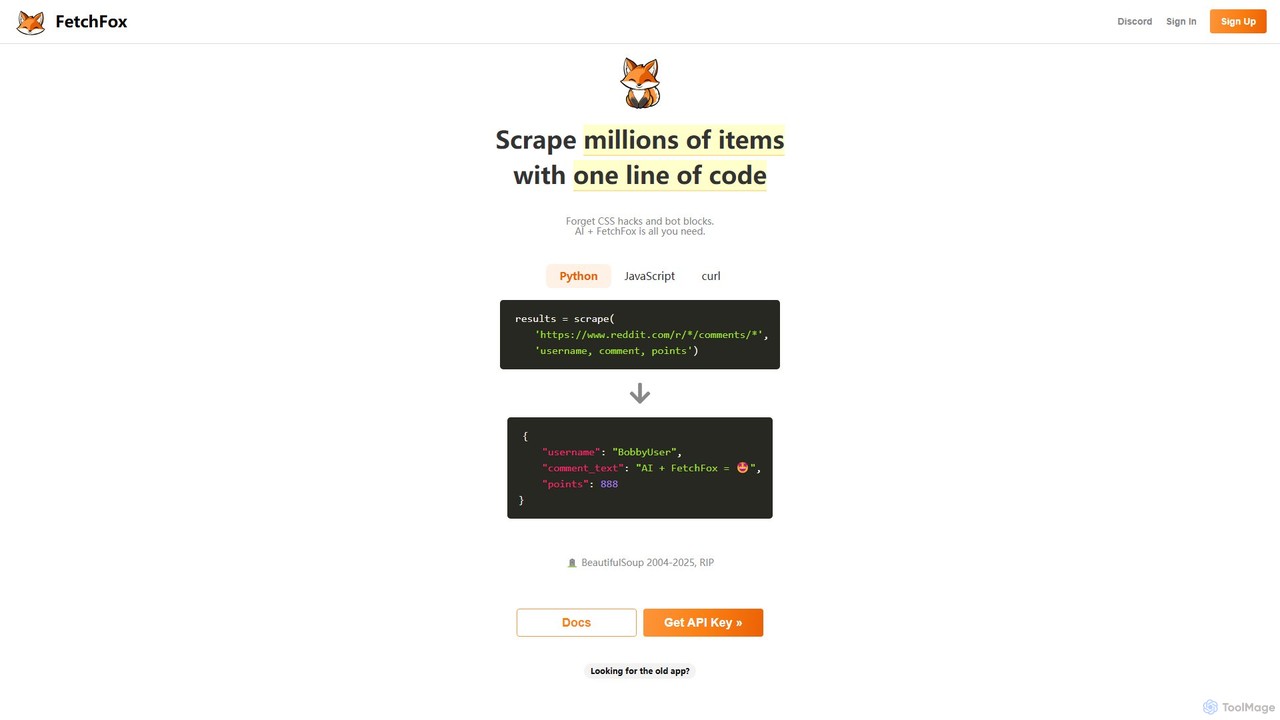
FetchFox est un outil de web scraping alimenté par l'IA qui permet aux utilisateurs d'extraire des données de n'importe quel site web à l'aide de simples invites textuelles. Il élimine le besoin de codage complexe ou de sélecteurs CSS, en gérant automatiquement les mesures anti-bot. Disponible sous forme d'API, de bibliothèque JavaScript et d'extension Chrome, il est conçu pour que les développeurs et les utilisateurs non techniques puissent automatiser la collecte de données sans effort.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Données clés | Crawlbase | FetchFox |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Collecte de données | Extraction de Données |
| Publics et métiers | Non vérifié | Non vérifié |
| Catégories | Collecte de données · Extraction de Données · Web scraping · SEO | Extraction de Données · Web scraping · Génération de leads · Automatisation |
| Added | 15 août 2025 | 13 août 2025 |
| Mis à jour | 19 nov. 2026 | 19 nov. 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Crawlbase est une plateforme complète d'extraction de données pilotée par l'IA qui permet aux développeurs et aux entreprises d'accéder librement et anonymement aux données du web. Fondée sur le principe de la 'liberté des données', Crawlbase fournit une suite robuste d'outils conçus pour surmonter les défis courants du web scraping, tels que les blocages d'IP, les CAPTCHA et les restrictions géographiques. Avec une infrastructure massive de millions de proxys résidentiels et de centres de données rotatifs, elle garantit des taux de réussite élevés et une fiabilité pour tout projet de collecte de données.
La plateforme est conçue pour la scalabilité, répondant aussi bien aux petits projets qu'aux besoins des grandes entreprises, comme en témoigne son adoption par de grandes sociétés comme Intel. La philosophie centrale de Crawlbase est de simplifier le processus complexe du web crawling, permettant aux utilisateurs de se concentrer sur l'analyse des données plutôt que sur la gestion de l'infrastructure. Ses capacités d'IA sont particulièrement utiles pour l'entraînement de modèles de langage, car l'API peut naviguer intelligemment sur les sites web, extraire des informations pertinentes et les livrer dans un format structuré et lisible par machine.
Le démarrage avec Crawlbase est conçu pour être rapide et simple, ne prenant généralement que quelques minutes. Tout d'abord, vous devez créer un compte gratuit sur le site web de Crawlbase, qui ne nécessite pas de carte de crédit et inclut 1 000 requêtes gratuites pour commencer. Une fois inscrit, vous recevrez un jeton d'API. Pour utiliser le service, il vous suffit de faire un appel API à l'un des points de terminaison de Crawlbase, comme l'API de Crawling ou le Smart Proxy. Pour l'API de Crawling, vous passez votre jeton et l'URL cible que vous souhaitez scraper. L'API gère l'ensemble du processus de rotation des proxys, de gestion des en-têtes et de contournement des blocages, en retournant le HTML brut de la page. Pour une utilisation plus avancée, vous pouvez spécifier des paramètres pour le rendu JavaScript, le géociblage, et plus encore.
Crawlbase est polyvalent et peut être appliqué à un large éventail de tâches basées sur les données. Pour les entreprises de commerce électronique, il est utilisé pour l'intelligence des prix, la surveillance des prix des concurrents et le suivi de la disponibilité des produits. En marketing, il est essentiel pour la surveillance du SEO, le suivi du classement des mots-clés et la collecte de données d'études de marché. Les institutions financières l'utilisent pour agréger des données financières de diverses sources pour l'analyse et le trading. Un cas d'utilisation important se situe dans le domaine de l'intelligence artificielle, où les entreprises utilisent Crawlbase pour collecter de vastes ensembles de données du web afin d'entraîner de grands modèles de langage (LLM) et d'autres systèmes d'IA. Il est également utilisé pour la génération de leads, l'agrégation de données immobilières et la recherche universitaire.
Le principal avantage de Crawlbase est sa capacité à abstraire les complexités du web scraping. Les utilisateurs n'ont plus besoin de gérer leur propre infrastructure de proxys, de s'occuper de la rotation des adresses IP ou de développer des solutions pour contourner des mesures anti-bots sophistiquées. Cela se traduit par des économies significatives de temps, de ressources de développement et de coûts opérationnels. Sa grande scalabilité garantit qu'il peut évoluer avec vos besoins, de quelques milliers de requêtes à des milliards. Le support expert 24/7 fournit une assistance fiable, et son engagement envers la conformité au RGPD et au CCPA offre une tranquillité d'esprit. L'approche innovante de la plateforme et sa fiabilité éprouvée en ont fait un leader sur le marché de l'extraction de données.
Crawlbase fonctionne sur un modèle freemium. Les nouveaux utilisateurs peuvent s'inscrire pour un essai gratuit qui inclut 1 000 requêtes réussies sans avoir besoin d'une carte de crédit. Cela permet de tester en profondeur les capacités de l'API. Après l'essai, Crawlbase propose une variété de plans payants dont le prix est basé sur le nombre de requêtes et les fonctionnalités spécifiques requises. Les plans sont conçus pour être flexibles et répondre à un large éventail d'utilisateurs, des développeurs individuels aux grandes entreprises. Pour des informations tarifaires détaillées et à jour, il est recommandé de visiter le site officiel de Crawlbase.
FetchFox est une plateforme révolutionnaire de web scraping alimentée par l'IA, conçue pour simplifier et automatiser le processus d'extraction de données sur le web. Elle change fondamentalement la manière dont les utilisateurs abordent le web scraping en remplaçant le codage complexe, les sélecteurs CSS et la maintenance de scripts fragiles par des invites simples en langage naturel. Que vous soyez un développeur ayant besoin d'intégrer des données dans une application ou un utilisateur professionnel cherchant à recueillir des informations sur le marché, FetchFox offre une solution robuste et accessible.
Le principe de base de FetchFox est son moteur d'IA, qui comprend intelligemment la structure et le contenu d'une page web. Les utilisateurs décrivent simplement les données qu'ils souhaitent extraire, et l'IA s'occupe du reste. Cela inclut la navigation entre les pages, l'identification des points de données pertinents et la structuration de la sortie dans un format propre et utilisable comme le JSON. La plateforme est conçue pour être résiliente, s'adaptant automatiquement aux changements de mise en page des sites web et contournant les technologies anti-scraping courantes telles que les CAPTCHAs et les blocages d'IP, qui sont des obstacles majeurs pour les méthodes de scraping traditionnelles.
FetchFox offre des moyens flexibles d'utiliser son service, répondant aux différents besoins des utilisateurs :
1. Pour les développeurs (API et bibliothèques) :
2. Pour les utilisateurs non techniques (Extension Chrome) :
FetchFox est polyvalent et peut être appliqué dans diverses industries et rôles :
Le principal avantage de FetchFox est sa simplicité radicale et sa puissance. Il démocratise le web scraping, le rendant accessible aux utilisateurs sans bagage technique. Pour les développeurs, il accélère considérablement le processus de développement en abstrayant les aspects les plus fastidieux et les plus difficiles du scraping. Sa résilience aux changements de sites web signifie moins de temps passé à maintenir des scripts cassés et plus de temps concentré sur l'utilisation des données. La combinaison d'un moteur d'IA puissant et d'une infrastructure robuste en fait un outil très efficace et fiable pour toute tâche d'extraction de données.
FetchFox utilise un modèle de tarification transparent et simple, basé sur l'utilisation (pay-as-you-go).
La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.
Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇹🇼Taiwan | 100% | 131 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇮🇳India | 45.78% | 18.5K |
| 🇺🇸United States | 44.91% | 18.1K |
| 🇪🇸Spain | 9.31% | 3.8K |
Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.