ToolMage
Connexion

AI TOOL COMPARISON

Elementary Data vs Lilac

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

Elementary Data Aperçu du produit

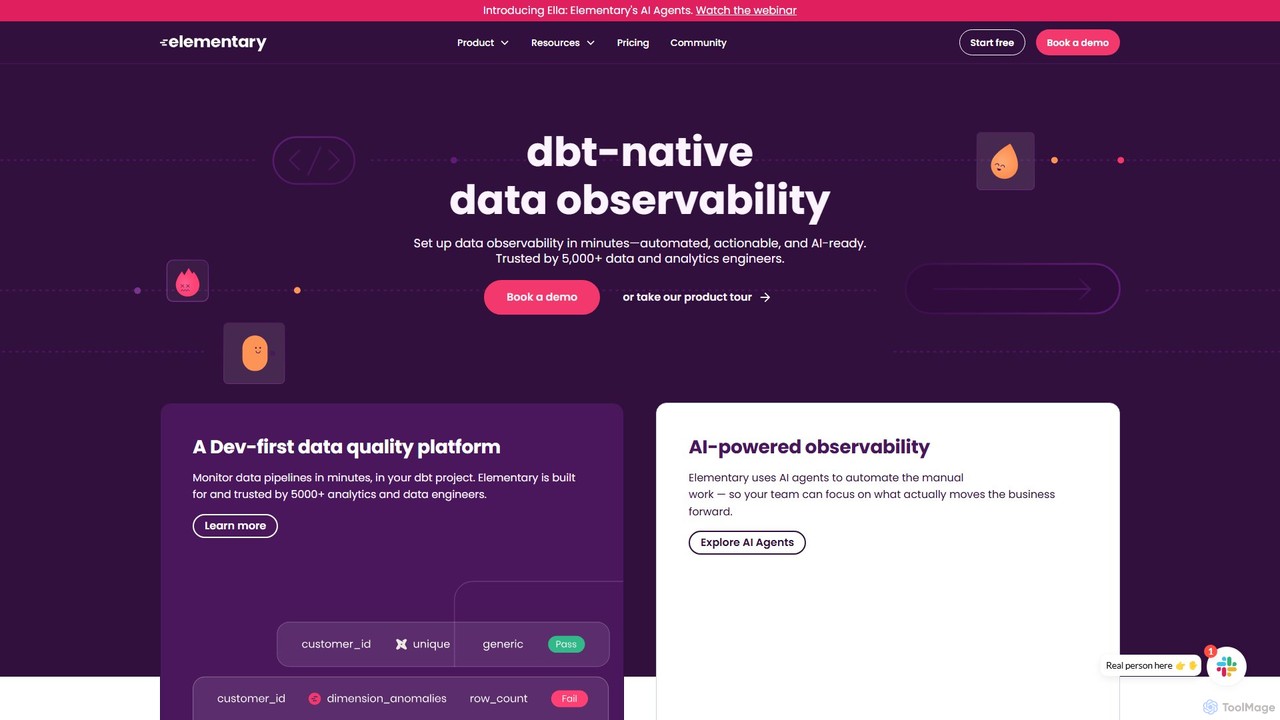
Elementary Data est une plateforme d'observabilité des données native de dbt, conçue pour les ingénieurs de données et d'analyse. Elle utilise des agents IA pour automatiser la surveillance de la qualité des données, détecter les anomalies et fournir une lignée de données de bout en bout. La plateforme aide les équipes à réduire le bruit des alertes, à résoudre les incidents plus rapidement et à instaurer la confiance dans leurs données pour les applications d'IA et d'analyse.

Preview

Lilac Aperçu du produit

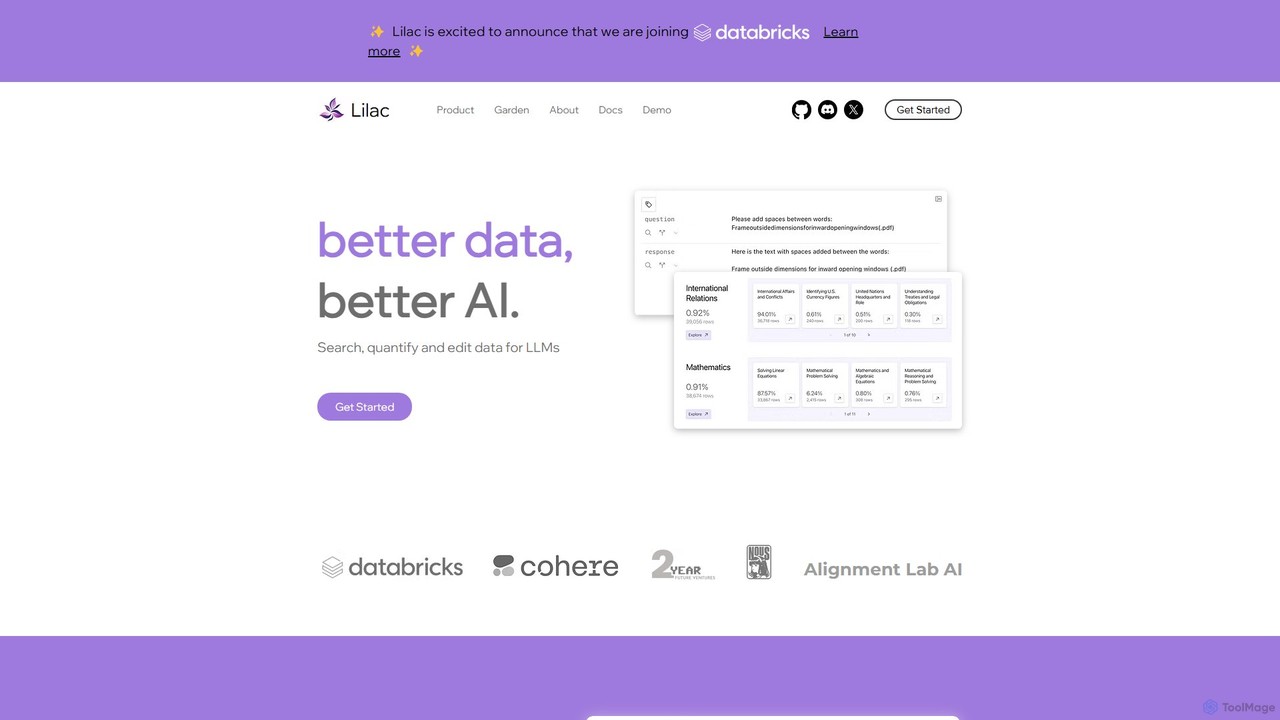
Lilac est un outil open-source pour les scientifiques des données et les ingénieurs ML afin d'explorer, nettoyer et améliorer les ensembles de données pour les grands modèles de langage (LLM). Il offre une recherche sémantique puissante, un regroupement de données et une analyse de qualité pour construire une meilleure IA.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Elementary Data VS Lilac — Données clés
Données clésElementary DataLilac
Pricing modelFreemiumFree
Product typeWebWeb
Primary focusObservabilitéEntraînement de modèle
Publics et métiersNon vérifiéNon vérifié
CatégoriesObservabilité · Gestion des Données · AnalyseEntraînement de modèle · Analyse de données · Gestion des Données
Added12 août 20256 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Elementary Data

Elementary Data est une plateforme d'observabilité des données native de dbt, axée sur les développeurs et approuvée par des milliers d'ingénieurs de données et d'analyse. Elle est conçue pour opérationnaliser la qualité des données tout au long de leur cycle de vie, de la détection à la résolution. En s'appuyant sur des agents IA, Elementary automatise les tâches manuelles, permettant aux équipes de données de se concentrer sur des activités à fort impact qui génèrent de la valeur commerciale. La plateforme s'attaque au défi critique de la qualité des données, qui est souvent le principal obstacle à la réussite de la mise en œuvre de l'IA et à l'adoption des produits de données, en veillant à ce que de mauvaises entrées ne conduisent pas à des modèles défaillants ou à des décisions non fiables.

Comment utiliser Elementary Data

La prise en main d'Elementary Data est conçue pour être rapide et transparente, en particulier pour les équipes qui utilisent déjà dbt. Le processus implique généralement :

  1. Installation : Installez le package dbt open-source d'Elementary en tant que SDK dans votre projet dbt existant. Cela peut être fait en quelques minutes.
  2. Configuration : Configurez vos environnements et connectez vos sources de données. Elementary ne nécessite qu'un accès en lecture aux métadonnées et aux résultats des tests, et non à vos données brutes, garantissant ainsi la sécurité et la conformité (certifié SOC-2 Type II).
  3. Surveillance : Une fois configuré, Elementary commence automatiquement à surveiller vos pipelines de données. Il capture les échecs des tests dbt, détecte les anomalies dans la fraîcheur et le volume des données, et collecte des métriques de performance.
  4. Alertes et Triage : Utilisez la plateforme Cloud d'Elementary pour gérer les alertes. Vous pouvez personnaliser les règles de routage pour notifier les bonnes personnes ou équipes via Slack ou d'autres canaux. La plateforme fournit un contexte, y compris la lignée et les propriétaires, pour aider à trier et résoudre les problèmes plus rapidement.
  5. Exploration et Gouvernance : Utilisez le catalogue de données natif pour explorer les schémas, visualiser la lignée au niveau des colonnes et comprendre la santé des données. Les agents IA peuvent aider à la découverte de la couverture des tests et au triage automatisé.

Fonctionnalités principales de Elementary Data

  • Agents IA (Ella) : Automatisez le travail manuel tel que le triage des incidents, la découverte de la couverture des tests, l'optimisation des performances et la gouvernance des données pour accroître l'efficacité.
  • Tests de Qualité des Données : Gérez les tests dbt, les tests natifs d'Elementary et les tests SQL personnalisés à partir d'une seule plateforme unifiée.
  • Détection Automatisée des Anomalies : Surveillez de manière proactive les données pour détecter les anomalies de fraîcheur, de volume et de schéma sans configuration manuelle.
  • Lignée des Données de Bout en Bout : Visualisez la lignée au niveau des colonnes pour comprendre les dépendances des données, remonter à la source des problèmes et évaluer l'impact des changements.
  • Gestion des Incidents et des Alertes : Réduisez le bruit avec des alertes simplifiées et riches en contexte. Acheminez les notifications aux bonnes parties prenantes et gérez les incidents de la détection à la résolution.
  • Scores de Santé des Données : Obtenez un aperçu rapide et de haut niveau de la qualité et de la fiabilité de vos données à travers différentes dimensions de qualité.
  • Surveillance des Performances et des Coûts : Identifiez et résolvez les goulots d'étranglement dans vos pipelines de données, suivez les temps d'exécution et surveillez les tendances de performance pour optimiser les coûts.
  • Catalogue de Données Natif : Une alternative enrichie à dbt docs, offrant un emplacement centralisé pour la découverte de données, la gestion des métadonnées et la compréhension des actifs de données.

Cas d'utilisation pour Elementary Data

Elementary Data est polyvalent et prend en charge diverses initiatives basées sur les données. Par exemple, une entreprise comme Flock Safety a utilisé Elementary pour établir un programme pratique de gouvernance des données. En se concentrant sur la qualité et la découverte des données, ils ont instauré la confiance parmi les partenaires commerciaux et les ingénieurs d'analyse. Cela a conduit à une augmentation de la consommation de données, une meilleure collaboration et une prise de décision plus fiable. D'autres cas d'utilisation incluent :

  • Prévention des Hallucinations de l'IA : Assurer des entrées de données de haute qualité pour les modèles d'IA et d'apprentissage automatique afin de prévenir les résultats erronés et de construire des systèmes fiables.
  • Réduction de la Fatigue des Alertes : Les équipes de données d'entreprises comme Hippo utilisent Elementary pour filtrer le bruit et ne recevoir des alertes que pour les véritables pannes de production, éliminant ainsi le 'cauchemar' des notifications constantes et non pertinentes.
  • Amélioration de la Confiance des Parties Prenantes : Fournir aux parties prenantes un aperçu quotidien clair de la santé des données, leur donnant confiance dans la qualité des données qu'elles utilisent pour leurs décisions.
  • Établissement de la Confiance dans les Données : Utiliser les capacités de test, de balisage et de métadonnées d'Elementary pour créer un 'standard d'or' de confiance dans les actifs de données.

Avantages de Elementary Data

Le principal avantage d'Elementary est son intégration profonde et native avec l'écosystème dbt, ce qui en fait un choix naturel pour les équipes de données modernes. Son approche axée sur les développeurs garantit qu'il s'intègre parfaitement dans les flux de travail existants. L'utilisation d'agents IA pour l'automatisation réduit considérablement l'effort manuel et améliore l'efficacité de l'équipe. De plus, sa couverture complète de l'ensemble du cycle de vie de la qualité des données — des tests et de la surveillance à la résolution des incidents et à la gouvernance — en fait une solution tout-en-un. La plateforme est sécurisée par conception, n'accédant jamais aux données brutes, et propose à la fois une version open-source puissante et des plans cloud évolutifs pour les entreprises.

Tarification et plans

Elementary propose un modèle de tarification flexible basé sur le nombre d'utilisateurs, avec une option open-source gratuite et des plans cloud payants. Un essai gratuit de 30 jours du plan Essentials est disponible.

  • Open Source (OSS) : Une version communautaire gratuite et auto-hébergée que des milliers d'équipes utilisent en production.
  • Plan Starter : 650 $/mois. Comprend jusqu'à 2 utilisateurs, la détection et le triage des problèmes de données, la détection automatisée des anomalies, la lignée au niveau des colonnes et la surveillance des performances.
  • Plan Essentials : 1600 $/mois. Comprend tout ce qui se trouve dans le plan Starter pour un maximum de 8 utilisateurs, ainsi que des fonctionnalités de collaboration, tous les agents IA, la gestion des incidents, la lignée de bout en bout et un support Slack dédié.
  • Plan Enterprise : Tarification personnalisée. Comprend tout ce qui se trouve dans le plan Essentials avec des sièges flexibles, une sécurité de niveau entreprise (RBAC, SCIM), des options de déploiement avancées, des SLA de support premium et des intégrations avec des outils comme Jira et PagerDuty.

Lilac

Lilac est une puissante plateforme open-source conçue pour révolutionner la manière dont les développeurs et les scientifiques des données interagissent avec les données pour le développement de modèles d'IA. Basée sur le principe "De meilleures données, une meilleure IA", Lilac fournit une suite complète d'outils pour rechercher, quantifier et éditer des ensembles de données, en particulier ceux utilisés pour l'entraînement et l'ajustement fin des Grands Modèles de Langage (LLM). Elle répond au besoin critique de données de haute qualité en rendant le processus d'exploration, de nettoyage et de curation des données plus efficace, intuitif et évolutif.

La plateforme est approuvée par des organisations de premier plan comme Alignment Lab AI et NousResearch, permettant aux équipes de dépasser les simples recherches par mots-clés et d'acquérir une compréhension conceptuelle approfondie de leurs données. Avec son moteur de calcul ultra-rapide, Lilac peut traiter des ensembles de données massifs à une vitesse remarquable, comme le regroupement d'un million de points de données en seulement 20 minutes ou l'intégration de données à un rythme d'un demi-milliard de jetons par minute. Cette performance en fait un composant essentiel de tout pipeline sérieux d'évaluation de la qualité des données.

Comment utiliser Lilac

Démarrer avec Lilac est simple, surtout pour ceux qui sont familiers avec l'écosystème Python. La principale méthode d'utilisation implique une installation locale et une interface utilisateur basée sur le web pour l'exploration.

  1. Installation : Commencez par installer la bibliothèque Lilac à l'aide de pip, l'installateur de paquets Python. Ouvrez votre terminal ou votre invite de commande et exécutez la commande : pip install lilac.
  2. Lancer Lilac : Après l'installation, vous pouvez démarrer le serveur Lilac depuis votre terminal. Cela se fait généralement en exécutant une commande comme lilac start [path_to_your_project_dir]. Cette commande traitera vos ensembles de données et lancera un serveur web local.
  3. Charger les données : Indiquez à Lilac votre ensemble de données. Il peut gérer divers formats et sources de données, vous permettant d'importer des données à partir de fichiers locaux (CSV, JSON, etc.) ou directement depuis des hubs comme Hugging Face.
  4. Explorer et Analyser : Une fois le serveur en cours d'exécution, ouvrez l'URL fournie dans votre navigateur web pour accéder à l'interface utilisateur de Lilac. Ici, vous pouvez utiliser ses puissantes fonctionnalités pour explorer vos données. Effectuez des recherches sémantiques, visualisez des clusters de données et analysez des signaux comme les PII ou la langue.
  5. Curer et Éditer : Utilisez l'interface pour étiqueter, filtrer et même éditer directement des points de données. Vous pouvez créer de nouvelles étiquettes, supprimer des doublons ou nettoyer des entrées bruitées.
  6. Exporter et Utiliser : Après avoir curé votre ensemble de données, vous pouvez exporter la version améliorée ou les informations générées (par exemple, une liste d'ID à supprimer) pour les utiliser dans votre pipeline d'entraînement de modèle.

Fonctionnalités principales de Lilac

  • Recherche Sémantique et par Mots-clés : Allez au-delà de la simple correspondance de texte. Lilac vous permet de rechercher dans votre ensemble de données en utilisant des requêtes en langage naturel pour trouver des entrées conceptuellement similaires, en plus de la recherche traditionnelle par mots-clés.
  • Regroupement Automatique des Données : Lilac regroupe automatiquement les points de données similaires et attribue des titres à ces clusters, vous donnant un aperçu instantané de haut niveau des sujets et des thèmes présents dans vos données.
  • Recherche de Concepts Flous : Recherchez des concepts abstraits ou nuancés difficiles à définir avec des mots-clés spécifiques, permettant un découpage et une exploration des données plus sophistiqués.
  • Signaux de Qualité des Données Intégrés : La plateforme est livrée avec des signaux pré-construits pour détecter automatiquement les Informations d'Identification Personnelle (PII), les quasi-doublons, la complexité du texte et la langue du texte.
  • Création de Signaux Personnalisés : Les utilisateurs peuvent étendre les capacités de Lilac en définissant et en exécutant leurs propres signaux et transformations personnalisés sur leurs ensembles de données, adaptant l'analyse à leurs besoins spécifiques.
  • Édition et Comparaison des Données : Éditez directement les champs de données dans l'interface utilisateur et comparez différents champs ou versions de votre ensemble de données côte à côte pour comprendre l'impact de vos modifications.
  • Moteur Haute Performance : Conçu pour la vitesse et l'échelle, Lilac peut gérer des ensembles de données contenant des milliards de jetons, rendant la curation de données à grande échelle réalisable.

Cas d'utilisation pour Lilac

Lilac est un outil polyvalent applicable tout au long du cycle de vie du développement de l'IA :

  • Curation des Données de Pré-entraînement : Analysez et nettoyez des ensembles de données massifs à l'échelle du web pour supprimer le contenu de faible qualité, les doublons et les PII avant de pré-entraîner un modèle de fondation.
  • Amélioration des Ensembles de Données d'Ajustement Fin : Pour des tâches comme l'ajustement fin d'instructions, utilisez Lilac pour analyser la qualité des paires instruction-réponse, identifier les biais et assurer la diversité des données.
  • Évaluation et Débogage de Modèles : Découvrez et analysez des tranches de données spécifiques où votre modèle performe mal. En regroupant et en examinant les cas d'échec, vous pouvez comprendre les faiblesses du modèle et les cibler avec de meilleures données.
  • Exploration et Compréhension des Données : Obtenez rapidement une idée qualitative de tout nouvel ensemble de données textuelles. Comprenez sa composition, identifiez les sujets principaux et repérez les problèmes potentiels avant d'écrire le moindre code.
  • Modération de Contenu et Sécurité : Utilisez la recherche sémantique et des signaux personnalisés pour identifier et étiqueter efficacement le contenu toxique, nuisible ou autrement sensible au sein d'un ensemble de données.

Avantages de Lilac

Lilac offre des avantages significatifs pour les équipes travaillant avec des LLM :

  • Amélioration des Performances du Modèle : En améliorant systématiquement la qualité des données, Lilac vous aide à construire des modèles d'IA plus précis, fiables et moins biaisés.
  • Flux de Travail de Développement Accéléré : Il réduit considérablement le temps et l'effort manuel requis pour l'exploration et le nettoyage des données, permettant aux équipes d'itérer plus rapidement.
  • Démocratisation des Connaissances sur les Données : L'interface utilisateur intuitive rend l'analyse approfondie des ensembles de données accessible à tous les membres de l'équipe, y compris les chefs de produit et les experts du domaine, et pas seulement aux ingénieurs ML.
  • Open Source et Extensible : Le fait d'être gratuit et open-source favorise la transparence, la collaboration communautaire et permet une personnalisation complète pour s'adapter aux exigences uniques du projet.
  • Évolutivité pour les Données du Monde Réel : Son architecture efficace garantit que vous pouvez appliquer les mêmes processus rigoureux de qualité des données à des ensembles de données de petite et de grande taille à l'échelle de la production.

Tarification et plans

Lilac est un projet open-source, ce qui rend sa bibliothèque principale et son interface utilisateur entièrement gratuites. Vous pouvez l'installer et l'exécuter sur votre machine locale ou votre infrastructure privée sans aucun coût. Le projet est soutenu par sa communauté et ses contributeurs. Bien que l'outil de base soit gratuit, il pourrait y avoir de futures offres de niveau entreprise, telles que le "Lilac Garden" mentionné, qui pourraient fournir des services cloud gérés, un support dédié ou des fonctionnalités avancées pour un usage commercial. Cependant, pour les développeurs individuels, les chercheurs et la plupart des équipes, la version open-source offre une fonctionnalité complète.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
Gestion des Données
Uniquement Elementary Data
ObservabilitéAnalyse
Uniquement Lilac
Entraînement de modèleAnalyse de données

Étiquettes

Commun
qualité des données
Uniquement Elementary Data
Agent IAIngénierie analytiquedétection d'anomaliesCatalogue de donnéesTraçabilité des donnéesSurveillance des donnéesObservabilité des donnéesdbt
Uniquement Lilac
analyse de donnéesNettoyage de donnéesexploration de donnéesJeu de donnéesOutils pour développeursGrand modèle linguistiqueapprentissage automatiqueOpen sourceRecherche sémantique

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement Elementary Data
Aucune donnée vérifiée
Uniquement Lilac
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Elementary Data monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
16K
Durée moyenne
0:21
Pages par visite
1.54
Taux de rebond
47.25%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: Non vérifié
  • 2025-09: 18.7K
  • 2026-01: 17K
  • 2026-02: 16.9K
  • 2026-03: 18.3K
  • 2026-04: 12.1K
  • 2026-05: 16K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States48.18%7.7K
🇩🇪Germany25.01%4K
🇧🇷Brazil11.23%1.8K
🇮🇳India8.01%1.3K
🇫🇷France7.57%1.2K

Mots-clés

dbt test accepted valuesdbt tests relationshipelementary dataelementary performance alertsnowflake summit

Lilac monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
16.7K
Durée moyenne
1:00
Pages par visite
1.12
Taux de rebond
80.5%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: 682
  • 2025-09: 504
  • 2026-01: Non vérifié
  • 2026-02: 693
  • 2026-03: 0
  • 2026-04: 709
  • 2026-05: 16.7K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States100%16.7K

Mots-clés

lilac data managementsportwetten ohne lugas

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

Elementary Data

Note
Non vérifié
Commentaires
0
Favoris
153
J’aime
162

Lilac

Note
Non vérifié
Commentaires
0
Favoris
170
J’aime
175

Elementary Data vs Lilac · FAQ comparative

What do Elementary Data and Lilac have in common?
Both tools are listed under Gestion des Données. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Elementary Data and Lilac free?
Listed pricing models: Elementary Data — Freemium; Lilac — Free. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Elementary Data and Lilac?
The primary listed category is Observabilité for Elementary Data, and Entraînement de modèle for Lilac. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés