ToolMage
Connexion

AI TOOL COMPARISON

Flower vs PyBrain

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

Flower Aperçu du produit

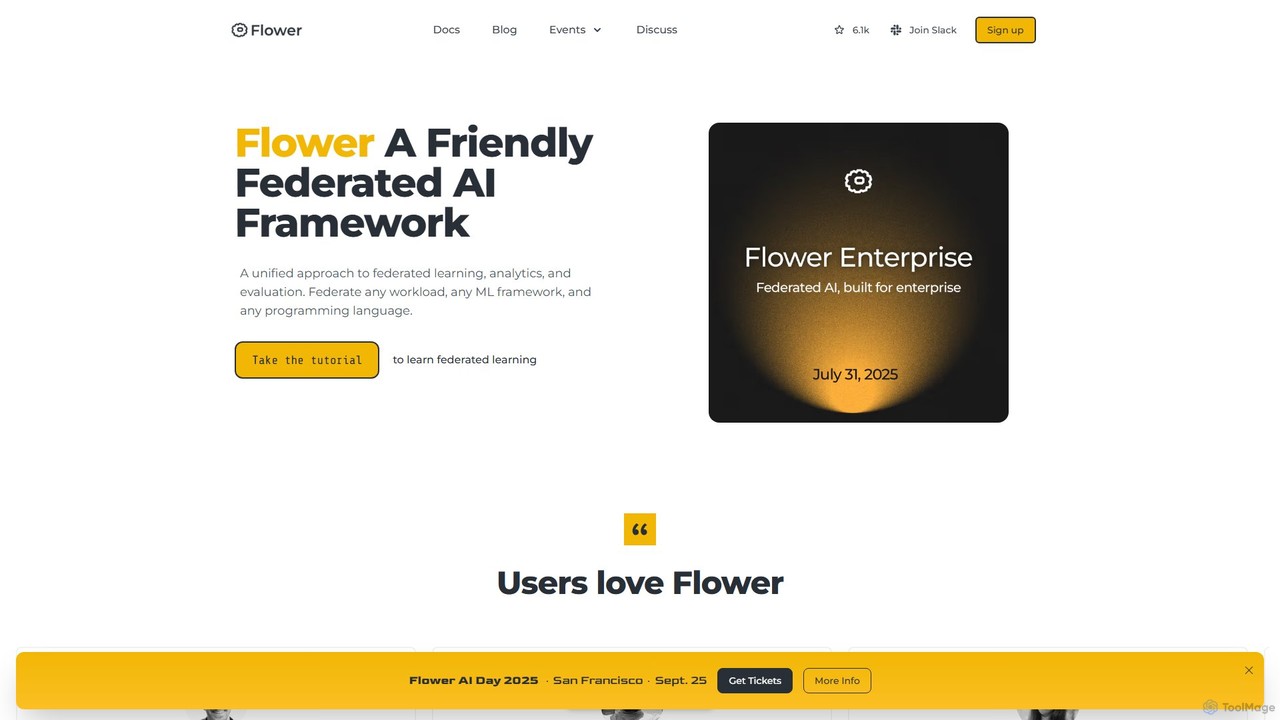
Flower est un framework open-source convivial pour l'apprentissage fédéré, l'analyse et l'évaluation. Il permet d'entraîner des modèles d'IA sur des données décentralisées sur divers appareils et plateformes sans compromettre la confidentialité, en prenant en charge de nombreux frameworks de ML comme PyTorch, TensorFlow et Hugging Face.

Preview

PyBrain Aperçu du produit

PyBrain est une bibliothèque d'apprentissage automatique open-source, modulaire et flexible pour Python. Elle fournit des algorithmes puissants et faciles à utiliser pour les tâches d'apprentissage automatique, avec un accent particulier sur les réseaux de neurones, l'apprentissage par renforcement et l'apprentissage non supervisé. Elle est conçue pour être accessible aux débutants tout en restant assez puissante pour la recherche.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Flower VS PyBrain — Données clés
Données clésFlowerPyBrain
Pricing modelFreeFree
Product typeWebWeb
Primary focusFrameworksBibliothèques et Frameworks
Publics et métiersNon vérifiéNon vérifié
CatégoriesFrameworks · Apprentissage automatique · IA DécentraliséeBibliothèques et Frameworks · Apprentissage automatique · Recherche
Added2 août 202514 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Flower

Flower est un framework open-source complet conçu pour unifier l'apprentissage fédéré, l'analyse fédérée et l'évaluation fédérée. Il répond aux défis croissants de la confidentialité, de la réglementation des données (comme le RGPD et le CCPA) et du volume de données dans l'apprentissage automatique moderne. Au lieu de l'approche traditionnelle consistant à centraliser les données pour l'entraînement, Flower prône une méthode décentralisée : il déplace le calcul (l'entraînement du modèle) là où se trouvent les données. Cette approche de « privacy-by-design » permet aux organisations et aux développeurs de construire de puissants modèles d'IA en collaborant sur des ensembles de données sensibles et distribués sans jamais exposer les données brutes.

Conçu pour l'évolutivité et la facilité d'utilisation, Flower est destiné à être accessible tant aux chercheurs qu'aux ingénieurs de production. Il permet une transition en douceur d'un prototype de recherche à un système de production à grande échelle avec un minimum de frais d'ingénierie. Le framework est approuvé et utilisé par des organisations de premier plan comme Mozilla, et salué par les chercheurs pour son efficacité et sa simplicité.

Comment utiliser Flower

Démarrer avec Flower est simple, surtout pour les développeurs familiers avec Python et les bibliothèques de machine learning populaires. Le processus peut être décomposé en quelques étapes simples :

  1. Installation : Installez la bibliothèque Flower en utilisant pip. Pour une configuration de simulation typique, la commande est : pip install flwr[simulation].
  2. Créer une application Flower : Flower fournit un outil en ligne de commande pour créer rapidement un nouveau projet. Il suffit d'exécuter flwr new et de suivre les instructions interactives pour sélectionner votre framework de ML préféré (par exemple, TensorFlow, PyTorch).
  3. Implémenter la logique client et serveur : Vous définirez le comportement de vos clients (qui détiennent les données et effectuent l'entraînement local) et du serveur (qui orchestre le processus d'apprentissage fédéré et agrège les mises à jour du modèle). Cela se fait en Python, et Flower fournit des abstractions claires pour intégrer votre code d'entraînement de modèle existant. Un système de base peut être mis en place avec seulement 20 lignes de code.
  4. Exécuter l'application fédérée : Une fois que votre logique client et serveur est définie, vous pouvez démarrer le processus d'apprentissage fédéré avec une seule commande : flwr run ..

Flower offre une documentation complète, y compris des guides de démarrage rapide et des tutoriels pour un large éventail de frameworks tels que PyTorch, TensorFlow, Hugging Face, JAX, scikit-learn et XGBoost, ce qui facilite la fédération de projets existants.

Fonctionnalités principales de Flower

  • Indépendant du framework de ML : S'intègre de manière transparente avec pratiquement n'importe quel framework de machine learning, y compris PyTorch, TensorFlow, Keras, JAX, scikit-learn, XGBoost, et plus encore. Vous pouvez utiliser vos outils préférés sans être enfermé dans un écosystème spécifique.
  • Approche unifiée : Fournit un cadre unique et cohérent pour l'apprentissage fédéré, l'évaluation fédérée (pour évaluer les performances du modèle sur des données décentralisées) et l'analyse fédérée (pour tirer des enseignements de données distribuées).
  • Évolutivité extrême : Conçu pour gérer des scénarios du monde réel avec un nombre massif de clients. Il a été utilisé avec succès dans des simulations avec des dizaines de millions de clients.
  • Indépendant de la plateforme : Fonctionne sur une grande variété de matériel et de systèmes d'exploitation. Il est compatible avec les principaux fournisseurs de cloud (AWS, GCP, Azure) et les appareils en périphérie (edge), y compris Android, iOS, Raspberry Pi et NVIDIA Jetson.
  • De la recherche à la production : Facilite un pipeline fluide de la recherche et de l'expérimentation initiales à des déploiements robustes et prêts pour la production.
  • Technologies améliorant la confidentialité : Prend en charge des techniques de confidentialité avancées comme la Confidentialité Différentielle (DP) et l'Agrégation Sécurisée (SecAgg+) pour fournir des garanties de confidentialité quantifiables et protéger les mises à jour du modèle.
  • SDK étendus : Bien qu'il s'agisse principalement d'un framework Python, Flower s'étend avec des SDK pour Android (Java/Kotlin), iOS (Swift) et C++ (à venir) pour permettre l'entraînement natif sur l'appareil.

Cas d'utilisation pour Flower

La nature de Flower, qui préserve la confidentialité, ouvre la voie à des applications d'IA dans de nombreux domaines sensibles :

  • Santé : Les hôpitaux peuvent entraîner collaborativement un modèle de détection du cancer sur leurs données de patients respectives sans partager de dossiers médicaux sensibles.
  • Finance : Les institutions financières peuvent construire un modèle partagé de détection de la fraude en s'entraînant sur leurs données de transactions privées, améliorant la précision sans violer la vie privée des clients.
  • Automobile et IoT : Les constructeurs automobiles peuvent améliorer les prévisions d'autonomie des véhicules électriques en utilisant l'apprentissage fédéré sur les données de localisation et de conduite de milliers de véhicules, tout en gardant les données des utilisateurs sur l'appareil.
  • Mobile et IA sur l'appareil : Les développeurs peuvent entraîner des modèles d'autocomplétion de clavier plus intelligents en utilisant la saisie de texte des téléphones des utilisateurs, sans que le texte ne quitte jamais l'appareil.
  • Grands modèles de langage (LLM) : Flower permet l'ajustement fin fédéré de LLM (par exemple, en utilisant FlowerTune LLM) sur des ensembles de données privés et spécifiques à un domaine pour créer des modèles spécialisés sans centraliser d'informations sensibles.
  • Robotique : Entraîner des modèles de contrôle robotique sur une flotte de robots, en apprenant de leurs expériences individuelles dans différents environnements.

Avantages de Flower

Le principal avantage de Flower est sa capacité à permettre l'apprentissage automatique dans des scénarios où cela était auparavant impossible en raison de contraintes de confidentialité, légales ou logistiques. Il démocratise l'accès à l'IA collaborative en fournissant un outil ouvert, flexible et puissant. Sa conception indépendante du framework garantit que les développeurs peuvent tirer parti de leurs compétences et de leurs bases de code existantes. La forte communauté sur Slack et GitHub offre un excellent soutien, et la documentation complète ainsi que les exemples abaissent la barrière à l'entrée pour l'apprentissage fédéré.

Tarification et plans

Flower est un projet open-source sous licence Apache 2.0. Il est entièrement gratuit pour un usage académique et commercial. Le développement est soutenu par une communauté dynamique de contributeurs et de partenaires commerciaux.

PyBrain

PyBrain (Python-Based Reinforcement Learning, Artificial Intelligence, and Neural Network Library) est une bibliothèque open-source polyvalente et puissante pour l'apprentissage automatique en Python. Bien qu'il s'agisse d'une bibliothèque plus ancienne par rapport aux frameworks modernes comme TensorFlow ou PyTorch, elle reste un outil précieux à des fins éducatives et pour les chercheurs qui ont besoin d'un environnement simple, transparent et flexible pour prototyper des algorithmes, en particulier dans les domaines des réseaux de neurones et de l'apprentissage par renforcement.

La philosophie centrale de PyBrain est la modularité. Elle permet aux utilisateurs de construire des architectures de réseaux de neurones complexes et des scénarios d'entraînement en connectant des composants simples et réutilisables. Cela en fait un excellent outil pour apprendre les concepts fondamentaux de l'apprentissage automatique, car les utilisateurs peuvent voir comment les différentes parties (jeux de données, réseaux, entraîneurs) interagissent. Elle prend en charge une large gamme de types de réseaux, y compris les réseaux à propagation avant, les réseaux récurrents et même les réseaux à mémoire longue et à court terme (LSTM), qui étaient une caractéristique importante au moment de son développement.

Comment utiliser PyBrain

L'utilisation de PyBrain est simple pour toute personne familière avec Python. Le flux de travail typique comprend ces étapes :

  1. Installation : PyBrain peut être facilement installé à l'aide de pip : pip install pybrain.
  2. Importer les modules : Importez les composants nécessaires de la bibliothèque, tels que buildNetwork pour créer des réseaux, SupervisedDataSet pour les données et BackpropTrainer pour l'entraînement.
  3. Définir l'architecture du réseau : Créez un réseau de neurones. Vous pouvez utiliser le raccourci buildNetwork pour les réseaux à propagation avant standard ou construire manuellement des architectures personnalisées plus complexes, y compris des connexions récurrentes.
  4. Créer un jeu de données : Structurez vos données dans un format compatible avec PyBrain. Pour l'apprentissage supervisé, il s'agit généralement du SupervisedDataSet, qui contient des paires d'entrées et de cibles.
  5. Initialiser un entraîneur : Choisissez un algorithme d'entraînement, tel que la rétropropagation, et créez une instance d'entraîneur. L'entraîneur connecte le réseau, le jeu de données et l'algorithme d'apprentissage.
  6. Entraîner le modèle : Appelez la méthode train() ou trainUntilConvergence() de l'entraîneur pour démarrer le processus d'apprentissage. L'entraîneur ajustera de manière itérative les poids du réseau pour minimiser l'erreur sur le jeu de données.
  7. Activer et tester : Une fois entraîné, utilisez la méthode activate() du réseau pour faire des prédictions sur de nouvelles données non vues.

Fonctionnalités principales de PyBrain

  • Réseaux de neurones : Prise en charge complète de divers types de réseaux, y compris les réseaux à propagation avant (FFN), les réseaux de neurones récurrents (RNN) et la mémoire longue et à court terme (LSTM).
  • Algorithmes d'apprentissage : Implémente une variété de paradigmes d'apprentissage, y compris supervisé, non supervisé et par renforcement. Cela inclut des algorithmes comme la rétropropagation, le Q-learning et le SARSA.
  • Modularité et flexibilité : Les réseaux, les jeux de données, les entraîneurs et les expériences sont tous des objets distincts, ce qui permet une grande flexibilité dans la conception et le test de modèles et de scénarios d'apprentissage personnalisés.
  • Natif en Python : Écrit purement en Python, ce qui le rend facile à lire, à comprendre et à étendre sans avoir besoin de compiler du code externe.
  • Focalisation éducative : Sa structure claire et explicite en fait un excellent outil pour enseigner et apprendre les principes sous-jacents des réseaux de neurones et de l'apprentissage automatique.

Cas d'utilisation pour PyBrain

PyBrain est bien adapté à une gamme d'applications, en particulier dans des contextes académiques et de prototypage :

  • Recherche académique : Les chercheurs peuvent rapidement mettre en œuvre et tester de nouvelles architectures de réseau ou des variations d'algorithmes d'apprentissage.
  • Outil pédagogique : Il est largement utilisé dans les cours universitaires et par les particuliers pour apprendre les bases des réseaux de neurones, de la rétropropagation et de l'apprentissage par renforcement.
  • Prototypage de modèles simples : Les développeurs peuvent l'utiliser pour construire et valider des modèles simples pour des tâches telles que la prédiction de séries temporelles, la classification et la régression avant de passer à des frameworks de production plus complexes.
  • Expériences d'apprentissage par renforcement : Son support intégré pour les agents, les environnements et les algorithmes de RL le rend idéal pour expérimenter des tâches comme l'équilibrage de poteau, les labyrinthes simples ou d'autres problèmes de contrôle classiques.

Avantages de PyBrain

Malgré l'émergence de frameworks plus récents, PyBrain conserve plusieurs avantages clés :

  • Simplicité et intuitivité : L'API est simple et facile à comprendre, ce qui abaisse la barrière à l'entrée pour les débutants en apprentissage automatique.
  • Transparence : En tant que bibliothèque purement Python, le code source est très lisible, permettant aux utilisateurs de se plonger dans les détails d'implémentation des algorithmes.
  • Open Source : Il est entièrement gratuit à utiliser, modifier et distribuer, favorisant un environnement collaboratif et ouvert pour l'apprentissage et la recherche.
  • Léger : Il a des dépendances minimales et est moins gourmand en ressources que les frameworks plus grands, ce qui le rend adapté aux projets à plus petite échelle et aux environnements d'apprentissage.

Tarification et plans

PyBrain est un projet open-source distribué sous la licence BSD. Il est entièrement gratuit pour un usage académique, personnel et commercial. Il n'y a pas de plans tarifaires, d'abonnements ou de coûts cachés. Le développement et la maintenance sont assurés par les contributions de la communauté.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
Apprentissage automatique
Uniquement Flower
FrameworksIA Décentralisée
Uniquement PyBrain
Bibliothèques et FrameworksRecherche

Étiquettes

Commun
science des donnéesapprentissage automatiqueOpen sourcePython
Uniquement Flower
Cadre d'IAIA décentraliséeApprentissage fédéréConfidentialitéPyTorchTensorFlow
Uniquement PyBrain
Apprentissage profondéducationBibliothèqueréseau neuronalapprentissage par renforcement

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement Flower
Aucune donnée vérifiée
Uniquement PyBrain
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Flower monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
78.9K
Durée moyenne
1:20
Pages par visite
2.3
Taux de rebond
38.15%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 100.9K
  • 2026-01: 78.6K
  • 2026-02: 69.2K
  • 2026-03: 69.7K
  • 2026-04: 68.3K
  • 2026-05: 78.9K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇧🇷Brazil37.03%29.2K
🇺🇸United States20.99%16.6K
🇮🇳India17.3%13.7K
🇩🇪Germany13.13%10.4K
🇵🇱Poland11.55%9.1K

Sources de trafic

Source typePercentageEstimated visits
Direct79.68%62.9K
Référence18.58%14.7K
E-mail1.74%1.4K

Mots-clés

flowerflower aiflower federated learningprometheus flower federated learningstrategy stasrty method flower return

PyBrain

Non vérifié

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

Flower

Note
Non vérifié
Commentaires
0
Favoris
167
J’aime
164

PyBrain

Note
Non vérifié
Commentaires
0
Favoris
164
J’aime
163

Flower vs PyBrain · FAQ comparative

What do Flower and PyBrain have in common?
Both tools are listed under Apprentissage automatique. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Flower and PyBrain free?
Listed pricing models: Flower — Free; PyBrain — Free. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Flower and PyBrain?
The primary listed category is Frameworks for Flower, and Bibliothèques et Frameworks for PyBrain. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés