ToolMage
Connexion

AI TOOL COMPARISON

fullstackdeeplearning vs Ludwig

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

fullstackdeeplearning Aperçu du produit

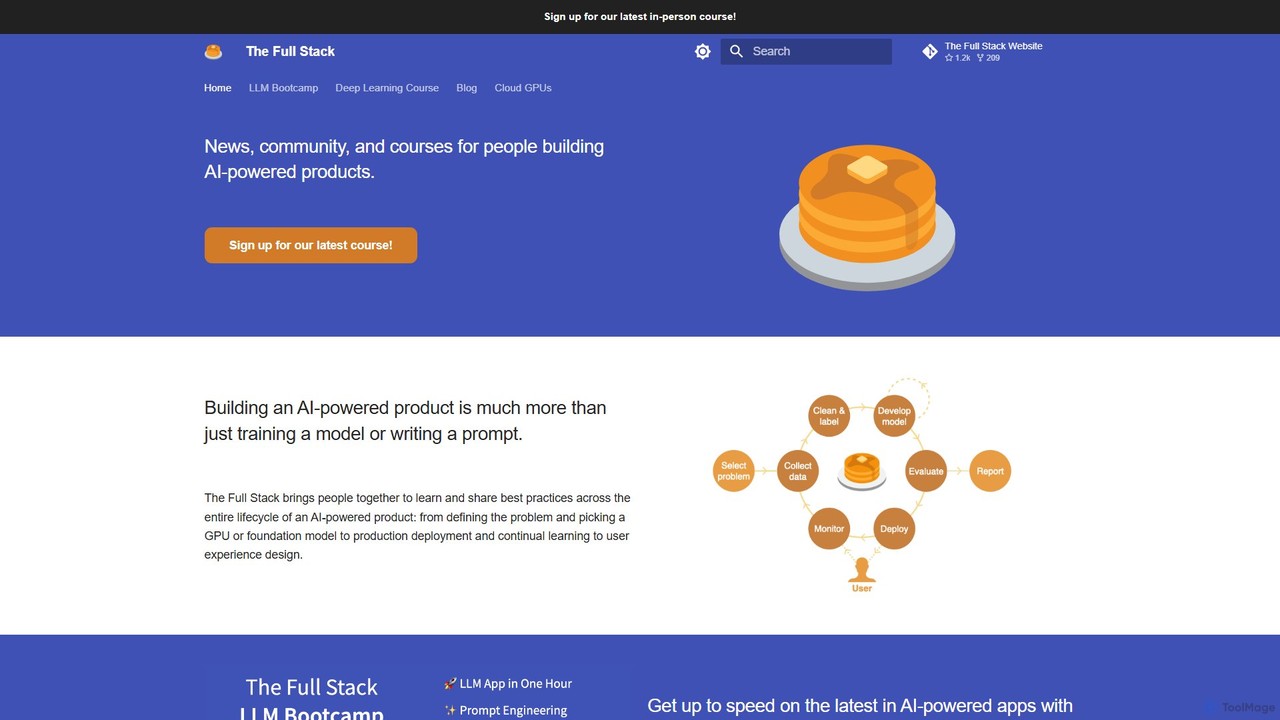
Une plateforme éducative offrant des cours, une communauté et des ressources pour les professionnels qui créent des produits d'IA concrets. Elle couvre l'ensemble du cycle de vie du développement, de la formation des modèles et du MLOps au déploiement et à la conception de l'expérience utilisateur.

Preview

Ludwig Aperçu du produit

Ludwig est un framework de deep learning open-source et low-code qui simplifie la création et l'entraînement de modèles d'IA personnalisés. En utilisant des configurations déclaratives YAML, les utilisateurs peuvent facilement créer des modèles complexes, y compris des LLM, pour l'apprentissage multimodal et multi-tâches sans code répétitif. Il est conçu pour la scalabilité, la mise en production et s'intègre avec des outils populaires comme HuggingFace et MLFlow.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

fullstackdeeplearning VS Ludwig — Données clés
Données clésfullstackdeeplearningLudwig
Pricing modelPaidFree
Product typeWebWeb
Primary focusCommunauté TechEntraînement de modèle
Publics et métiersNon vérifiéNon vérifié
CatégoriesCommunauté Tech · Apprentissage automatique · ProgrammationEntraînement de modèle · Apprentissage automatique · Low-Code No-Code
Added16 août 20257 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

fullstackdeeplearning

fullstackdeeplearning est une plateforme éducative et une communauté complète conçue pour les ingénieurs, les chercheurs et les entrepreneurs qui développent des produits basés sur l'intelligence artificielle. Elle se distingue en se concentrant sur l'ensemble du 'full stack' du développement de l'apprentissage automatique, allant au-delà de la simple formation de modèles pour englober le cycle de vie complet d'un produit d'IA. Cela inclut la définition du problème, la gestion des données, le développement de modèles, le déploiement en production, la surveillance et la conception de l'expérience utilisateur.

La plateforme propose une gamme de contenus de haute qualité, notamment des cours approfondis, des laboratoires pratiques et des articles de blog pertinents. Elle vise à combler le fossé entre les connaissances théoriques et l'application pratique, en dotant les apprenants des meilleures pratiques et des outils nécessaires pour réussir dans l'industrie de l'IA en évolution rapide.

Comment utiliser fullstackdeeplearning

L'utilisation de fullstackdeeplearning implique plusieurs activités clés :

  1. S'inscrire aux cours : Inscrivez-vous à leurs cours phares, tels que le 'Bootcamp sur les grands modèles de langage' ou le 'Cours de Deep Learning'. Ces cours sont structurés pour vous faire passer des concepts fondamentaux au développement d'applications avancées.
  2. Participer aux laboratoires : Travaillez sur des laboratoires pratiques qui vous guident dans la construction d'une application d'IA complète à partir de zéro, comme un reconnaisseur de texte. Ces laboratoires sont conçus pour être accessibles, offrant une configuration en un clic sur Google Colab avec un accès GPU gratuit, ou peuvent être exécutés sur une machine Linux locale.
  3. Lire le blog : Restez à jour sur les dernières tendances et les analyses techniques approfondies en lisant le blog officiel. Il contient des articles rédigés par des experts sur des sujets tels que les nouvelles architectures de modèles (par exemple, RWKV) et le déploiement de modèles à grande échelle.
  4. Rejoindre la communauté : Connectez-vous à une communauté mondiale de pairs, d'instructeurs et d'experts de l'industrie via leur serveur Discord et d'autres canaux sociaux. C'est un espace pour poser des questions, partager des projets et réseauter.
  5. Construire un projet : Appliquez vos compétences en créant un projet final. La plateforme met en valeur des projets d'étudiants exceptionnels, offrant une source d'inspiration et une référence de qualité.

Fonctionnalités principales de fullstackdeeplearning

  • Curriculum de bout en bout : Couvre l'ensemble du cycle de vie du développement de produits d'IA, de l'idéation et de la collecte de données au déploiement, au MLOps et à l'UX.
  • Laboratoires pratiques et concrets : Des laboratoires étape par étape pour construire des applications réelles, avec une configuration facile sur Google Colab.
  • Cours dirigés par des experts : Des cours approfondis sur des sujets de pointe comme le Deep Learning et les grands modèles de langage (LLM).
  • Accent sur les meilleures pratiques : Enseigne les outils et les meilleures pratiques de l'industrie pour construire des systèmes d'IA robustes, évolutifs et maintenables.
  • Communauté dynamique : Accès à un réseau de professionnels et de passionnés de l'IA pour la collaboration et le soutien.
  • Apprentissage par projet : Encourage les étudiants à construire et à présenter leurs propres produits basés sur l'IA.
  • Blog technique : Fournit des articles approfondis sur des sujets avancés de ML et des défis d'ingénierie.

Cas d'utilisation pour fullstackdeeplearning

Les compétences et les connaissances acquises sur la plateforme peuvent être appliquées à un large éventail de projets concrets, comme le montrent les vitrines de leurs étudiants :

  • Vision par ordinateur : Développer des systèmes pour la détection du cancer du sein, la surveillance de la déforestation à partir d'images satellite et le coaching de la posture assise en temps réel.
  • Traitement du langage naturel (NLP) : Construire des outils comme un surligneur YouTube pour les créateurs ou déployer de grands modèles de langage comme GLM-130B.
  • IA créative : Créer un jeu de données de planches de manga artificielles.
  • Surveillance en temps réel : Concevoir un avertisseur en temps réel pour ceux qui se rongent les ongles.
  • Recherche scientifique : Classifier les protéines humaines à partir d'images de cellules uniques ou construire un classificateur de chants d'oiseaux.

Avantages de fullstackdeeplearning

Le principal avantage de fullstackdeeplearning est son approche holistique et pratique. Contrairement aux cours purement académiques, il met l'accent sur les défis d'ingénierie pour faire fonctionner l'IA dans le monde réel. L'accent mis sur le MLOps, le déploiement et l'agilité prépare les apprenants aux exigences réelles d'un rôle d'ingénieur IA/ML. L'utilisation d'outils accessibles comme Google Colab abaisse la barrière à l'entrée, tandis que la forte communauté fournit un système de soutien inestimable pour l'apprentissage continu et la croissance professionnelle.

Tarification et plans

fullstackdeeplearning fonctionne sur un modèle payant pour ses cours complets, tels que le Bootcamp LLM et le Cours de Deep Learning. Bien que les prix spécifiques puissent varier par cours et par cohorte, il s'agit d'offres éducatives de premier ordre. La plateforme fournit également des ressources gratuites, notamment son blog technique et l'accès à la communauté. Pour obtenir les tarifs et les détails d'inscription les plus récents, les étudiants potentiels doivent visiter le site web officiel.

Ludwig

Ludwig est un puissant framework de deep learning déclaratif et open-source qui permet aux utilisateurs de construire, d'entraîner et de déployer des modèles d'IA de pointe avec un minimum de codage. Hébergé par la Linux Foundation AI & Data, Ludwig permet aux chercheurs et aux praticiens de créer des modèles personnalisés pour un large éventail de tâches en définissant simplement l'architecture du modèle et les paramètres d'entraînement dans un fichier de configuration YAML simple. Cette approche abstrait le code d'ingénierie complexe et répétitif, permettant aux utilisateurs de se concentrer sur les données et la conception du modèle.

Le framework est construit sur le principe de la modularité et de l'extensibilité, traitant les composants de deep learning comme des blocs de construction. Cela permet de construire facilement des modèles sophistiqués capables de gérer simultanément plusieurs modalités de données, telles que le texte, les images, l'audio et les données tabulaires, au sein d'une seule architecture unifiée. Ludwig est particulièrement puissant pour l'ajustement fin de grands modèles de langage (LLM) et prend en charge des techniques avancées comme le Fine-Tuning Efficace en Paramètres (PEFT) et la quantification sur 4 bits (QLoRA) pour rendre l'entraînement de grands modèles plus accessible et efficace.

Comment utiliser Ludwig

L'utilisation de Ludwig implique un flux de travail simple, piloté par la ligne de commande, qui rationalise l'ensemble du cycle de vie de l'apprentissage automatique :

  1. Installation : Commencez par installer Ludwig en utilisant pip. Une installation complète avec toutes les dépendances est également disponible.
    pip install ludwig
    pip install ludwig[full]
  2. Préparation des données : Préparez votre jeu de données dans un format structuré comme CSV, Parquet ou JSON. Ludwig déduit automatiquement les types de données mais permet des définitions explicites.
  3. Configuration : Créez un fichier de configuration YAML (par exemple, model.yaml). Dans ce fichier, vous déclarez vos caractéristiques d'entrée (par exemple, texte, catégorie, nombre) et de sortie (la cible que vous voulez prédire). Vous spécifiez également l'architecture du modèle, les paramètres d'entraînement et toutes les étapes de prétraitement.
  4. Entraînement : Lancez le processus d'entraînement avec une seule commande, en pointant vers votre fichier de configuration et votre jeu de données. Ludwig gère l'ensemble de la boucle d'entraînement, y compris le prétraitement des données, la construction du modèle, l'entraînement et l'évaluation.
    ludwig train --config model.yaml --dataset /path/to/your/data.csv
  5. Prédiction & Déploiement : Une fois entraîné, vous pouvez utiliser le modèle pour des prédictions sur de nouvelles données ou le déployer en tant qu'API REST pour une utilisation en production avec des commandes simples.
    ludwig serve --model_path /path/to/model

Fonctionnalités principales de Ludwig

  • Configuration Déclarative YAML : Construisez des modèles en les définissant dans un fichier YAML simple et lisible par l'homme, éliminant le besoin de code Python extensif.
  • Apprentissage Multimodal & Multi-tâches : Combinez de manière transparente différents types de données (texte, images, audio, tabulaire) en entrée et entraînez des modèles à prédire plusieurs sorties simultanément.
  • Ajustement Fin Avancé de LLM : Prend en charge nativement l'ajustement fin de grands modèles de langage avec des techniques comme LoRA et QLoRA pour un entraînement efficace sur du matériel grand public.
  • Capacités AutoML : Fournit une fonctionnalité AutoML qui trouve automatiquement le meilleur modèle pour vos données avec un budget de temps donné, simplifiant le processus de sélection de modèle.
  • Entraînement Scalable : Conçu pour l'échelle avec un support intégré pour l'entraînement distribué (DDP, DeepSpeed) et les jeux de données plus grands que la mémoire.
  • Prêt pour la Production : Exportez facilement les modèles vers des formats de production comme Torchscript et Triton, et déployez avec les intégrations Docker et Kubernetes.
  • Intégrations Riches : Se connecte à des outils MLOps populaires comme TensorBoard, Weights & Biases, MLFlow et Comet ML pour le suivi et la visualisation des expériences.
  • Architecture Extensible : Offre un contrôle de niveau expert pour personnaliser chaque aspect du modèle, des encodeurs et décodeurs aux fonctions d'activation et boucles d'entraînement.

Cas d'utilisation pour Ludwig

La polyvalence de Ludwig le rend adapté à un large éventail d'applications dans différents domaines :

  • Traitement du Langage Naturel : Analyse des sentiments, classification de texte, reconnaissance d'entités nommées (NER), traduction automatique et construction de systèmes de dialogue de chatbot.
  • Vision par Ordinateur : Classification d'images et réponse à des questions visuelles.
  • Données Tabulaires : Détection de fraude, prédiction de l'attrition des clients, prévision des ventes et évaluation du risque de crédit.
  • Analyse de Séries Temporelles : Prévision météorologique, prévision des cours de la bourse et planification de la demande.
  • Applications Multimodales : Combinaison de données d'image et de texte pour prédire les évaluations de produits, ou analyse de l'audio et des métadonnées pour la vérification du locuteur.

Avantages de Ludwig

Ludwig offre des avantages significatifs pour les individus et les équipes travaillant avec l'IA :

  • Réduction du Code Répétitif : Libère les développeurs et les chercheurs de l'écriture de code d'ingénierie répétitif pour le prétraitement des données, les boucles d'entraînement et le calcul distribué.
  • Prototypage Rapide et Benchmarking : Itérez rapidement sur différentes architectures de modèles et comparez leurs performances en apportant de simples modifications au fichier de configuration.
  • Démocratisation de l'IA : Rend les techniques avancées de deep learning accessibles aux utilisateurs qui ne sont pas des experts en programmation ML.
  • Reproductibilité : La configuration déclarative garantit que les expériences sont entièrement reproductibles et faciles à partager.
  • Scalabilité par Défaut : Passez en toute transparence de l'entraînement sur une machine locale à un cluster multi-GPU, multi-nœuds dans le cloud sans changer votre code.

Tarification et plans

Ludwig est un projet entièrement gratuit et open-source. Il est hébergé par la Linux Foundation AI & Data et est sous licence Apache 2.0. Il n'y a pas de frais, d'abonnements ou de plans payants associés à l'utilisation du framework. Les utilisateurs peuvent le télécharger, le modifier et l'utiliser librement à des fins académiques et commerciales.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
Apprentissage automatique
Uniquement fullstackdeeplearning
Communauté TechProgrammation
Uniquement Ludwig
Entraînement de modèleLow-Code No-Code

Étiquettes

Commun
Apprentissage profondGrand modèle linguistiqueapprentissage automatiquePython
Uniquement fullstackdeeplearning
Communauté IADéveloppement de l'IAFormation des développeursMLOpsCours en lignePyTorch
Uniquement Ludwig
AutoMLscience des donnéesML DéclaratifRéglage fincadrelow-codeMultimodalOpen source

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement fullstackdeeplearning
Aucune donnée vérifiée
Uniquement Ludwig
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

fullstackdeeplearning monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
64.8K
Durée moyenne
0:18
Pages par visite
1.89
Taux de rebond
41.88%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 54K
  • 2026-01: 48K
  • 2026-02: 53.5K
  • 2026-03: 52K
  • 2026-04: 42.2K
  • 2026-05: 64.8K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇳India32.37%21K
🇺🇸United States26.66%17.3K
🇬🇧United Kingdom15.25%9.9K
🇻🇳Vietnam13.89%9K
🇳🇬Nigeria11.83%7.7K

Sources de trafic

Source typePercentageEstimated visits
Direct85.25%55.2K
Référence13.57%8.8K
E-mail1.18%765

Mots-clés

full stack deep learningfullstackdeeplearningfullstackdeeplearning.com expiredfull stack llm bootcampfull stack llm boot camp the full stack

Ludwig monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
6.6K
Durée moyenne
0:14
Pages par visite
1.66
Taux de rebond
41.22%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: Non vérifié
  • 2026-01: 7.2K
  • 2026-02: 5.3K
  • 2026-03: 6.5K
  • 2026-04: 6.3K
  • 2026-05: 6.6K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States62.41%4.1K
🇮🇳India25.98%1.7K
🇨🇦Canada7.38%484
🇻🇳Vietnam4.23%277

Mots-clés

in context learningin-context learningludwiludwigludwig guru

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

fullstackdeeplearning

Note
Non vérifié
Commentaires
0
Favoris
145
J’aime
162

Ludwig

Note
Non vérifié
Commentaires
0
Favoris
147
J’aime
158

fullstackdeeplearning vs Ludwig · FAQ comparative

What do fullstackdeeplearning and Ludwig have in common?
Both tools are listed under Apprentissage automatique. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are fullstackdeeplearning and Ludwig free?
Listed pricing models: fullstackdeeplearning — Paid; Ludwig — Free. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between fullstackdeeplearning and Ludwig?
The primary listed category is Communauté Tech for fullstackdeeplearning, and Entraînement de modèle for Ludwig. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés