hystruct
Scraping
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Scraping
Scraping
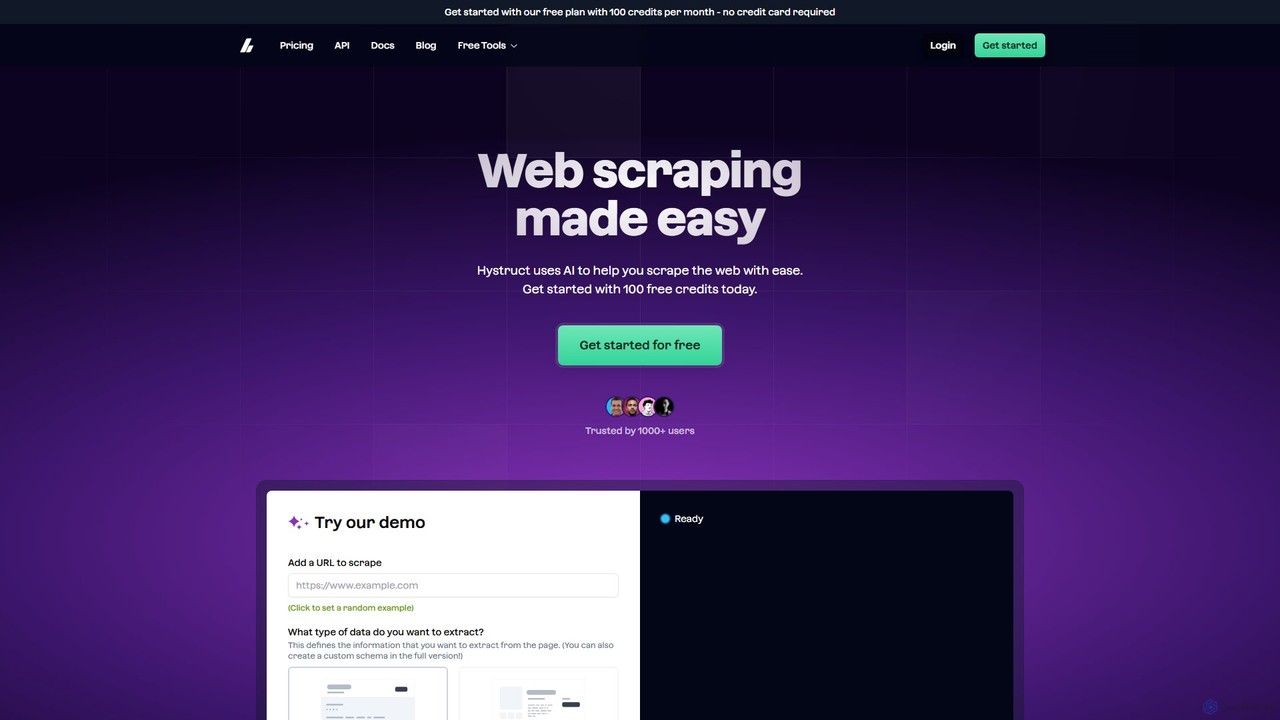
hystruct est un outil de web scraping alimenté par l'IA qui simplifie l'extraction de données. Il permet aux utilisateurs de transformer facilement du contenu web non structuré en données structurées à l'aide de schémas prédéfinis ou personnalisés, sans avoir besoin de coder. Avec des intégrations comme Zapier, il automatise les flux de travail pour l'étude de marché, la génération de leads, et plus encore. Il est conçu pour tout le monde, des débutants aux équipes d'entreprise.
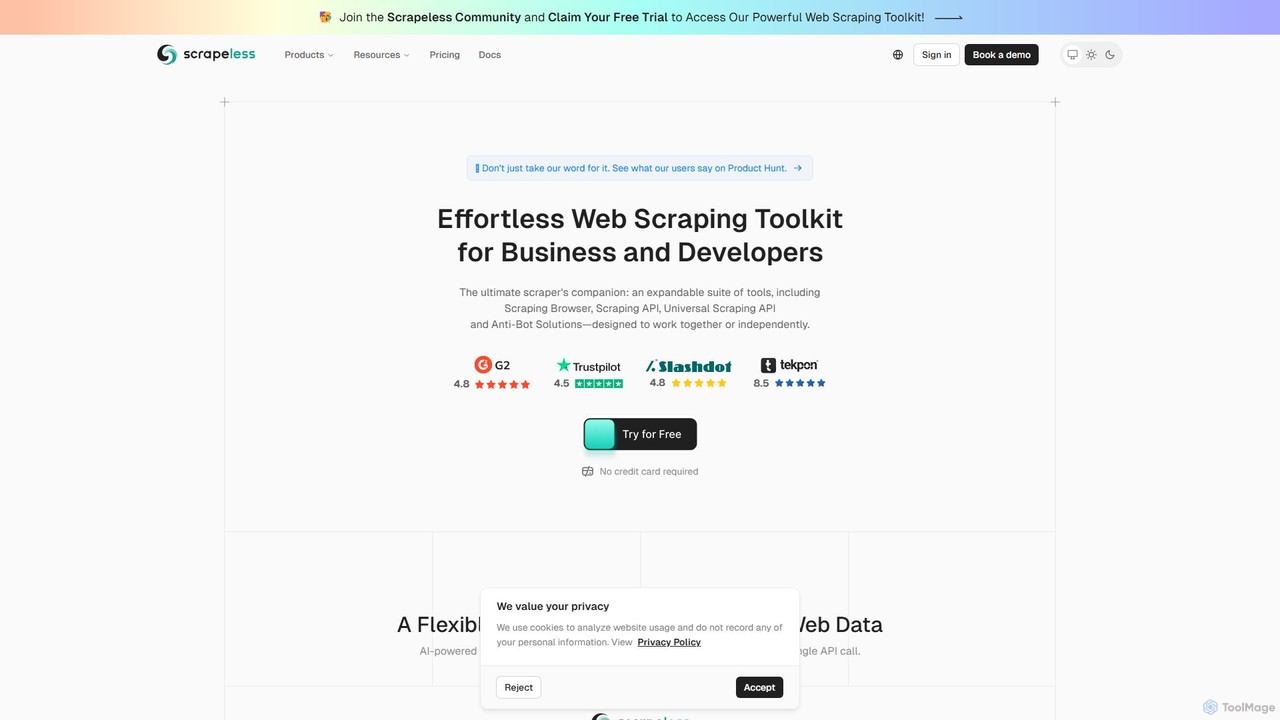
Une boîte à outils de web scraping alimentée par l'IA pour les développeurs et les entreprises. Elle offre une suite d'outils comprenant un navigateur de scraping, une API de scraping universelle et une API Deep SERP pour extraire sans effort des données web publiques à grande échelle. Elle est spécialisée dans le contournement des mesures anti-bot, fournissant des données structurées pour le e-commerce, les études de marché et la formation de modèles d'IA, avec un accent sur la fiabilité et la facilité d'utilisation.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Données clés | hystruct | Scrapeless |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Scraping | Scraping |
| Publics et métiers | Non vérifié | Non vérifié |
| Catégories | Scraping · API · Génération de leads · Automatisation | Scraping · API · SEO · Automatisation |
| Added | 4 août 2025 | 4 août 2025 |
| Mis à jour | 19 nov. 2026 | 19 nov. 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
hystruct est une plateforme avancée de web scraping pilotée par l'IA, conçue pour rendre l'extraction de données de n'importe quel site web simple et efficace. Elle permet aux utilisateurs, quelle que soit leur expertise technique, de convertir des pages web non structurées en données propres et structurées. En tirant parti de l'intelligence artificielle, hystruct élimine le besoin de saisie manuelle de données ou de codage complexe, automatisant l'ensemble du processus, de la saisie de l'URL à la sortie des données. La plateforme est conçue pour un large éventail d'utilisateurs, des particuliers et petites équipes aux grandes entreprises, offrant une solution évolutive pour divers besoins en données.
L'utilisation de hystruct est un processus simple en trois étapes conçu pour une efficacité maximale :
hystruct est polyvalent et peut être appliqué à de nombreux scénarios :
hystruct offre un avantage concurrentiel significatif en simplifiant une tâche traditionnellement complexe. Ses principaux avantages incluent la vitesse, en automatisant ce qui prendrait des heures de travail manuel ou de codage ; l'accessibilité, en fournissant une solution sans code pour tous les niveaux de compétence ; et la flexibilité, grâce à son support pour les besoins d'extraction de données simples et complexes avec des schémas personnalisés et un accès API. Les capacités d'intégration améliorent encore la productivité en s'intégrant directement dans les flux de travail existants.
hystruct propose un modèle de tarification à plusieurs niveaux pour répondre à différents besoins :
Scrapeless est une plateforme de web scraping avancée, pilotée par l'IA, conçue pour simplifier et mettre à l'échelle l'extraction de données pour les entreprises et les développeurs. Ce n'est pas un simple outil, mais une boîte à outils flexible comprenant un navigateur de scraping, une API de scraping universelle et une API Deep SERP spécialisée. Cette suite est conçue pour tout gérer, de la simple collecte de données aux défis anti-bot complexes, garantissant un accès transparent aux données web publiques. En tirant parti de l'IA, Scrapeless automatise le processus de contournement des blocages, d'analyse du contenu et de livraison de données structurées et exploitables, ce qui en fait un compagnon essentiel pour quiconque a besoin d'informations web fiables.
L'utilisation de Scrapeless est conçue pour être un processus simple, intégrant de puissantes capacités de scraping via une interface API simple. Voici un flux de travail typique :
1. Inscrivez-vous et obtenez une clé API : Créez un compte gratuit sur le site web de Scrapeless. Aucune carte de crédit n'est requise pour l'essai, qui vous donne un accès immédiat à votre clé API personnelle depuis le tableau de bord.
2. Choisissez le bon outil : En fonction de vos besoins, sélectionnez le service approprié. Utilisez l'API de scraping universelle pour le scraping général de n'importe quel site web public. Optez pour l'API Deep SERP pour une extraction ciblée et en temps réel de résultats de moteurs de recherche structurés. Pour les sites web avec beaucoup de JavaScript et des mesures anti-bot complexes, le navigateur de scraping est le choix idéal.
3. Intégrez-le dans votre code : Utilisez les exemples de code fournis sur le tableau de bord pour intégrer Scrapeless dans votre application. Il est entièrement compatible avec tous les principaux langages de programmation comme Python, Node.js, Java, Go, et plus encore.
4. Faites un appel API : Construisez votre requête API avec votre URL cible et tous les paramètres spécifiques dont vous avez besoin, comme la géolocalisation pour les requêtes SERP ou les paramètres de gestion de session.
5. Laissez Scrapeless faire le travail : Une fois la requête envoyée, Scrapeless gère toutes les complexités en arrière-plan. Cela inclut la gestion d'un vaste réseau de proxys, la rotation des adresses IP, la résolution des CAPTCHAs et l'utilisation de véritables empreintes de navigateur pour imiter le comportement humain et éviter d'être bloqué.
6. Recevez des données structurées : Vous recevez des données propres et structurées au format JSON, prêtes à être utilisées immédiatement dans vos applications, bases de données ou modèles d'IA. Vous ne payez que pour les requêtes réussies, ce qui garantit la rentabilité.
Scrapeless est un outil polyvalent applicable dans diverses industries et fonctions :
• E-commerce et intelligence de marché : Suivez les prix des produits concurrents, surveillez les niveaux de stock, analysez les stratégies de tarification et agrégez les avis des clients de n'importe quelle plateforme de e-commerce ou place de marché.
• SEO et stratégie de contenu : Utilisez l'API Deep SERP pour surveiller le classement des mots-clés en temps réel, analyser les fonctionnalités des SERP, suivre les mentions de marque et découvrir des opportunités de contenu.
• IA et apprentissage automatique : Alimentez les grands modèles de langage (LLM) et les systèmes de génération augmentée par récupération (RAG) avec des données fraîches, structurées et pertinentes provenant de tout le web, améliorant ainsi la précision et l'actualité des informations générées par l'IA.
• Génération de leads : Extrayez systématiquement les informations de contact, les détails des entreprises et d'autres données pertinentes des annuaires professionnels, des réseaux professionnels et des sites web d'entreprise pour créer des listes de prospects ciblées.
• Analyse de données financières : Collectez des données boursières en temps réel, des actualités financières et des indicateurs économiques de diverses sources en ligne pour effectuer des analyses de tendances de marché et éclairer les stratégies d'investissement.
La plateforme offre un avantage concurrentiel distinct grâce à plusieurs avantages clés :
• Simplicité et rapidité : Une seule API unifiée remplace la nécessité de construire et de maintenir une infrastructure complexe de proxys, de navigateurs sans tête et d'analyseurs, ce qui permet d'économiser un temps de développement et des frais de fonctionnement considérables.
• Taux de réussite élevé : La technologie anti-bot intelligente et pilotée par l'IA garantit un taux de réussite des requêtes constamment élevé, minimisant les échecs, les tentatives et les lacunes de données.
• Rentabilité : Avec un modèle de 'paiement au succès', les utilisateurs ne sont facturés que pour les données récupérées avec succès, ce qui maximise le retour sur investissement et élimine le gaspillage de budget sur les tentatives infructueuses.
• Évolutivité inégalée : L'infrastructure robuste est conçue pour gérer des millions de requêtes, permettant à vos opérations de données de s'adapter sans effort, des petits projets aux charges de travail de niveau entreprise.
• Qualité des données garantie : Des services optionnels de nettoyage et de transformation des données garantissent que les données que vous recevez sont précises, structurées et prêtes pour une analyse et une intégration immédiates.
• Éthique et sécurisé : Scrapeless démontre un engagement fort envers la confidentialité des données, la conformité au RGPD et l'utilisation éthique de la technologie de web scraping, fournissant un service fiable et digne de confiance.
Scrapeless fonctionne sur un modèle de tarification freemium et basé sur l'utilisation, conçu pour s'adapter à un large éventail d'utilisateurs, des développeurs individuels aux grandes entreprises.
• Essai gratuit : Les nouveaux utilisateurs peuvent s'inscrire sans carte de crédit pour recevoir un essai gratuit. Cet essai fournit un nombre généreux de crédits pour tester entièrement toute la suite d'outils, y compris l'API universelle et l'API SERP.
• Paiement à l'utilisation : Ce plan est idéal pour les petits projets ou les utilisateurs ayant des besoins de scraping intermittents. Vous pouvez acheter des crédits selon vos besoins et ne payer que pour les appels API réussis. Différentes API peuvent avoir des coûts de crédit variables en fonction de leur complexité.
• Plans d'abonnement (par ex., Starter, Pro, Business) : Pour les utilisateurs ayant des besoins constants et à haut volume, Scrapeless propose des plans d'abonnement mensuels. Ces plans fournissent un grand volume de crédits à un tarif réduit par rapport au paiement à l'utilisation, ainsi que des avantages supplémentaires comme des limites de concurrence plus élevées, un support plus rapide et des fonctionnalités avancées.
• Plan Entreprise : Pour les entreprises ayant des besoins de données à grande échelle ou uniques, le plan Entreprise offre une solution entièrement personnalisée. Cela inclut une infrastructure dédiée, des scrapers sur mesure, le traitement et le nettoyage des données, des pipelines de livraison de données en temps réel et un accord de niveau de service (SLA) complet pour garantir les performances et la disponibilité.
La tarification est transparente, avec des coûts souvent calculés pour 1 000 requêtes réussies (par exemple, l'API Deep Serp est annoncée à 0,1 $/1k requêtes), vous assurant de pouvoir prédire et gérer facilement vos dépenses.
La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.
Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 100% | 1.4K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇻🇳Vietnam | 33.19% | 25.6K |
| 🇮🇳India | 20.82% | 16K |
| 🇺🇸United States | 18.39% | 14.2K |
| 🇳🇬Nigeria | 14.7% | 11.3K |
| 🇧🇷Brazil | 12.9% | 9.9K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Direct | 60.21% | 46.4K |
| Référence | 39.79% | 30.6K |
Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.