NuMind
Extraction
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
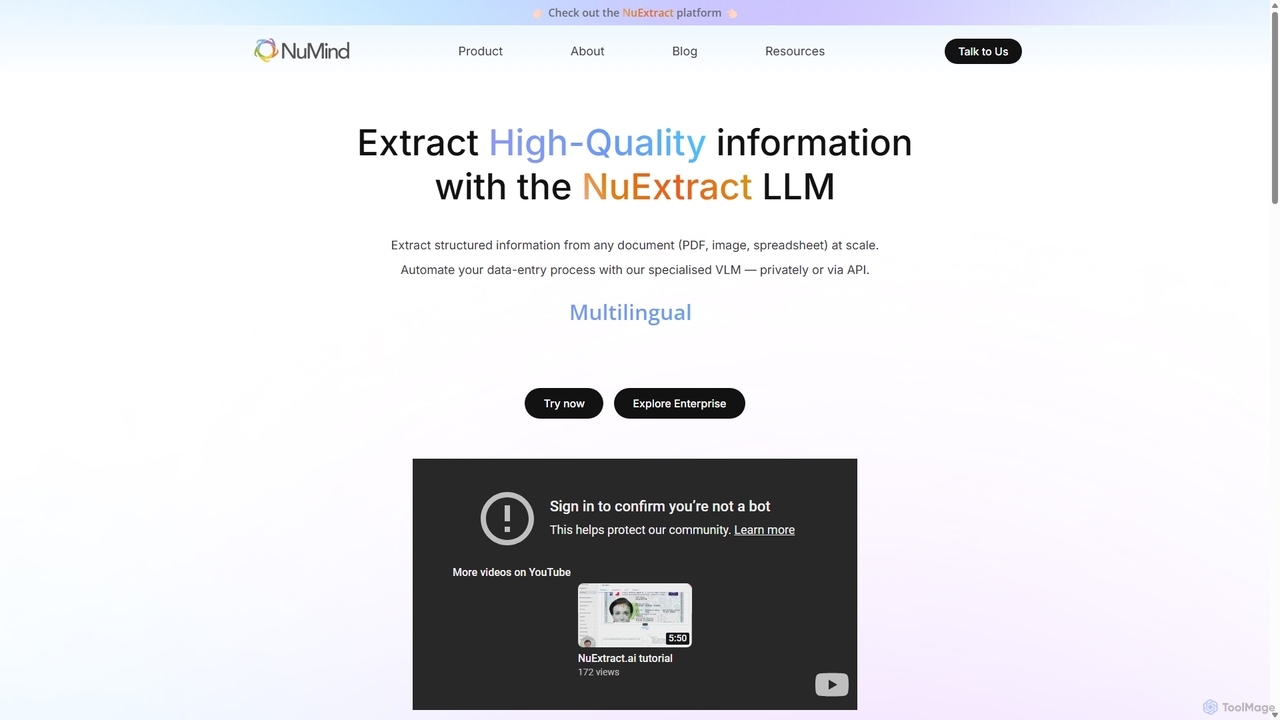
NuMind fournit NuExtract, une plateforme d'IA spécialisée pour l'extraction d'informations structurées de haute qualité. Elle transforme les documents non structurés comme les PDF, les images et les e-mails en données JSON propres à grande échelle. En s'appuyant sur un VLM/LLM léger et puissant, elle offre une précision supérieure et des taux d'hallucination plus faibles que les grands modèles, disponible via une API ou en tant que solution d'entreprise privée.
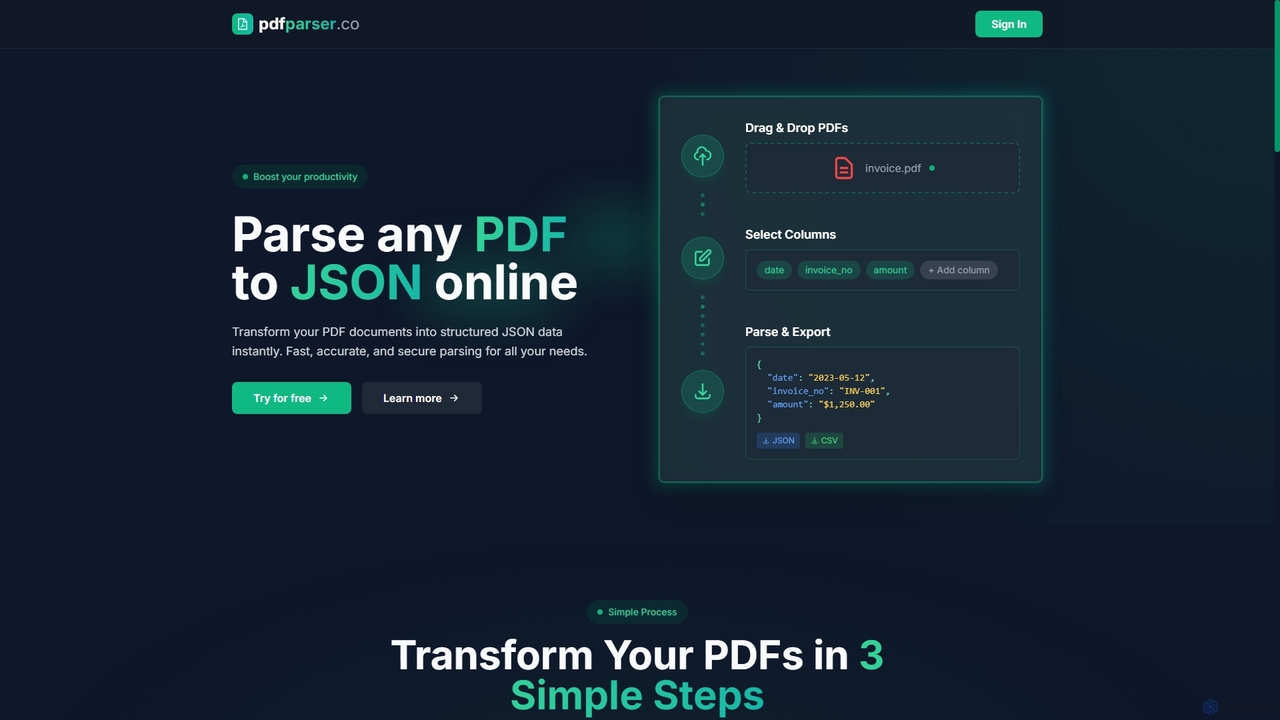
Pdfparser est un outil en ligne alimenté par l'IA qui transforme sans effort les documents PDF en données structurées JSON ou CSV. Il automatise l'extraction de données à partir de divers documents tels que les factures, les contrats et les rapports, éliminant la saisie manuelle. Avec une simple interface de glisser-déposer, les utilisateurs peuvent spécifier les champs requis et obtenir des données précises et lisibles par machine en quelques secondes. Il est conçu pour les utilisateurs non techniques et les développeurs cherchant à rationaliser leurs flux de données.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Données clés | NuMind | Pdfparser |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Extraction | Extraction |
| Publics et métiers | Analyste de données · Analyste Financier · Administrateur de la santé · Responsable des Ressources Humaines · Responsable informatique · Professionnel du droit · Coordinateur Logistique · Ingénieur en Machine Learning · Directeur des opérations · Développeur de logiciels | Comptable · Analyste de données · Responsable des Ressources Humaines · Assistant Juridique · Directeur des opérations · Chercheur · Propriétaire de petite entreprise · Développeur de logiciels |
| Catégories | Extraction · API · Automatisation | Extraction · API · Automatisation |
| Added | 14 sept. 2025 | 26 sept. 2025 |
| Mis à jour | 19 nov. 2026 | 19 nov. 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
NuMind est une société de logiciels d'IA dédiée à rendre l'apprentissage automatique accessible et puissant, avec un accent principal sur le Traitement du Langage Naturel (NLP). Son produit phare, NuExtract, est un modèle de fondation de pointe spécialement conçu pour l'extraction d'informations structurées. Il excelle dans la conversion de grandes quantités de données non structurées provenant de divers types de documents — y compris les PDF, les images, les feuilles de calcul, les contrats et les e-mails — en un format JSON propre, structuré et prêt à l'emploi. Ce processus automatise les tâches fastidieuses de saisie de données, améliore la précision des données et débloque des informations précieuses auparavant piégées dans les documents.
NuExtract est construit sur un Modèle de Langage Visuel (VLM) / Grand Modèle de Langage (LLM) spécialisé et léger qui surpasse constamment les modèles généralistes beaucoup plus grands, comme GPT-4o, dans les tâches d'extraction. Son principal différenciateur est un taux d'hallucination exceptionnellement bas, obtenu grâce à sa capacité à reconnaître quand une information n'est pas présente dans un document et à répondre "Je ne sais pas" au lieu de fabriquer des données. Cette fiabilité en fait une solution idéale pour les applications critiques dans de nombreuses industries.
L'utilisation de la plateforme NuExtract de NuMind est conçue pour être simple et conviviale pour les développeurs, s'intégrant de manière transparente dans les flux de travail existants. Le processus typique est le suivant :
NuExtract est un outil polyvalent applicable dans un large éventail d'industries :
L'approche ciblée de NuMind offre des avantages significatifs par rapport à l'utilisation de modèles d'IA généralistes :
NuMind fonctionne sur un modèle de tarification flexible adapté aux différents besoins. Bien que les détails de tarification spécifiques ne soient pas listés publiquement, la structure est la suivante :
Pdfparser est un outil d'IA puissant et convivial conçu pour simplifier le processus d'extraction d'informations précieuses à partir de documents PDF. Il répond au défi courant de la saisie manuelle des données, qui est souvent longue, sujette aux erreurs et inefficace. En s'appuyant sur une intelligence artificielle avancée, Pdfparser peut analyser intelligemment une grande variété de fichiers PDF — des factures et rapports structurés aux contrats juridiques non structurés — et les convertir en formats JSON ou CSV propres et structurés. Cette automatisation augmente la productivité, améliore la précision des données et permet aux entreprises et aux particuliers de se concentrer sur l'analyse et l'utilisation de leurs données plutôt que sur leur collecte.
La plateforme est conçue pour la simplicité et ne nécessite aucune expertise technique. L'ensemble du processus peut être complété en trois étapes simples :
Pdfparser est polyvalent et apporte de la valeur dans de nombreuses industries :
L'utilisation de Pdfparser offre un avantage concurrentiel en transformant les flux de travail riches en documents. Les principaux avantages incluent une réduction drastique du travail manuel, entraînant des économies de temps et de coûts significatives. Le processus piloté par l'IA minimise les erreurs humaines, garantissant une plus grande précision et fiabilité des données. Son approche sans modèle offre la flexibilité de gérer diverses mises en page de documents sans reconfiguration constante. Cela rend les opérations plus évolutives, efficaces et permet aux équipes de débloquer facilement des informations précieuses de leurs documents.
Pdfparser fonctionne sur un système de crédits flexible et prépayé, avec des crédits gratuits disponibles pour les tests. Les crédits n'expirent pas.
Tous les plans incluent les fonctionnalités de base, avec un accès API et une validation de schéma JSON prévus pour une version future.
La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.
Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 68.06% | 3.2K |
| 🇻🇳Vietnam | 21.84% | 1K |
| 🇮🇳India | 10.1% | 472 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇵🇪Peru | 55.86% | 299 |
| 🇮🇳India | 24.11% | 129 |
| 🇨🇴Colombia | 20.03% | 107 |
Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.