ToolMage
Connexion

AI TOOL COMPARISON

Speechllect vs TextSynth

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

Speechllect Aperçu du produit

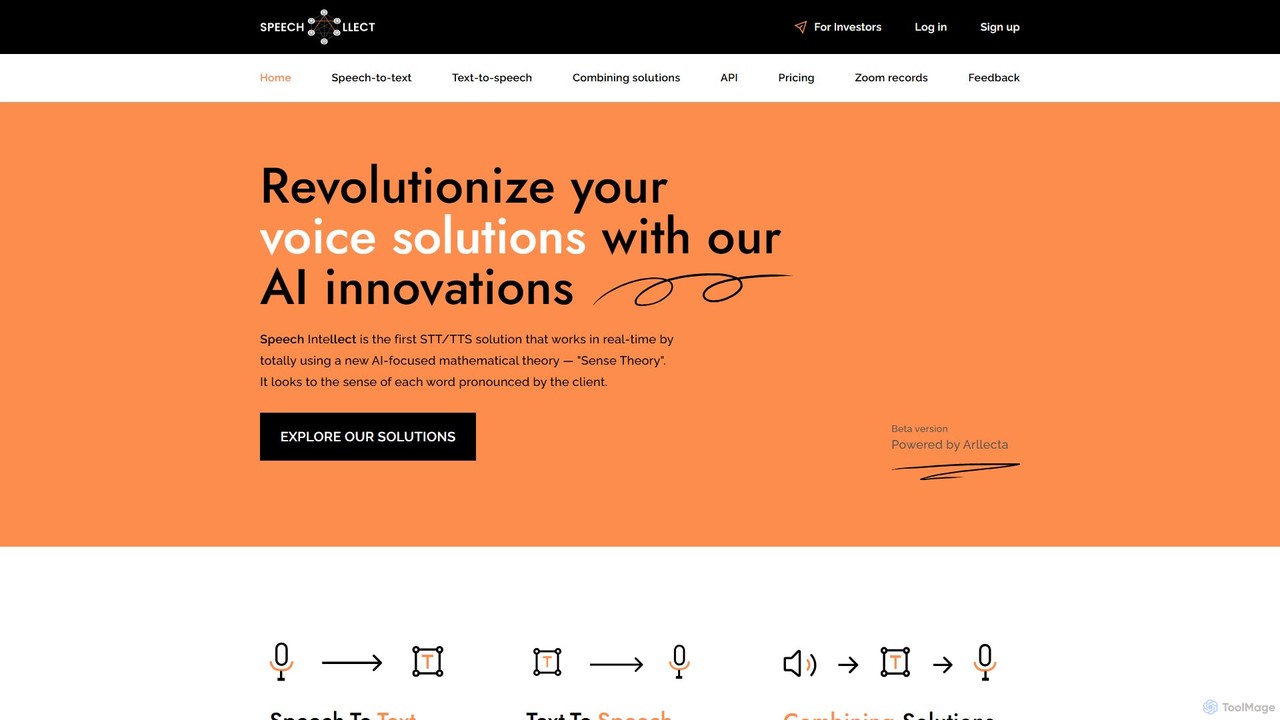
Speechllect est une plateforme avancée de conversion de la parole en texte (STT) et du texte en parole (TTS) alimentée par l'IA. Elle utilise une "Théorie du Sens" unique pour non seulement transcrire et synthétiser la parole, mais aussi pour comprendre et générer le ton et l'intonation émotionnels. Cela la rend idéale pour créer des interactions vocales humaines pour les entreprises, les développeurs et les créateurs de contenu.

Preview

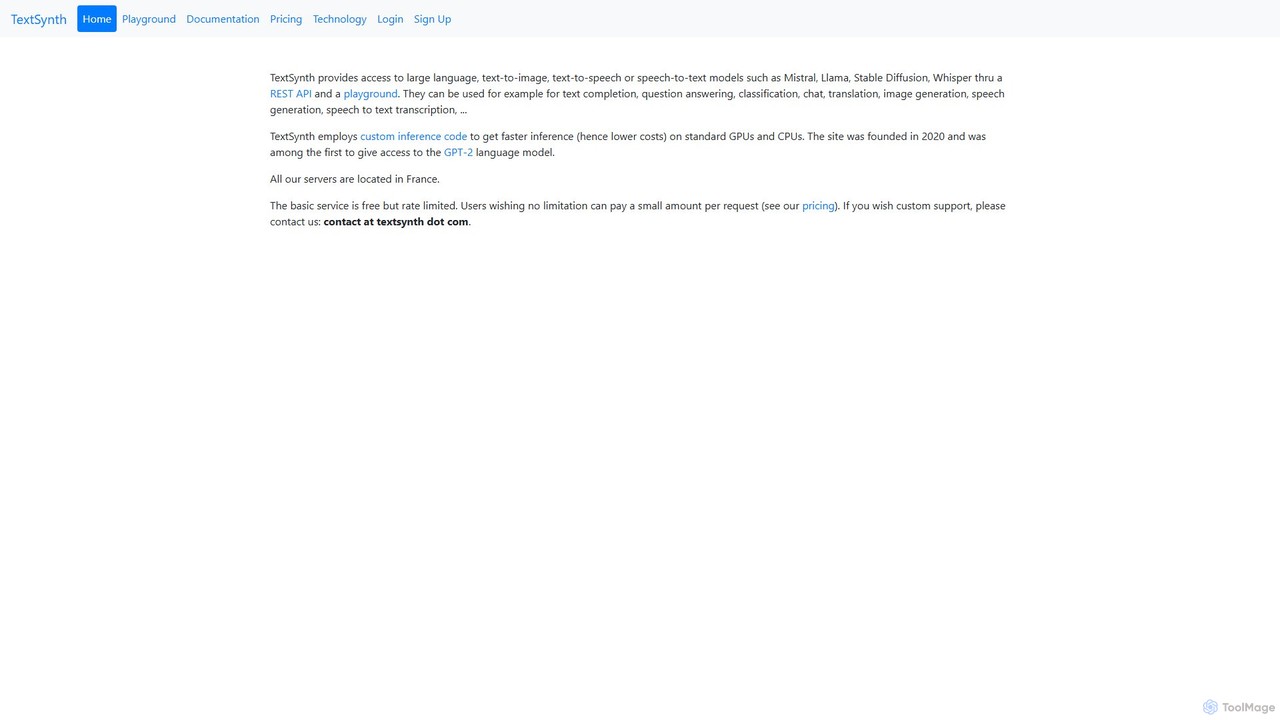
TextSynth Aperçu du produit

TextSynth offre aux développeurs un accès puissant et économique à une suite de modèles d'IA, y compris de grands modèles de langage (LLM), de la conversion texte-image, texte-parole et parole-texte, via une API REST flexible et un terrain de jeu interactif. Il propose des modèles comme Llama, Mistral, Stable Diffusion et Whisper, optimisés pour la vitesse et l'accessibilité.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Speechllect VS TextSynth — Données clés
Données clésSpeechllectTextSynth
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusSynthèse vocaleSynthèse vocale
Publics et métiersNon vérifiéNon vérifié
CatégoriesSynthèse vocale · Automatisation · API · TranscriptionSynthèse vocale · Transcription · API · Génération d'images · Écriture
Added12 août 202512 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Speechllect

Speechllect introduit une approche révolutionnaire des solutions vocales grâce à ses innovations exclusives en matière d'IA. Au cœur de cette technologie se trouve la "Théorie du Sens" (Sense Theory), un nouveau cadre mathématique qui permet au système de fonctionner en temps réel, en se concentrant sur le sens sémantique et émotionnel de chaque mot. Cette technologie permet à Speechllect de fournir des services de conversion de la parole en texte (STT) et de texte en parole (TTS) très précis et dotés d'une intelligence émotionnelle, ce qui la distingue des solutions conventionnelles.

La plateforme est conçue pour un large éventail d'applications, de l'automatisation du service client dans les centres d'appels à la fourniture de voix de personnages réalistes dans les jeux vidéo. En comprenant la tonalité d'un locuteur, le STT de Speechllect peut fournir des informations plus approfondies sur les conversations. De même, son TTS peut générer une parole avec une coloration émotionnelle, un âge et des caractéristiques de genre spécifiques, ce qui se traduit par une expérience vocale véritablement humanoïde. La solution combinée STT et TTS peut automatiser entièrement des scénarios d'interaction complexes, en adaptant son style de conversation pour être amical et respectueux selon les besoins.

Comment utiliser Speechllect

Démarrer avec Speechllect est un processus simple :

  1. Inscription : Créez un compte en fournissant votre nom, votre e-mail et un mot de passe sécurisé. Vous devrez vérifier votre e-mail pour finaliser l'inscription. Les utilisateurs inscrits reçoivent 30 requêtes gratuites pour tester les services.
  2. Utilisation de la Parole en Texte (STT) : Accédez à la page STT. Vous pouvez soit enregistrer de l'audio directement à l'aide de votre microphone, soit télécharger un fichier audio préexistant. Le système traitera l'audio et fournira une transcription textuelle qui capture également le ton émotionnel.
  3. Utilisation du Texte en Parole (TTS) : Sur la page TTS, sélectionnez la langue et les caractéristiques vocales souhaitées. Tapez ou collez votre texte dans la case prévue, et le service générera un fichier audio de haute qualité avec une intonation et une émotion naturelles.
  4. Solution Combinée : La fonction combinée vous permet d'entrer un fichier audio, de le faire transcrire en texte (STT), puis de le reconvertir immédiatement en une voix synthétisée (TTS), ce qui simplifie des processus comme le doublage vocal ou les systèmes de réponse interactive.
  5. Intégration Zoom : Installez l'application Speechllect depuis le Zoom App Marketplace pour transcrire directement vos enregistrements de réunion Zoom. Vous pouvez sélectionner la langue et lancer la transcription pour n'importe quel enregistrement de votre compte.
  6. Intégration API : Pour les développeurs, Speechllect fournit une API complète. Vous pouvez trouver votre clé API dans votre profil utilisateur et l'utiliser pour intégrer les solutions STT, TTS et combinées dans vos propres applications et services.

Fonctionnalités principales de Speechllect

  • Parole en Texte avec Conscience Émotionnelle : Transcrit les mots prononcés tout en identifiant l'émotion et le ton du locuteur.
  • Texte en Parole Humanoïde : Synthétise le texte en une voix avec une intonation, une émotion, un âge et des caractéristiques de genre réalistes basées sur son algorithme "de sens à sens".
  • Solution Combinée STT/TTS : Un flux de travail transparent qui convertit la parole en texte et vice-versa, permettant une automatisation complète des interactions vocales.
  • IA de la Théorie du Sens : Une technologie sous-jacente unique qui se concentre sur la signification et le sentiment derrière les mots pour une précision et une naturalité supérieures.
  • Sécurité par Chiffrement Amorphe : Emploie une technologie cryptographique révolutionnaire sans clés privées pour garantir une sécurité des données à 100 % et une protection contre les attaques de pirates.
  • API pour Développeurs : Une API flexible et puissante pour intégrer les technologies vocales de Speechllect dans des applications tierces.
  • Intégration Zoom : Transcrivez directement l'audio des enregistrements cloud de Zoom pour améliorer la productivité des réunions.

Cas d'utilisation pour Speechllect

La technologie de Speechllect est polyvalente et peut être appliquée dans diverses industries :

  • Automatisation des Centres d'Appels : Automatisez jusqu'à 99,9 % des interactions de vente ou de support technique, l'IA sélectionnant indépendamment les actions et ajustant son ton en fonction des émotions du client.
  • Jeux et Divertissement : Générez des voix humanoïdes dynamiques et réalistes pour les personnages de jeux vidéo, améliorant ainsi l'expérience immersive.
  • Sites Web et Assistants Virtuels : Alimentez les communicateurs virtuels sur les sites Web, offrant une expérience utilisateur plus engageante et naturelle.
  • Appareils Domestiques Intelligents : Permettez des conversations plus confortables et intuitives avec les systèmes domestiques intelligents.
  • Création de Contenu : Générez rapidement des voix off de haute qualité pour les vidéos, les podcasts et les supports d'e-learning.
  • Fabrication et Opérations : Réduisez les coûts en coordonnant les étapes de travail par le biais de commandes vocales et de retours automatisés, en remplaçant les coordinateurs humains dans certains rôles.

Avantages de Speechllect

Speechllect offre des avantages significatifs par rapport aux outils vocaux traditionnels :

  • Intelligence Émotionnelle : Son principal différenciateur est la capacité de traiter et de générer le sous-texte émotionnel de la parole, ce qui conduit à une communication plus significative et efficace.
  • Sécurité Renforcée : L'utilisation du "Chiffrement Amorphe" offre un niveau supérieur de sécurité des données, une caractéristique essentielle pour les entreprises qui traitent des données utilisateur sensibles.
  • Flexibilité et Personnalisation : Les utilisateurs peuvent définir des scénarios de travail complexes pour répondre à leurs besoins commerciaux spécifiques, des tâches de réception simples aux flux de support technique complexes.
  • Cloud Computing à Haute Vitesse : L'ensemble des algorithmes s'exécute sur un cloud privé mondial à haute vitesse, garantissant un traitement rapide et la conformité avec les lois internationales sur les données.
  • Réduction des Coûts : En automatisant des tâches vocales complexes, les entreprises peuvent réduire considérablement les coûts opérationnels et libérer les agents humains pour un travail plus stratégique.

Tarification et plans

Speechllect fonctionne sur un modèle de tarification flexible à l'utilisation (pay-as-you-go) avec une offre freemium.

  • Essai Gratuit : Les nouveaux utilisateurs inscrits reçoivent 30 requêtes gratuites à utiliser sur tous les services (STT, TTS, Combiné).
  • Forfaits à l'Utilisation : Les utilisateurs peuvent acheter des forfaits de requêtes qui n'expirent jamais. Le prix par requête diminue avec le volume.
  • À partir de 1 000 requêtes : 10,00 $ par 1 000 requêtes.
  • À partir de 10 000 requêtes : 9,00 $ par 1 000 requêtes (10 % de réduction).
  • À partir de 100 000 requêtes : 7,50 $ par 1 000 requêtes (25 % de réduction).
  • Plans Personnalisés : Pour les utilisateurs ayant des besoins plus importants, des plans personnalisés peuvent être organisés en contactant l'équipe de vente.

TextSynth

TextSynth est une plateforme d'IA complète qui fournit un accès à une gamme variée de modèles d'IA générative de pointe via une API REST simple et efficace. Fondée en 2020, elle s'est imposée comme une solution fiable et rentable pour les développeurs, les chercheurs et les entreprises cherchant à intégrer des capacités d'IA avancées dans leurs applications. L'offre principale de la plateforme s'articule autour de l'accès à de grands modèles de langage (LLM), des générateurs de texte en image, la transcription de la parole en texte et la synthèse de la parole en texte. Les principaux modèles disponibles incluent Mistral, Llama, Gemma, Stable Diffusion et Whisper. Une caractéristique remarquable de TextSynth est son code d'inférence personnalisé, qui optimise les performances sur les GPU et CPU standard, ce qui se traduit par des vitesses d'inférence plus rapides et des coûts considérablement réduits pour les utilisateurs.

Comment utiliser TextSynth

L'utilisation de TextSynth est simple pour les développeurs. La principale méthode d'interaction se fait via son API REST. Pour commencer, vous devez créer un compte sur le site web de TextSynth pour obtenir une clé API. Cette clé doit être incluse dans l'en-tête de chaque requête API pour l'authentification (Authorization: Bearer YOUR_API_KEY). La plateforme propose divers points de terminaison adaptés à des tâches spécifiques :

  • Completions : Pour la génération de texte, la réponse aux questions et la classification.
  • Chat : Un point de terminaison dédié à la création d'applications conversationnelles.
  • Translate : Utilise des modèles comme MADLAD-400 pour traduire du texte entre des centaines de langues.
  • Text-to-Image : Générez des images à partir de prompts textuels en utilisant des modèles comme Stable Diffusion.
  • Transcript : Transcrivez des fichiers audio en texte avec une grande précision en utilisant Whisper.
  • Speech : Convertissez du texte en parole au son naturel.
  • Embeddings : Générez des embeddings vectoriels pour le texte, idéal pour les applications RAG.

Pour une utilisation non programmatique ou des tests rapides, TextSynth fournit également un terrain de jeu convivial où vous pouvez interagir directement avec les modèles pour la complétion de texte, le chat, la génération d'images, et plus encore.

Fonctionnalités principales de TextSynth

  • API Multi-Modale : Accédez aux modèles de texte, d'image et d'audio via une seule API unifiée.
  • Sélection de Modèles Diversifiée : Offre une large gamme de modèles open-source et puissants, y compris Llama3, Mistral 7B, Gemma 3, Stable Diffusion et Whisper Large v3.
  • Inférence Haute Performance : Utilise un code d'inférence sur mesure pour fournir des résultats plus rapides et des coûts opérationnels inférieurs par rapport aux implémentations standard.
  • Contrôles de Génération Avancés : Fournit un contrôle fin sur la sortie de l'IA avec des paramètres comme la température, top_k, top_p, et prend en charge la génération contrainte à l'aide de la grammaire BNF ou des schémas JSON.
  • Capacités de Traduction Étendues : Le modèle MADLAD-400 prend en charge la traduction entre environ 400 langues.
  • Outils Conviviaux pour les Développeurs : Propose une documentation API détaillée, un terrain de jeu pour l'expérimentation et des points de terminaison pour des fonctions utilitaires comme la tokenisation.
  • Axé sur la Confidentialité : Le plan Standard n'enregistre pas le contenu des requêtes des utilisateurs, et tous les serveurs sont situés en France, respectant des normes de confidentialité strictes.

Cas d'utilisation pour TextSynth

Les modèles polyvalents de TextSynth peuvent être appliqués à un large éventail d'applications :

  • Création de Contenu : Automatisez la génération d'articles, de textes marketing, d'e-mails et d'histoires créatives.
  • Chatbots et Assistants Virtuels : Créez des chatbots intelligents et réactifs pour le service client ou les applications interactives.
  • Support Multilingue : Intégrez des services de traduction en temps réel dans les sites web et les applications pour atteindre un public mondial.
  • Analyse de Données : Effectuez une analyse des sentiments, une classification de texte et une extraction d'entités sur de grands ensembles de données.
  • Art et Design par IA : Créez des images et des visuels uniques à partir de descriptions textuelles pour le marketing, le design ou le divertissement.
  • Transcription Audio et Vidéo : Transcrivez automatiquement les interviews, les réunions, les podcasts et le contenu vidéo avec des horodatages.
  • Applications Vocales : Générez des voix off pour les vidéos, créez des guides audio ou développez des services à commande vocale.

Avantages de TextSynth

TextSynth se distingue pour plusieurs raisons clés. Son principal avantage est la rentabilité, obtenue grâce à son moteur d'inférence optimisé, qui rend l'IA puissante accessible à un prix inférieur. Le système de crédits prépayés de la plateforme offre une tarification transparente et prévisible, éliminant le risque de dépenses imprévues. De plus, il offre une large sélection de modèles de pointe, donnant aux développeurs la flexibilité de choisir le meilleur outil pour leurs besoins spécifiques. La combinaison d'une API robuste, d'une documentation détaillée et d'un niveau gratuit pour les tests en fait une plateforme exceptionnellement conviviale pour les développeurs.

Tarification et plans

TextSynth propose une structure tarifaire simple et transparente avec deux plans principaux :

  • Plan Gratuit : Fournit un accès gratuit et à débit limité à tous les modèles de langage. Idéal pour les tests et les petits projets. Ce plan a une limite de 200 jetons générés par requête, une limite de 3 minutes pour la transcription vocale et nécessite la résolution périodique de captcha. Toutes les requêtes du plan gratuit sont enregistrées.
  • Plan Standard : Il s'agit d'un plan prépayé basé sur des crédits pré-achetés. Il supprime toutes les limitations du plan gratuit : pas de limites de débit, pas de limites de jetons et pas d'enregistrement du contenu des requêtes. L'achat minimum de crédit est de 20 $ ou 20 €, et les crédits sont valables un an.

La tarification est basée sur l'utilisation :

  • Grands Modèles de Langage : Prix par million de jetons d'entrée et de sortie (ex: Llama3.1 8B Instruct coûte 0,20 $ par million de jetons d'entrée et 2,00 $ par million de jetons générés).
  • Génération d'Images : Prix par image (ex: Stable Diffusion coûte 0,005 $ par image).
  • Parole en Texte : Prix par minute d'audio (ex: Whisper Large V3 coûte 0,003 $ par minute).
  • Texte en Parole : Prix par million de caractères d'entrée (ex: Parler-TTS coûte 14,00 $ par million de caractères).

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
Synthèse vocaleAPI
Uniquement Speechllect
AutomatisationTranscription
Uniquement TextSynth
TranscriptionGénération d'imagesÉcriture

Étiquettes

Commun
APIDiscours en texteSynthèse vocale
Uniquement Speechllect
Voix IAautomatisation des centres d'appelsintelligence émotionnelletraitement de la parole en temps réelTranscriptionClonage vocalsynthèse vocaleIntégration Zoom
Uniquement TextSynth
Outils pour développeursgénération d'imagesgrand modèle linguistiqueLlamaGrand modèle linguistiqueMistralStable DiffusionGénération de textetraductionWhisper

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement Speechllect
Aucune donnée vérifiée
Uniquement TextSynth
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Speechllect

Non vérifié

TextSynth monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
3.3K
Durée moyenne
0:09
Pages par visite
1.56
Taux de rebond
50.88%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5.8K
  • 2026-01: 2.4K
  • 2026-02: 2.8K
  • 2026-03: 3.1K
  • 2026-04: 5.6K
  • 2026-05: 3.3K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States80.54%2.7K
🇵🇱Poland11.07%369
🇮🇹Italy7.35%245
🇪🇸Spain1.04%35

Mots-clés

completiontext completion aitext completion llmtext completion playgroundtextsynth

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

Speechllect

Note
Non vérifié
Commentaires
0
Favoris
166
J’aime
143

TextSynth

Note
Non vérifié
Commentaires
0
Favoris
167
J’aime
161

Speechllect vs TextSynth · FAQ comparative

What do Speechllect and TextSynth have in common?
Both tools are listed under Synthèse vocale、API. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Speechllect and TextSynth free?
Listed pricing models: Speechllect — Freemium; TextSynth — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Speechllect and TextSynth?
The primary listed category is Synthèse vocale for Speechllect, and Synthèse vocale for TextSynth. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés