
Freemium
Runexo
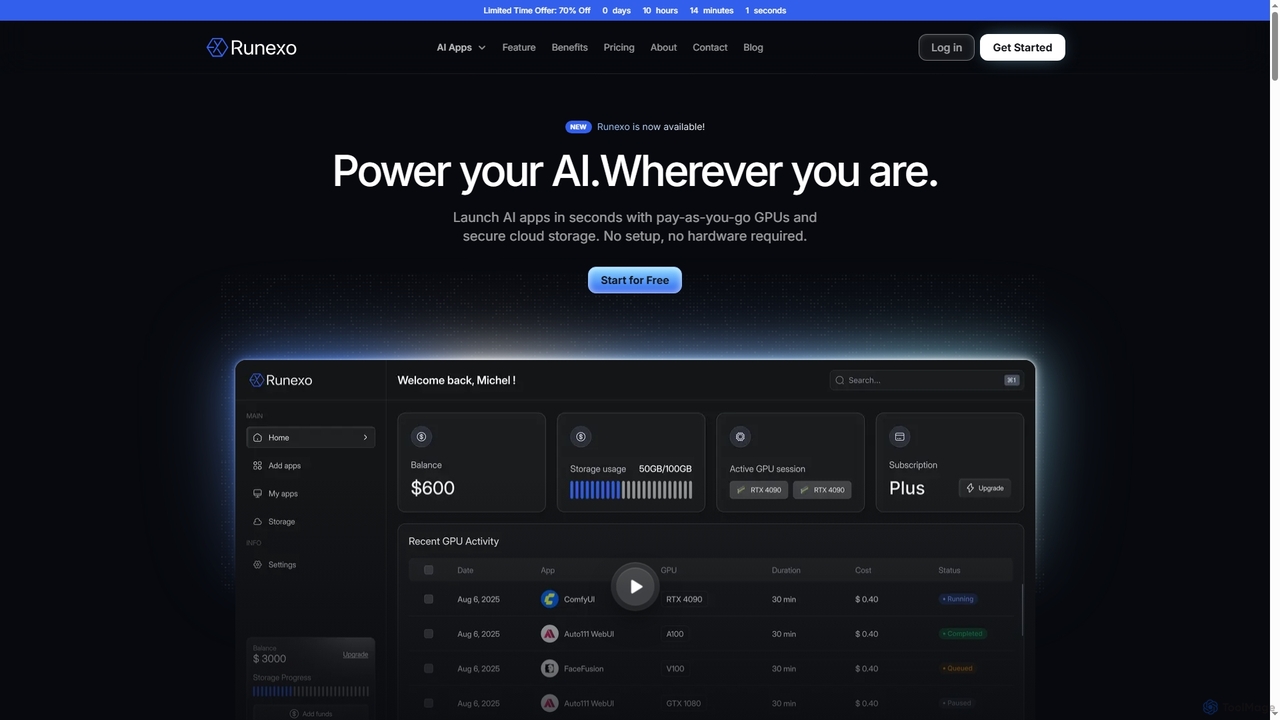
Runexoは、AI開発、トレーニング、推論を強化するために設計されたクラウドGPUプラットフォームです。高性能な従量課金制GPUと安全なクラウドストレージへの即時アクセスを提供し、開発者、研究者、企業がStable Diffusion、ComfyUI、FooocusなどのAIアプリケーションをセットアップやハードウェア要件なしに数秒で起動できるようにします。
GPUアズアサービスVisits 9.8KFavorites 162Likes 175
Popular Stable Diffusion AI tools in 画像生成 include Runexo, helping you work more efficiently.
Runexoは、AI開発、トレーニング、推論を強化するために設計されたクラウドGPUプラットフォームです。高性能な従量課金制GPUと安全なクラウドストレージへの即時アクセスを提供し、開発者、研究者、企業がStable Diffusion、ComfyUI、FooocusなどのAIアプリケーションをセットアップやハードウェア要件なしに数秒で起動できるようにします。
GPUアズアサービスStable Diffusionは、より広範な画像生成ツールのサブカテゴリであるAI画像生成のために設計された、強力なオープンソースの潜在拡散モデルです。テキストプロンプトから高品質な画像を生成し、既存の画像を修正することに優れており、比類ない創造的な自由とカスタマイズ性を提供します。この技術は、アーティスト、デザイナー、開発者が視覚的なプロトタイプを迅速に作成し、多様なスタイルを探求し、独自のコンテンツを驚くべき効率で生成することを可能にします。
Stable Diffusionは、クリエイティブ産業全体で広く採用されています。アーティストはコンセプトアートやスタイル探求に、マーケターはキャンペーン用の多様なビジュアルアセット生成に利用します。ゲーム開発者は環境やキャラクターの迅速なプロトタイピングに活用し、建築家はデザインを視覚化します。その柔軟性により、パーソナライズされたコンテンツ作成やデジタルアートの頼れるツールとなっています。
Stable Diffusionの実装またはモデルを選択する際には、バージョン(例:高品質なSDXL)、コミュニティサポートと利用可能なリソース、ローカル実行のためのハードウェア要件、およびユーザーインターフェース(CLI対Web UI)を考慮してください。ファインチューニングの容易さ、特定のLoRAモデルの利用可能性、および他のクリエイティブソフトウェアとの統合機能も評価してください。
ゲーム開発者や映画のコンセプトアーティストは、Stable Diffusionを使用して視覚的なアイデアを迅速にプロトタイプ化します。キャラクター、環境、小道具のテキスト記述を入力することで、数分で何百ものユニークなバリエーションを生成でき、アイデア出しの段階を大幅に加速し、デザインの反復に多様な選択肢を提供します。
ゲームや映画のコンセプトアーティストは、Stable Diffusion を利用して、キャラクターデザイン、環境設定、小道具のアイデアを迅速に視覚化します。記述的なテキストプロンプトを入力することで、数分で何百ものスタイルのバリエーションを生成でき、初期のアイデア出しの段階を大幅に加速し、詳細な制作に入る前に視覚的なテーマを迅速に反復検討できます。
マーケティング担当者やコンテンツクリエイターは、Stable Diffusion を利用して、ソーシャルメディア、広告、ブログ記事用の幅広いビジュアルアセットを制作します。これにより、特定のキャンペーンテーマ、ターゲットオーディエンス、美的要件に合わせた画像を迅速に生成でき、ストック写真や大規模な手動デザインに頼ることなく、新鮮で魅力的なコンテンツを確保できます。
マーケティング担当者は、Stable Diffusionを活用してキャンペーン用の目を引くビジュアルを作成します。特定のテーマやターゲット層に合わせた製品モックアップ、ソーシャルメディアグラフィック、広告バナーを生成でき、大規模な写真撮影やグラフィックデザインのリソースに頼ることなく、迅速なA/Bテストとパーソナライズされたコンテンツ作成を可能にします。
個人のアーティストや愛好家は、Stable Diffusionを使用して独自のビジョンを実現します。さまざまな芸術スタイルを試したり、カスタムキャラクターを生成したり、デジタル絵画やイラストの複雑な背景を作成したりすることで、創造性の限界を押し広げ、高度にパーソナライズされたアートワークを生み出します。
個人ユーザーやデジタルアーティストは、Stable Diffusion を利用して、高度にパーソナライズされたアバター、プロフィール画像、ユニークなデジタルアート作品を作成します。自身の画像や特定の芸術スタイルでモデルをファインチューニングすることで、個人の好み、架空のキャラクター、または独自の芸術的ビジョンを反映したオーダーメイドのビジュアルを生成し、新たなレベルの創造的な自己表現を促進します。
ファッションデザイナーは、Stable Diffusion を活用して、新しい衣服のスタイル、生地の質感、パターンデザインを探求します。希望する美学の記述を入力したり、初期スケッチをアップロードしたりすることで、多数のデザイン反復を生成し、異なる素材がどのように見えるかを視覚化し、革新的なファッションコンセプトを迅速にプロトタイプ化することで、アイデア出しから視覚化までのデザインプロセスを効率化します。
建築家やインテリアデザイナーは、Stable Diffusionを使用してデザインコンセプトを迅速に視覚化します。基本的なレイアウトやムードボードを入力することで、さまざまなスタイルや照明条件での建物、部屋、家具配置のリアルなレンダリングを生成でき、クライアントへのプレゼンテーションやデザインの反復作業において大幅な時間短縮に貢献します。
建築家やインテリアデザイナーは、Stable Diffusion を利用して、建物の外観、部屋のレイアウト、家具の配置のリアルな、または様式化されたレンダリングを迅速に生成します。基本的なワイヤーフレームや簡単なスケッチを詳細な視覚コンセプトに変換し、照明、素材、デザイン要素を試すことで、クライアントに多様な選択肢を提示し、ビジョンを効率的に洗練させることができます。
ファッションデザイナーやテキスタイルアーティストは、Stable Diffusionを活用して創造プロセスを革新します。独自の生地パターンを生成したり、仮想モデル上で服のデザインを視覚化したり、コレクションの新しい美的方向性を探求したりすることで、迅速なプロトタイピングを可能にし、デザインの初期段階での物理サンプルの必要性を減らします。
コミックアーティストやアニメーターは、Stable Diffusion を利用して、迅速なストーリーボード作成とコマ生成を行います。シーンの説明やキャラクターのポーズを提供することで、物語の流れ、カメラアングル、キャラクターの表情を視覚化するのに役立つ連続画像を生成できます。これにより、プリプロダクション段階が大幅に加速され、よりダイナミックで視覚的に一貫性のあるストーリーテリングが可能になります。
写真家やグラフィックエディターは、Stable Diffusionを高度な画像操作に利用します。不要なオブジェクトの削除(インペインティング)、背景の拡張(アウトペインティング)、写真へのスタイル転送などのタスクを実行でき、手作業や専門的なソフトウェアスキルを必要とする複雑な編集を可能にします。
Stable Diffusionは、テキストや他の画像から高品質な画像を生成するオープンソースの潜在拡散モデルです。与えられたプロンプトに基づいてノイズの多い画像を反復的に洗練し、一貫性のある画像に変換することで機能し、創造的なコンテンツ生成のための強力なツールとなっています。その核となる強みは、柔軟性、カスタマイズ性、そして消費者向けハードウェアで実行できる能力にあり、より広範なAI画像生成の分野で際立っています。
Stable Diffusionは、テキスト記述から高品質な画像を生成できるオープンソースの潜在拡散モデルです。圧縮された潜在空間でノイズの多い画像を繰り返し洗練することで機能し、プロセスを効率化します。その主要な機能には、テキストから画像、画像から画像、インペインティング、アウトペインティングがあり、ユーザーに広範な創造的制御を提供します。
Stable Diffusionは主にオープンソースであり、高度にカスタマイズ可能で、ユーザーは自身のデータでモデルをファインチューニングし、ローカルで実行できます。対照的に、MidjourneyやDALL-Eは通常、プロプライエタリなクラウドベースのサービスであり、より厳選されたインターフェースを持ち、基盤となるモデルに対する直接的な制御は少ないです。Stable Diffusionは上級ユーザーや開発者により大きな柔軟性を提供しますが、MidjourneyやDALL-Eは迅速な結果のために、より合理化されたユーザーフレンドリーな体験を提供することがよくあります。
Stable Diffusionは、そのオープンソースの性質とローカル実行機能により、比類のないカスタマイズ性とプライバシーを提供します。MidjourneyやDALL-Eは通常、使いやすさと特定の美的スタイルで知られる独自のクラウドベースのサービスですが、Stable Diffusionはモデル、ファインチューニング、カスタムワークフローへの統合を完全に制御でき、より技術的な設定が必要な場合もありますが、より大きな柔軟性をもたらします。
Stable Diffusionをローカルで実行するには、通常、少なくとも8GBのVRAMを搭載した専用GPUが必要ですが、最適なパフォーマンスとより大きな画像生成のためには12GB以上が推奨されます。強力なCPUと十分なRAM(16GB以上)も有益です。一部のバージョンはより低性能なハードウェアでも実行できますが、パフォーマンスと機能アクセスが制限される場合があります。適切なローカルハードウェアがない場合は、クラウドベースのオプションも利用できます。
LoRA(Low-Rank Adaptation)モデルは、Stable Diffusion用の小型で軽量なアドオンであり、モデル全体を再トレーニングすることなく、特定のスタイル、キャラクター、またはオブジェクトに合わせてベースモデルをファインチューニングできます。これらは、最小限の計算リソースで高度に専門化された画像生成を可能にし、一貫した美学を実現したり、特定の被写体を繰り返し生成したりすることを容易にするため、カスタマイズ性と効率性を大幅に向上させる上で非常に重要です。
はい、Stable Diffusionは、そのコアモデルが寛容なライセンス(例:CreativeML Open RAIL-M License)の下でリリースされているため、商用利用が可能です。ただし、使用するカスタムモデル(チェックポイント、LoRA)や拡張機能の特定のライセンスには注意が必要であり、これらは異なる条件を持つ場合があります。常にワークフロー内のすべてのコンポーネントのライセンスを確認し、コンプライアンスを確保してください。
Stable Diffusionツールを選択する際には、使いやすさのためのユーザーインターフェース(例:Automatic1111、ComfyUI、またはクラウドサービス)、品質と機能のための利用可能なモデルバージョン(例:SD 1.5、SDXL)、およびローカルで実行する場合のハードウェア能力を考慮してください。また、コミュニティサポート、拡張機能やプラグインの利用可能性、ControlNetやカスタムスクリプトなどの高度な機能に関連する学習曲線も評価してください。
はい、Stable Diffusionは通常、商用利用が可能です。そのライセンス(CreativeML Open RAIL-M)は商用利用を許可しています。ただし、ユーザーは常に使用している特定のモデルチェックポイントやLoRAの具体的なライセンスを確認する必要があります。一部のコミュニティ貢献モデルには異なる制限がある場合があります。さらに、ユーザーは生成されたコンテンツが著作権法および倫理ガイドラインに準拠していることを確認する責任があります。
ControlNetは、Stable Diffusionにおける画像生成プロセスに対して、ユーザーが詳細な空間制御を行えるようにするニューラルネットワーク構造です。深度マップ、Cannyエッジマップ、ポーズ推定(OpenPose)などの追加入力を受け取り、拡散モデルがこれらの構造的または構成的な手がかりに従うように誘導することで機能します。これにより、生成される画像に対して正確な制御が可能になり、特定のポーズ、レイアウト、オブジェクトの配置が維持されます。