ToolMage
ログイン

AI TOOL COMPARISON

Bright Data vs Crawly

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

Bright Data 製品概要

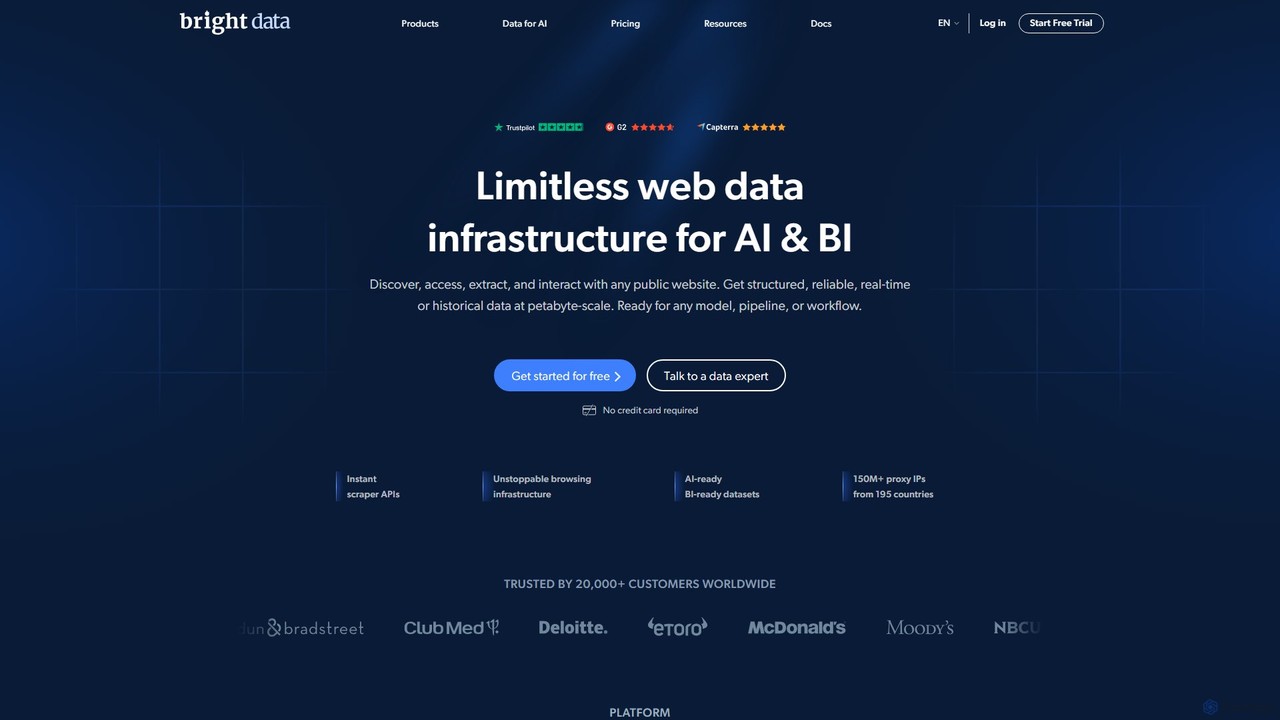
Bright Dataは、プロキシネットワーク、AI搭載ウェブスクレイパー、すぐに使えるデータセットなど、包括的なツールスイートを提供する世界有数のウェブデータプラットフォームです。企業がAIトレーニング、市場調査、競合情報のために大量の公開ウェブデータを収集することを可能にします。

Preview

Crawly 製品概要

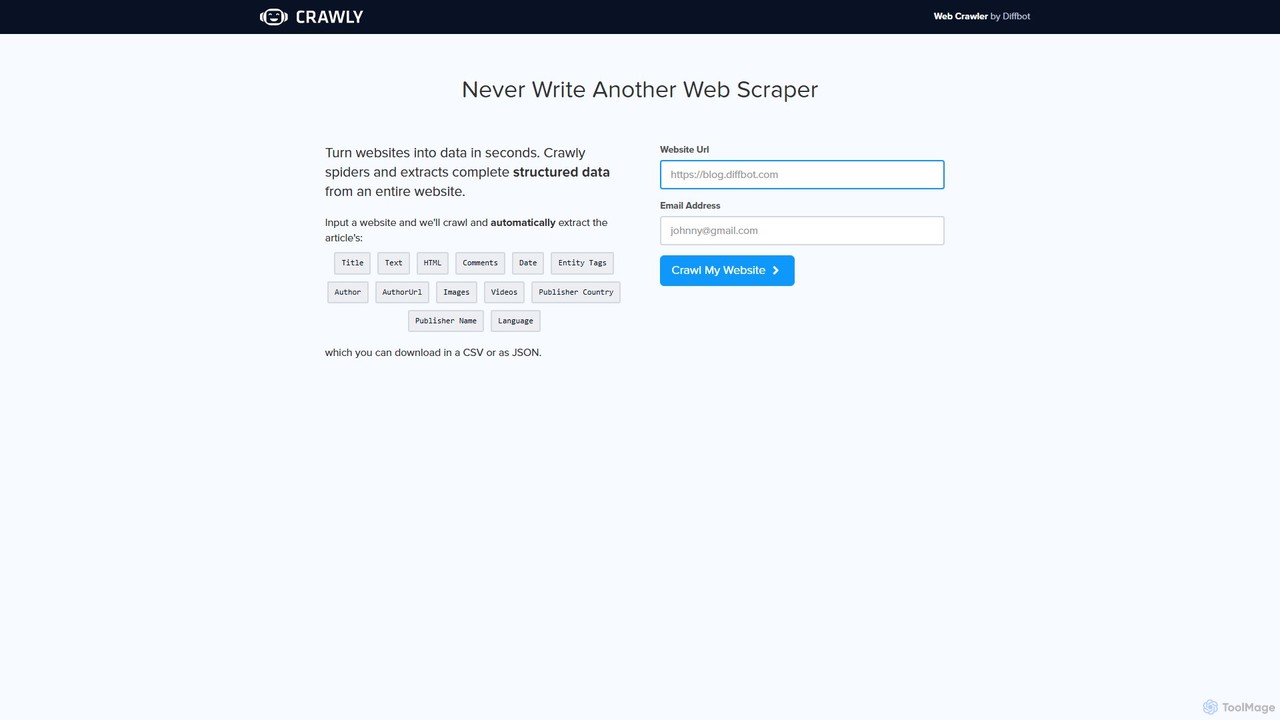
CrawlyはDiffbotが開発したAI搭載のウェブクローラーで、ウェブサイト全体から構造化データを自動的に抽出します。URLを入力するだけで、Crawlyがサイトをスパイダーし、記事、製品、ディスカッションなどの重要な情報を取得し、コーディング不要でクリーンなJSONまたはCSVデータに変換します。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Bright Data VS Crawly — 基本情報
基本情報Bright DataCrawly
Pricing modelPaidFreemium
Product typeWebWeb
Primary focusビジネスインテリジェンスウェブスクレイピング
対象ユーザーと職種未確認未確認
カテゴリービジネスインテリジェンス · ウェブスクレイピング · API · 市場調査ウェブスクレイピング · API · 市場調査 · 自動化
Added2025/08/122025/08/10
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Bright Data

Bright Dataは、世界No.1のウェブデータプラットフォームとして、ほぼすべての業界で20,000以上の組織から信頼されています。あらゆる規模の公開ウェブデータを発見、アクセス、抽出するための堅牢なオールインワンソリューションを提供します。リアルタイムデータでも履歴データでも、Bright Dataのインフラは、あらゆるモデル、パイプライン、ワークフローに対応できる構造化された信頼性の高い情報を提供できるように構築されています。このプラットフォームは、AI開発の促進、市場調査の強化、オンライン資産の監視、データ駆動型の意思決定を可能にするように設計されています。

Bright Dataの使い方

Bright Dataは、ニーズに応じていくつかの方法で利用できる柔軟なプラットフォームを提供しています。

  1. プロキシネットワーク:Bright Dataの受賞歴のあるプロキシネットワーク(住宅、ISP、データセンター、モバイル)を既存のデータ収集スクリプトやアプリケーションに統合します。これにより、何百万もの実ユーザーIPを介してリクエストをルーティングし、地理的制限を回避し、ブロックを避けて、あらゆる公開ウェブサイトに匿名で正常にアクセスできます。
  2. ウェブスクレイパーIDE:カスタムスクレイパーを構築したい方向けに、ウェブスクレイパーIDEは、事前構築済みの関数とテンプレートを備えた強力な環境を提供します。基盤となるプロキシインフラ、スケーリング、または遮断を処理することなく、ウェブスクレイパーを開発、実行、管理できます。
  3. データセットマーケットプレイス:最も簡単な始め方は、データセットマーケットプレイスにアクセスすることです。Amazon、LinkedIn、Zillow、Instagramなどの何百もの人気ウェブサイトから、すぐに使える構造化されたデータセットを購入できます。データは1回限りの購入として、または定期的な更新のためのサブスクリプションを通じてダウンロードできます。
  4. データセットAPI:プログラムによるアクセスの場合、データセットAPIを使用すると、カスタムデータコレクションを定義、リクエスト、および取得できます。ワークフローには通常、次のものが含まれます:1)ターゲットサイトとデータポイントを定義してコレクションをリクエストする。2)コレクションジョブのステータスを確認する。3)コレクションを開始して、希望の形式(JSON、CSV、Parquet)でデータを受信する。

Bright Dataの主な機能

  • 包括的なプロキシネットワーク:195か国にわたる住宅、データセンター、ISP、モバイルネットワークを含む7,200万以上のIPへのアクセス。
  • AI搭載ウェブスクレイピング:複雑なJavaScriptを多用するウェブサイトを処理し、CAPTCHAを解決し、ブラウザのフィンガープリントを自動的に管理できる高度なウェブスクレイパーとスクレイパーIDE。
  • 広大なデータセットマーケットプレイス:主要なeコマース、ソーシャルメディア、不動産、ビジネスインテリジェンスのウェブサイトから事前に収集および検証されたデータセットの巨大なカタログ。
  • スケーラビリティとパフォーマンス:ペタバイト規模のデータを処理するために構築されたインフラストラクチャで、大規模なデータ収集プロジェクトの高い成功率と稼働時間を保証します。
  • データコンプライアンスと倫理:GDPRやCCPAなどのデータ保護法を遵守する業界トップクラスのコンプライアンスにより、倫理的で責任あるデータ収集を保証します。
  • 柔軟なデータ配信:JSON、CSV、Parquetなど、さまざまな形式でクリーンで構造化されたデータを提供し、すぐに分析やモデルトレーニングに使用できます。
  • マネージドサービス:ハンズオフのアプローチを好む企業向けに、Bright Dataは、専門家がデータ収集プロセス全体を代行する完全マネージドデータサービスを提供します。

Bright Dataの使用例

Bright Dataのソリューションは多用途で、幅広いアプリケーションに対応します。

  • AIと機械学習:ウェブ全体から高品質で大規模なデータセットを収集し、機械学習モデルをトレーニングおよび検証します。
  • eコマースと小売インテリジェンス:競合他社の価格を監視し、製品の在庫状況を追跡し、製品データを集約し、顧客レビューを分析して戦略を最適化します。
  • 市場調査:ニュースサイト、フォーラム、ソーシャルメディアからデータを収集して、市場動向を分析し、ブランドのセンチメントを追跡し、包括的な競合他社分析を実行します。
  • 金融サービス:投資分析、リスク評価、財務モデリングのために、公的情報源から代替データを収集します。
  • ブランド保護:知的財産権の侵害、偽造品、ブランド資産の不正使用についてウェブをスキャンします。

Bright Dataの利点

Bright Dataを選択すると、大きな競争上の優位性が得られます。そのオールインワンプラットフォームは、プロキシ、スクレイパー、データセットを1つの屋根の下で提供することにより、複数のベンダーの必要性を統合します。堅牢な検証プロセスのおかげで、データの品質と信頼性は比類のないものです。プラットフォームの計り知れない規模とグローバルなリーチは、どのターゲットも手の届かないものではないことを意味します。重要なことに、Bright Dataの倫理的でコンプライアンスに準拠したデータ収集への強いコミットメントは、複雑な規制環境で事業を行う企業に安心を提供します。開発者に優しいツールと専任のサポートにより、オンボーディングから本番稼働までスムーズな体験が保証されます。

料金プラン

Bright Dataは、さまざまなニーズと規模に合わせて、柔軟な従量課金制の料金モデルと、月次および年次のサブスクリプションプランを提供しています。

  • プロキシネットワーク:料金は通常、トラフィック(GBあたり)またはIPあたりに基づいており、データセンター、住宅、ISP、モバイルプロキシで料金が異なります。プランはスターターパッケージから大規模なエンタープライズ契約までさまざまです。
  • ウェブスクレイパーIDE:使用量に基づいて価格設定され、多くの場合、成功したリクエストの数(CPM)によって計算されます。
  • データセットマーケットプレイス:データセットは、1回限りの購入またはサブスクリプションモデル(月次、四半期、半年ごと)を通じて取得でき、後者は大幅な割引を提供します。価格はレコードごとに計算され(例:1,000レコードあたり2.5ドルから)、データの複雑さと更新頻度によってコストが異なります。
  • サポートプラン:すべての顧客に標準サポートプランが含まれています。強化されたサービスのために、プレミアムおよびエンタープライズプランが利用可能で、24時間年中無休のサポート、専任のアカウントマネージャー、優先対応を提供します。プレミアムプランは月額請求額の8%(最低500ドル/月)、エンタープライズプランは10,000ドル/月です。

詳細でカスタマイズされた価格については、Bright Dataの営業チームに連絡するか、公式の価格ページにアクセスすることをお勧めします。

Crawly

Crawlyは、AIによるデータ抽出のリーダーであるDiffbotによって開発された、強力でインテリジェントなウェブクローラーです。ウェブスクレイピングの手作業や技術的な課題を完全に排除することを目的として設計されています。Crawlyは、複雑なコードを書いたり、ウェブサイトの更新で壊れやすいセレクタを使用したりする代わりに、コンピュータビジョンや自然言語処理を含む高度な人工知能を活用して、人間のようにウェブページを理解し解釈します。これにより、単一のURLを入力するだけで、ウェブサイト全体から完全な構造化データを自動的に識別し抽出することが可能になります。

Crawlyの核心的な約束は、「ウェブサイトを数秒でデータに変える」ことです。ウェブサイト内をナビゲートし、リンクをたどり、各ページの構造を分析して、記事、製品、ディスカッション、画像ギャラリーなどのさまざまなコンテンツタイプを区別します。抽出されたデータは、その後、クリーンで構造化された形式に整理され、アプリケーション、データ分析、または機械学習モデルですぐに使用できる状態になります。

Crawlyの使い方

Crawlyの使い方は、技術的なスキルに関係なく、誰にでも非常にシンプルでアクセスしやすいように設計されています。プロセスはわずか数ステップで完了します:

  1. URLの入力: Crawlyのウェブサイトにアクセスします。提供された入力フィールドに、クロールしたいウェブサイトの完全なURLを入力します。
  2. メールアドレスの提供: あなたのメールアドレスを入力します。これは、クロールが完了した際に通知を受け取り、結果を配信するために使用されます。
  3. クロールの開始: 「Crawl My Website」ボタンをクリックします。CrawlyのAIエンジンがサイト全体のスパイダリングを開始し、ページを分析して情報を抽出します。
  4. データのダウンロード: プロセスが終了すると、抽出されたデータを受け取ります。JSONやCSVなどの便利で構造化された形式でダウンロードでき、データベースやスプレッドシート、その他のソフトウェアに簡単にインポートできます。

Crawlyの主な機能

  • AIによる自動抽出: Diffbotの高度なAIを活用し、手動設定なしで記事、製品、ディスカッションなどからデータを自動的に認識・抽出します。
  • 包括的なデータフィールド: タイトル、テキスト、HTML、コメント、日付、著者、著者URL、画像、動画、発行者情報(国、名前)、言語など、豊富なデータポイントを抽出します。
  • エンティティ認識: テキスト内の人物、組織、場所などのエンティティを自動的に識別してタグ付けし、価値あるメタデータのレイヤーを追加します。
  • フルサイトクロール: 単一ページのスクレイパーとは異なり、Crawlyはウェブサイト全体をナビゲートして包括的にデータを収集します。
  • 構造化データ出力: クリーンで整然としたデータをJSONまたはCSV形式で提供し、後処理やデータクリーニングの必要性を排除します。
  • ノーコードソリューション: プログラミングスキルやウェブスクレイピング技術の知識が不要で、マーケター、研究者、ビジネスアナリストも利用できます。
  • 堅牢性と回復力: コンテンツの意味構造を理解しているため、従来のスクレイパーでよくある問題であるウェブサイトのレイアウト変更によって簡単に壊れることはありません。

Crawlyの使用例

Crawlyは、幅広い用途に適した多目的なツールです:

  • 市場調査: 競合他社の製品情報、価格、顧客レビュー、ニュース記事を自動的に収集し、競争優位性を獲得します。
  • リードジェネレーション: 企業のウェブサイトやオンラインディレクトリから連絡先、企業情報、主要な担当者を抽出します。
  • コンテンツ集約: 複数のソースから記事、ブログ投稿、動画を集約して、カスタムのニュースフィードやコンテンツプラットフォームを構築します。
  • 機械学習用データ: 製品レビューの感情分析やニュース記事のトレンド分析など、機械学習モデルのトレーニング用に大規模で高品質なデータセットを作成します。
  • ブランドモニタリング: ウェブ上で自社のブランド、製品、または経営幹部がどのように言及されているかをリアルタイムで追跡します。

Crawlyの利点

Crawlyの主な利点は、そのシンプルさとパワーです。ウェブデータ抽出を民主化し、通常はエンジニアチームが必要なタスクを非開発者が実行できるようにします。スクレイピングプロセス全体を自動化することで、膨大な時間とリソースを節約します。さらに、AI駆動のアプローチにより、従来の方法よりも高い精度と優れた回復力が保証され、信頼性の高い高品質なデータストリームを提供します。Diffbotの製品であるため、世界中の主要企業から信頼されているエンタープライズグレードの技術に支えられています。

料金プラン

Crawlyは、ホームページから直接無料のトライアルクロールを提供しており、ユーザーはURLとメールアドレスを入力するだけでその機能を試すことができます。これは、ツールが生成できる構造化データのサンプルを提供することを目的としています。大規模なクロール、頻繁なデータ抽出、またはプログラムによる使用のためのAPIアクセスなど、より広範なニーズに対しては、通常、親会社であるDiffbotが提供するツールのフルスイートに登録する必要があります。Diffbotの価格は階層化されており、スタートアップ、ビジネス、大企業向けのプランが用意され、異なるレベルのAPIコールと機能を提供しています。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
ウェブスクレイピングAPI市場調査
のみ Bright Data
ビジネスインテリジェンス
のみ Crawly
自動化

タグ

共通
APIデータ抽出市場調査構造化データWebスクレイピング
のみ Bright Data
AIトレーニングデータオルタナティブデータデータ収集Eコマースデータプロキシ
のみ Crawly
自動化DiffbotJSONリード生成ノーコードウェブクローラー

対象ユーザーと職種

共通
確認済みデータなし
のみ Bright Data
確認済みデータなし
のみ Crawly
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Bright Data monthly traffic:

Latest traffic · 2026-05

月間訪問数
810.9K
平均滞在時間
3:21
訪問あたりページ数
4.77
直帰率
42.51%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 771K
  • 2026-01: 735.5K
  • 2026-02: 714.5K
  • 2026-03: 830.2K
  • 2026-04: 833K
  • 2026-05: 810.9K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States46.92%380.5K
🇨🇳China21.71%176.1K
🇮🇳India13.14%106.6K
🇬🇧United Kingdom10.78%87.4K
🇻🇳Vietnam7.45%60.4K

流入元

Source typePercentageEstimated visits
ダイレクト86.27%699.6K
参照元10.39%84.3K
Eメール3.34%27.1K

検索キーワード

apifybright databrightdatasnapchatwayback machine

Crawly monthly traffic:

Latest traffic · 2026-05

月間訪問数
1.8K
平均滞在時間
0:31
訪問あたりページ数
1.15
直帰率
93.85%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

検索キーワード

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

Bright Data

評価
未確認
コメント
0
お気に入り
140
いいね
156

Crawly

評価
未確認
コメント
0
お気に入り
162
いいね
160

Bright Data vs Crawly · 比較 FAQ

What do Bright Data and Crawly have in common?
Both tools are listed under ウェブスクレイピング、API、市場調査. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Bright Data and Crawly free?
Listed pricing models: Bright Data — Paid; Crawly — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Bright Data and Crawly?
The primary listed category is ビジネスインテリジェンス for Bright Data, and ウェブスクレイピング for Crawly. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較