ToolMage
ログイン

AI TOOL COMPARISON

Browserless vs ScrapingBee

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

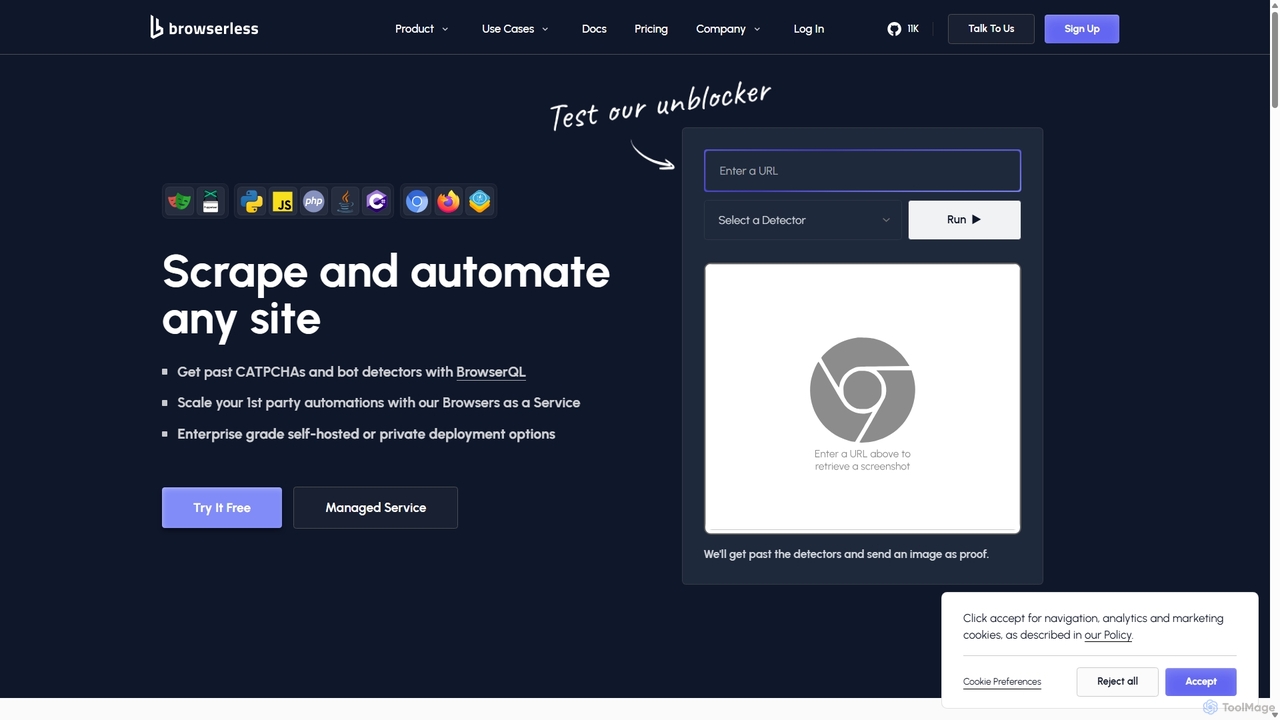
Browserless 製品概要

Browserlessは、スケーラブルなウェブスクレイピングとブラウザ自動化のために設計された強力なBrowser-as-a-Service(BaaS)プラットフォームです。Puppeteer、Playwright、または独自のBrowserQL言語を使用して、開発者がCAPTCHAやボット検出器を簡単に回避できるように支援します。このサービスはブラウザインフラを管理し、ユーザーがアップデート、メモリリーク、スケーリングを心配することなく自動化スクリプトの構築に集中できるようにします。

Preview

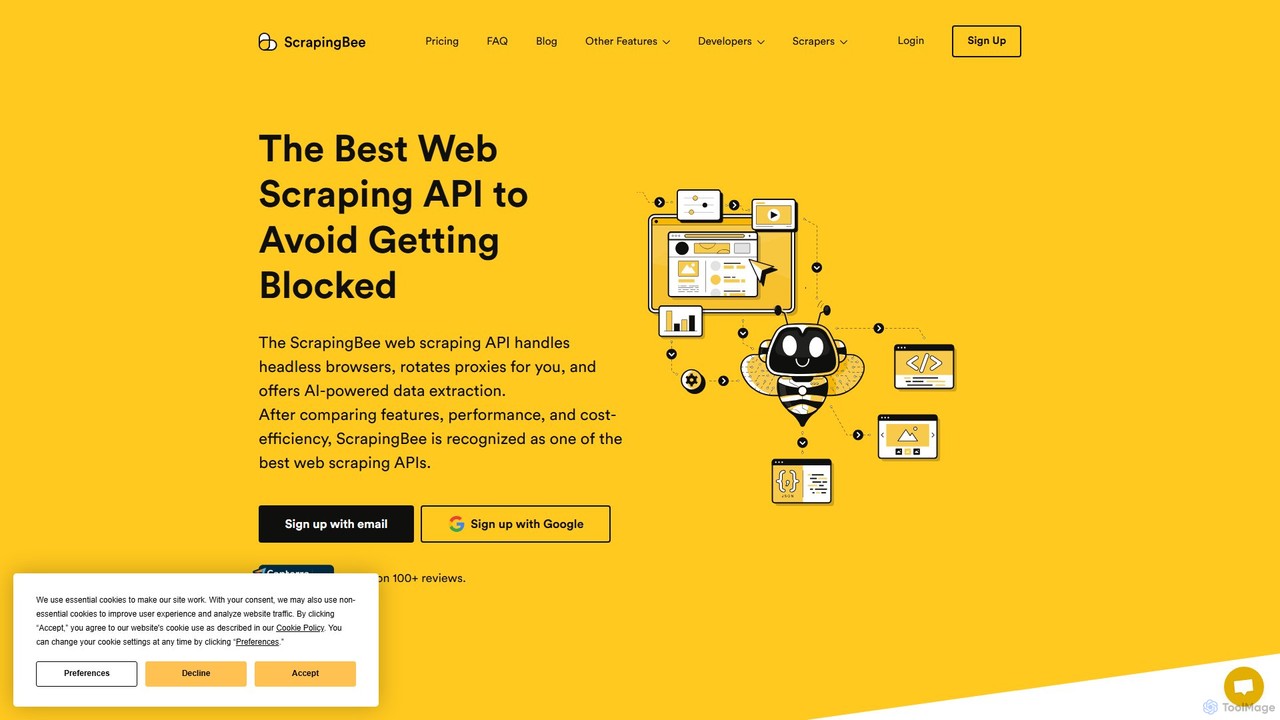
ScrapingBee 製品概要

ScrapingBeeは、ヘッドレスブラウザとプロキシローテーションを処理してブロックを防ぐ強力なウェブスクレイピングAPIです。革新的なAI搭載エクストラクタを備えており、複雑なCSSセレクタを不要にし、平易な英語で必要なデータを記述できます。価格監視、リードジェネレーション、SERP分析などのタスクに、開発者、マーケター、データアナリストにとって理想的です。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Browserless VS ScrapingBee — 基本情報
基本情報BrowserlessScrapingBee
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusデータ抽出データ抽出
対象ユーザーと職種データアナリスト · データサイエンティスト · DevOpsエンジニア · マーケティングマネージャー · プロダクトマネージャー · QAエンジニア · ソフトウェア開発者未確認
カテゴリーデータ抽出 · ウェブスクレイピング · 自動化データ抽出 · ウェブスクレイピング · SEO
Added2025/09/152025/08/07
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Browserless

Browserlessは、幅広いウェブ自動化およびデータ抽出タスクのためにヘッドレスブラウザインスタンスを提供する包括的なクラウドベースのプラットフォームです。インフラ管理、パフォーマンス問題、高度なボット検出システムの回避など、開発者が大規模にヘッドレスブラウザを扱う際に直面する一般的な課題を解決するために構築されました。Browserlessは、堅牢な管理されたブラウザのプールを提供することで、開発者や企業がブラウザ自動化システムの展開や維持の複雑さよりも、コアロジックに集中できるようにします。

このサービスは、その信頼性、スケーラビリティ、高度な機能により、スタートアップから大企業まで何千もの企業に信頼されています。マネージドクラウドサービスとセルフホストのエンタープライズソリューションの両方を提供し、SOC 2 Type IIコンプライアンスを含むさまざまなセキュリティおよびコンプライアンス要件に柔軟に対応します。

Browserlessの使い方

Browserlessは、サービスをワークフローに統合するための複数の方法を提供しており、さまざまなスキルレベルやプロジェクト要件に対応できます。

  1. PuppeteerまたはPlaywrightとの接続: 最も簡単な開始方法は、既存のPuppeteerまたはPlaywrightスクリプトを接続することです。ローカルのブラウザインスタンスを起動する代わりに、接続方法をBrowserlessのWebSocketエンドポイントに変更するだけです。これにより、最小限のコード変更で既存の自動化を即座にスケールできます。
  2. REST APIの使用: PDFの生成、スクリーンショットの取得、HTMLコンテンツの抽出などの一般的なタスクには、BrowserlessがシンプルなREST APIを提供します。複雑なブラウザ自動化スクリプトを記述することなく、cURLリクエストや任意のHTTPクライアントを使用してこれらの操作を実行できます。
  3. BrowserQLの活用: 高度なユースケース、特にCloudflareのような厳しいボット検出器を回避する必要がある場合には、BrowserlessがBrowserQLを提供します。これは、最小限のフィンガープリントを残すように設計された次世代の自動化言語およびIDEです。簡潔なクエリを記述して、ボタンのクリック、CAPTCHAの解決、構造化データの抽出などの複雑なアクションを実行しながら、検出システムに対してより人間らしく見せることができます。
  4. ハイブリッド自動化: Browserlessは、ブラウザセッションをiframeにストリーミングするハイブリッドワークフローをサポートしています。これは、自動化スクリプト内で複雑なCAPTCHAを解決したり、2FAコードを入力したり、OAuthログインを処理したりするなど、手動介入が必要なタスクに役立ちます。

Browserlessの主な機能

  • BrowserQL: ブラウザのフィンガープリントを最小限に抑えることで、最先端のボット検出器を回避するためにゼロから構築された独自のクエリ言語およびIDE。
  • Browser as a Service (BaaS): バージョンアップデート、負荷分散、リソース管理など、すべてのインフラストラクチャ側面を処理する、何千ものブラウザからなるスケーラブルな管理プール。
  • ボット検出とCAPTCHA回避: CAPTCHA(reCAPTCHA、hCaptcha)を自動的に解決し、Cloudflareなどのボットブロッキングサービスを通過するための特殊技術。
  • PuppeteerとPlaywrightの統合: 最も人気のある2つのブラウザ自動化ライブラリとのシームレスな互換性。
  • REST API: PDF生成、スクリーンショット、コンテンツスクレイピングなどの一般的なタスクのためのシンプルなエンドポイント。
  • セッション管理と再接続: ブラウザセッションを維持し、再接続する機能。これにより、プロキシの使用量が大幅に削減され、繰り返しのボットチェックが回避されます。
  • エンタープライズグレードのソリューション: セルフホスト、プライベートクラウド展開、カスタムマシン設定(GPUを含む)、SSO、専用サポート、SOC 2 Type IIコンプライアンスのオプション。
  • 監視とデバッグ: リクエスト、ワーカーの健全性(CPU/メモリ)に関するメトリクス、およびスクリプトの実行をリアルタイムで監視するためのデバッガを提供するユーザーフレンドリーなダッシュボード。

Browserlessの使用例

Browserlessは多用途であり、多くのシナリオに適用できます。

  • ウェブスクレイピングとデータ抽出: 動的でJavaScriptを多用するウェブサイト、eコマースプラットフォーム(例:Walmart、eBay)、不動産リスト(Zillow)、求人掲示板(Indeed)からのデータ収集。
  • 自動ソフトウェアテスト: 複雑なSelenium Gridを管理することなく、Laravel Duskなどのフレームワークと統合して、ウェブアプリケーションのエンドツーエンドテストを大規模に実行。
  • AIとLLMのデータ取り込み: AIエージェント(例:LangChainやCrewAIを使用)にリアルタイムのウェブアクセスを提供し、大規模言語モデルのトレーニングや自動調査のための新しいデータを収集。
  • レポート生成: ウェブアプリケーションからダッシュボード、分析レポート、請求書のPDFやスクリーンショットを自動的に生成。
  • 価格と競合他社の監視: さまざまなオンライン小売業者における製品価格、在庫レベル、競合他社の戦略を追跡。

Browserlessの利点

Browserlessを使用することには、いくつかの重要な利点があります。

  • 運用オーバーヘッドの削減: 複雑なブラウザ自動化インフラを構築、展開、維持するための専門チームが不要になります。
  • 成功率の向上: 特にBrowserQLを使用した高度なボット回避技術により、保護されたウェブサイトのスクレイピングにおける成功率が高まります。
  • オンデマンドのスケーラビリティ: 数セッションから数千セッションまで簡単にスケールし、パフォーマンスを低下させることなくトラフィックの急増に対応します。
  • コスト効率: セッション再接続などの機能により、プロキシコストを最大90%削減できます。ユニットベースの価格設定モデルは予測可能で費用対効果が高いです。
  • 開発者中心: 優れたドキュメント、SDK、迅速な技術サポートを備え、開発者のために開発者によって設計されています。

料金プラン

Browserlessは、さまざまなニーズに合わせて柔軟なユニットベースの料金モデルを提供しています。

  • 無料プラン: 月間1,000ユニット、最大1同時ブラウザ、BrowserQLエディタへのアクセスが含まれます。クレジットカードは不要です。
  • プロトタイピングプラン: 月額25ドル(年間請求)からで、20,000ユニットと3同時ブラウザを提供します。小規模プロジェクトやテストに最適です。
  • スタータープラン: 月額140ドル(年間請求)からで、180,000ユニットと20同時ブラウザを提供し、成長中のアプリケーションに適しています。
  • スケールプラン: 月額350ドル(年間請求)からで、500,000ユニットと50同時ブラウザを提供し、大量の操作向けに設計されています。
  • エンタープライズプラン: 数百万ユニット、プライベート展開、セルフホスト、GPUインフラなどの高度な機能、SSO、専任のテクニカルアカウントマネージャーを必要とするユーザー向けのカスタム価格。

「ユニット」は最大30秒のブラウザ時間に対応します。より長いセッションは追加のユニットを消費します。ユニットは、レジデンシャルプロキシや成功したCAPTCHA解決にも使用されます。

ScrapingBee

ScrapingBeeは、ウェブからのデータ抽出という複雑なプロセスを簡素化するために設計された、包括的なウェブスクレイピングAPIです。IPブロック、レート制限、動的でJavaScriptを多用するウェブサイトの処理など、ウェブスクレイピングにおける最も一般的な課題に効果的に対処します。ヘッドレスChromeブラウザのフリートと広大なローテーションプロキシプールを管理することで、ScrapingBeeは開発者や企業がスクレイパーのメンテナンスの複雑さではなく、データ分析に集中できるようにします。その際立った特徴は、AI搭載のデータエクストラクタであり、ユーザーが自然言語でデータ要件を指定できるため、プロセスがより直感的になり、ウェブサイトのレイアウト変更に対してより強靭になります。

ScrapingBeeの使い方

ScrapingBeeの使い方は簡単で、開発者の効率を考慮して設計されています。プロセスは、APIキーを取得するための簡単なサインアップから始まります。キーを取得したら、ScrapingBeeエンドポイントにAPIリクエストを送信できます。
1. エンドポイントの選択:一般的なスクレイピングの場合、ターゲットURLをパラメータとしてAPIにGETリクエストを送信します。
2. JavaScriptレンダリングの有効化:React、Vue.js、Angularで構築されたシングルページアプリケーション(SPA)をスクレイピングするには、リクエストに`render_js=True`パラメータを追加するだけです。これにより、ScrapingBeeはHTMLを返す前に、実際のChromeブラウザでページをレンダリングします。
3. AI抽出の使用:最も簡単なデータ抽出には、AI抽出機能を使用します。必要なデータフィールドを平易な英語で記述します(例:「製品のタイトル、価格、顧客レビューを抽出」)。AIがページを解析し、CSSセレクタを記述することなく構造化されたJSONデータを返します。
4. カスタムスクリプトの実行:ボタンのクリック、スクロール、要素の読み込み待機などの複雑なインタラクションには、`js_scenario`パラメータを使用してカスタムJavaScriptスニペットを渡すことができます。
5. スクリーンショットの撮影:`screenshot=True`パラメータを追加して、ターゲットウェブサイトのフルページまたは部分的なスクリーンショットをキャプチャします。
6. Googleのスクレイピング:専用のGoogle検索APIエンドポイントを使用して、レート制限に直面することなく検索エンジン結果ページ(SERP)を簡単にスクレイピングします。

ScrapingBeeの主な機能

  • AI搭載の抽出:必要なデータを平易な英語で記述します。AIがインテリジェントに関連情報を識別し、構造化されたJSON形式で抽出し、ウェブサイトのレイアウト変更に自動的に適応します。
  • ヘッドレスブラウザレンダリング:最新バージョンのChromeを利用して、JavaScriptを多用するウェブサイトをレンダリングし、動的ページやシングルページアプリケーションから完全なHTMLコンテンツを取得できるようにします。
  • 自動プロキシローテーション:大規模な住宅用およびデータセンタープロキシプールを活用して、リクエストごとにIPアドレスを自動的にローテーションし、ブロックされたりレート制限されたりする可能性を大幅に低減します。
  • ジオターゲティング:リクエストの国を指定して、地理的に制限されたコンテンツにアクセスし、ローカルユーザーのようにウェブサイトを閲覧します。
  • カスタムJavaScriptシナリオ:ターゲットページでカスタムJavaScriptコードを実行して、クリック、スクロール、フォーム送信、特定の要素の出現待機などの複雑なインタラクションを処理します。
  • SERPスクレイピングAPI:一般的な障害を回避して、Google検索結果ページを効率的かつ確実にスクレイピングするための専用APIです。
  • スクリーンショットAPI:APIを介して直接、任意のウェブサイトの高品質なフルページまたは部分的なスクリーンショットをキャプチャします。

ScrapingBeeの使用例

ScrapingBeeは多機能で、2,500以上のお客様から幅広いアプリケーションで信頼されています。
- Eコマースと価格監視:小売業者や市場アナリストは、ScrapingBeeを使用して競合他社の価格を追跡し、在庫レベルを監視し、何千ものEコマースサイトから製品詳細を収集します。
- リードジェネレーション:営業およびマーケティングチームは、プロフェッショナルネットワーク、オンラインディレクトリ、企業ウェブサイトをスクレイピングして、ターゲットを絞ったリードリストを作成します。
- SEOとSERP分析:SEO専門家は、Google検索APIを使用してキーワードランキングを追跡し、SERP機能を分析し、競合他社のオンラインプレゼンスを監視します。
- 不動産データ集約:代理店や投資家は、不動産リスティングをスクレイピングして、さまざまなプラットフォームにわたる物件価格、空室状況、特徴に関するデータを収集します。
- 学術および市場調査:研究者やジャーナリストは、論文やブログ記事のデータ収集など、さまざまなウェブソースから研究、レポート、コンテンツ作成のためのデータを抽出します。

ScrapingBeeの利点

ScrapingBeeの主な利点は、ウェブスクレイピングの最も困難な部分を抽象化できることです。ユーザーはもはや独自のプロキシインフラストラクチャやヘッドレスブラウザフリートを管理する必要がなくなり、大幅な時間、リソース、メンテナンスのオーバーヘッドを節約できます。AI抽出機能は大きな差別化要因であり、スクレイパーの構築を容易にし、ウェブサイトの更新に対してより堅牢にします。APIはドキュメントが整備されており、統合が容易で、厳重に保護されたサイトでも高い成功率を提供します。さらに、失敗したリクエストには課金されない「成功報酬」モデルと優れたカスタマーサポートにより、信頼性が高く費用対効果の高いソリューションとなっています。

料金プラン

ScrapingBeeは、さまざまなニーズに適した透明性の高い階層型料金体系を提供しており、いつでもキャンセル可能です。すべてのプランには、1,000 APIコールの無料トライアルが付いています(クレジットカードは不要です)。
- フリーランスプラン:月額49ドルから。このプランには250,000 APIクレジットと10の同時リクエストが含まれ、個人の開発者や小規模プロジェクトに最適です。
- スタートアッププラン:月額99ドルで、1,000,000 APIクレジットと50の同時リクエストを提供し、成長中のビジネスに適しています。
- ビジネスプラン:月額249ドルで、ユーザーは3,000,000 APIクレジットと100の同時リクエストを取得でき、より高いスクレイピング需要を持つ確立された企業向けに設計されています。
- ビジネス+プラン:月額599ドルで、このプランは8,000,000 APIクレジットと200の同時リクエストを提供します。
すべての有料プランには、JavaScriptレンダリング、ローテーション&プレミアムプロキシ、ジオターゲティングが含まれています。上位プランでは、優先メールサポートと専任のアカウントマネージャーが提供されます。より多くのクレジットと同時実行性が必要なユーザー向けに、カスタムエンタープライズプランが利用可能です。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
データ抽出ウェブスクレイピング
のみ Browserless
自動化
のみ ScrapingBee
SEO

タグ

共通
APIデータ抽出データマイニングヘッドレスブラウザWebスクレイピング
のみ Browserless
ボット検出ブラウザ自動化キャプチャ解決プレイライトパペッティア
のみ ScrapingBee
AIデータ抽出JavaScript レンダリングプロキシローテーションSERPスクレイピング

対象ユーザーと職種

共通
確認済みデータなし
のみ Browserless
データアナリストデータサイエンティストDevOpsエンジニアマーケティングマネージャープロダクトマネージャーQAエンジニアソフトウェア開発者
のみ ScrapingBee
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Browserless monthly traffic:

Latest traffic · 2026-05

月間訪問数
242.1K
平均滞在時間
1:17
訪問あたりページ数
2.45
直帰率
56.01%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 126.9K
  • 2026-01: 150.9K
  • 2026-02: 150.8K
  • 2026-03: 157.8K
  • 2026-04: 148.9K
  • 2026-05: 242.1K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇧🇷Brazil28.09%68K
🇺🇸United States26.55%64.3K
🇨🇭Switzerland23.8%57.6K
🇨🇦Canada11.55%28K
🇪🇸Spain10.01%24.2K

流入元

Source typePercentageEstimated visits
ダイレクト81.79%198K
参照元13.74%33.3K
Eメール4.47%10.8K

検索キーワード

browserlessbrowserless apibrowserless iomemory leak fixplaywright vs selenium

ScrapingBee monthly traffic:

Latest traffic · 2026-05

月間訪問数
258.2K
平均滞在時間
1:12
訪問あたりページ数
2.25
直帰率
44.5%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 218.3K
  • 2026-01: 287.2K
  • 2026-02: 262.7K
  • 2026-03: 265.2K
  • 2026-04: 241.2K
  • 2026-05: 258.2K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States56.95%147.1K
🇮🇳India16.81%43.4K
🇲🇦Morocco9.66%24.9K
🇷🇺Russia8.62%22.3K
🇫🇷France7.96%20.6K

流入元

Source typePercentageEstimated visits
ダイレクト83.54%215.7K
参照元11.93%30.8K
Eメール4.53%11.7K

検索キーワード

scrapflyscraping beescrapingbeescraplingserpapi

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

Browserless

評価
未確認
コメント
0
お気に入り
178
いいね
165

ScrapingBee

評価
未確認
コメント
0
お気に入り
169
いいね
190

Browserless vs ScrapingBee · 比較 FAQ

What do Browserless and ScrapingBee have in common?
Both tools are listed under データ抽出、ウェブスクレイピング. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Browserless and ScrapingBee free?
Listed pricing models: Browserless — Freemium; ScrapingBee — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Browserless and ScrapingBee?
The primary listed category is データ抽出 for Browserless, and データ抽出 for ScrapingBee. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較