ToolMage
ログイン

AI TOOL COMPARISON

Diffbot vs Hyperbrowser

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

Diffbot 製品概要

Diffbotは、非構造化ウェブを巨大な構造化知識グラフに変換するAI搭載プラットフォームです。ウェブデータ抽出、クローリング、自然言語処理のためのAPIを提供し、企業が金融、マーケットインテリジェンス、リスク管理などのアプリケーションのために、組織、ニュース、製品などに関するクリーンで整理されたデータにアクセスできるようにします。

Preview

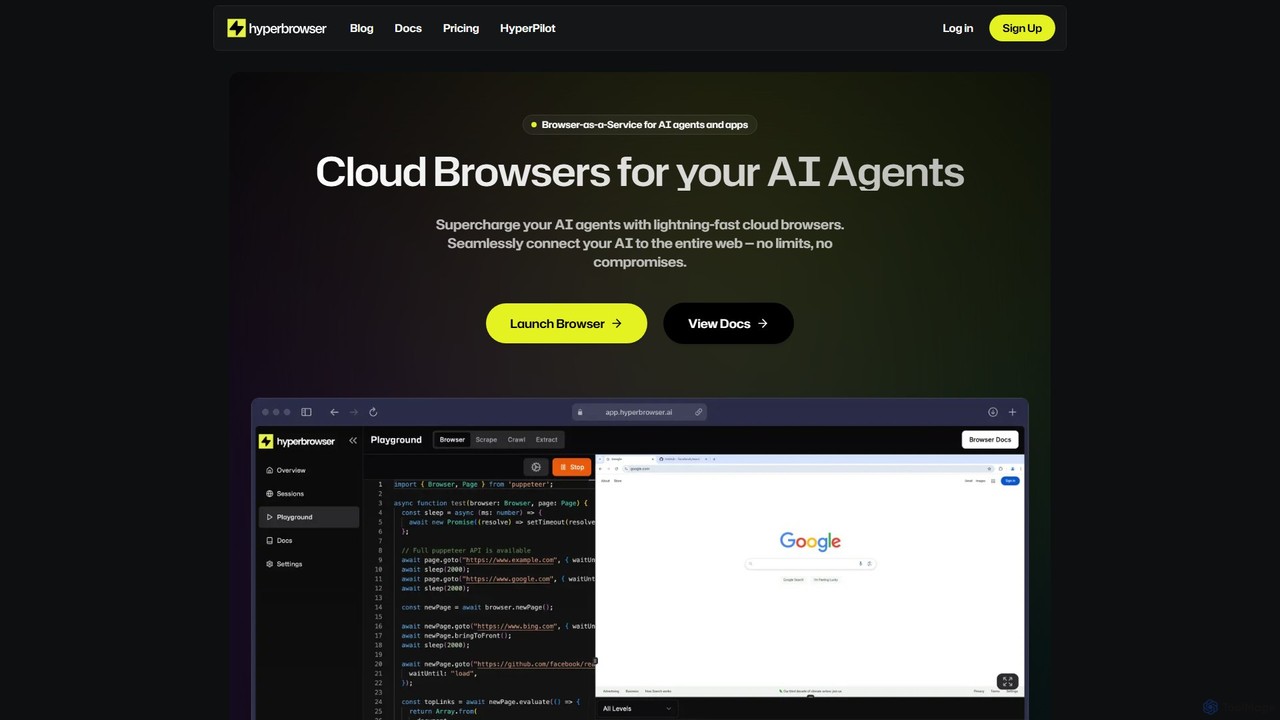
Hyperbrowser 製品概要

Hyperbrowserは、AIエージェントと開発者向けに設計されたBrowser-as-a-Service(BaaS)プラットフォームです。スケーラブルで超高速なクラウドブラウザを提供し、ウェブタスクの自動化、データ抽出、AI駆動のウェブインタラクションを可能にします。ステルスブラウジング、自動キャプチャ解決、開発者フレンドリーなAPIなどの機能により、複雑なワークフローを制限なく強化します。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Diffbot VS Hyperbrowser — 基本情報
基本情報DiffbotHyperbrowser
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focus市場情報ウェブスクレイピング
対象ユーザーと職種未確認未確認
カテゴリー市場情報 · ウェブスクレイピング · API · 自動化ウェブスクレイピング · API · 自動化
Added2025/08/092025/08/05
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Diffbot

Diffbotは、公開ウェブのコンテンツを理解し、構造化するために設計されたAI搭載ツールスイートを提供し、それを効果的に世界最大かつ最も包括的なデータベースに変えます。その中核となるのは、組織、人物、記事、製品などに関する相互接続された巨大なデータリポジトリであるDiffbotナレッジグラフです。各ウェブサイトに手動のルールを必要とする従来のウェブスクレイパーとは異なり、Diffbotはコンピュータビジョンと自然言語処理を使用して、人間のようにウェブページを自動的に解釈し、サイト固有の設定なしで構造化データを抽出します。

この技術により、開発者や企業はウェブデータのノイズが多く混沌とした性質と格闘するのをやめ、代わりにクリーンで構造化されたデータベースであるかのようにアクセスできます。ニュースの監視、顧客プロファイルの強化、市場調査の実施、機械学習モデルの強化など、どのようなニーズがあっても、Diffbotはインテリジェントなアプリケーションを構築するために必要なクリーンで信頼性の高いデータフィードを提供します。

Diffbotの使い方

開発者やデータチームがDiffbotを使い始めるのは簡単です。主なインタラクションは、その強力なAPIを介して行われます。

  1. サインアップ:アカウントを作成して開始します。Diffbotは10,000クレジットと完全なAPIアクセスを含む無料プランを提供しており、クレジットカードなしでプラットフォームの機能をテストできます。
  2. APIトークンの取得:登録すると、ダッシュボードからAPIトークンが発行されます。このトークンは、Diffbot APIへのすべてのリクエストを認証するために使用されます。
  3. 適切なAPIの選択:Diffbotは、さまざまなタスクに対応するいくつかの異なるAPIを提供しています。
    • Extract API:記事、製品ページ、フォーラムのディスカッションなどの任意のURLを指定すると、構造化されたJSONデータを自動的に返します。ルールは不要です。
    • Crawl API:開始URLを提供すると、Diffbotはサイト全体を体系的にクロールし、Extract APIを使用して関連するすべてのページを構造化データに変換します。これは、特定のウェブサイトからデータベースを構築するのに理想的です。
    • Knowledge Graph Search API:事前に構築されたナレッジグラフをクエリして、2億4600万以上の組織、16億以上の記事などの情報を検索します。エンティティを検索し、正確なデータフィードを構築できます。
    • Knowledge Graph Enhance API:会社名などの独自のデータを提供すると、Diffbotは収益、従業員数、ソーシャルプロファイル、最新ニュースなど、ナレッジグラフの包括的なデータでそれを強化します。
    • Natural Language API:生のテキストを送信して、エンティティ、それらの関係を推論し、感情分析を実行します。
  4. 統合と構築:APIレスポンス(JSON形式)を使用して、アプリケーションを強化したり、データベースに入力したり、分析ダッシュボードにデータを提供したりします。リアルタイムのニーズには、特定の会社に言及する新しい記事などの即時通知のためにウェブフックを設定できます。

Diffbotの主な機能

  • ナレッジグラフ:組織、人物、製品、記事、およびそれらの関係に関する構造化情報を含む、事前にクロールされ、継続的に更新される巨大なウェブグラフ。
  • 自動抽出:手動の設定やルールを必要とせずに、さまざまなページタイプ(記事、製品、ディスカッションなど)から主要な情報を自動的に識別して抽出するAI駆動の技術。
  • Crawlbot:ウェブサイト全体を構造化データベースに変換できるインテリジェントなウェブクローラーで、関連ページからコンテンツを自動的に識別して抽出します。
  • 自然言語処理(NLP):20以上の言語でテキストを理解し、エンティティ認識(「Apple」社と「apple」果物の区別)を実行し、トピックレベルで感情分析を行う高度なNLP機能。
  • データエンリッチメント(Enhance API):会社名やメールアドレスなどの最小限の情報を取得し、ナレッジグラフの数十のデータポイントでそれを強化する機能。
  • リアルタイムモニタリング:正確なエンティティマッチングと感情分析により、ニュースやブランドの言及に関するカスタムでノイズのないフィードを構築し、メールやウェブフックでリアルタイムのアラートを受け取ります。

Diffbotの使用例

Diffbotの構造化データは、多くの業界や機能で価値があります。

  • マーケットインテリジェンス:グローバルニュース、企業ファイリング、製品データを活用して、競合他社を追跡し、業界の動向を監視し、市場の動きを分析します。
  • リスクとコンプライアンス:企業や個人に対するデューデリジェンスを実施し、サプライチェーンのリスクシグナルを監視し、規制の変更に先んじます。
  • 営業とマーケティング:CRMのリードデータを強化し、特定の基準(例:特定の業界で資金調達したばかりの会社)に基づいて新しい見込み客を特定し、アウトリーチをパーソナライズします。
  • ニュースとメディアモニタリング:正確なエンティティマッチングと感情分析により、ブランド、人物、またはトピックの言及を追跡する、非常に具体的なリアルタイムのニュースフィードを作成します。
  • 採用:潜在的な候補者のデータベースを構築し、人材を特定し、ウェブ全体のデータで専門的なプロファイルを強化します。
  • 機械学習:ナレッジグラフを、さまざまなAIおよび機械学習モデルのための高品質で構造化されたトレーニングデータソースとして使用します。

Diffbotの利点

Diffbotの主な利点は、ウェブ全体を単一のクエリ可能なデータベースとして扱えることです。ウェブスクレイピングとデータクリーニングの複雑さを抽象化します。主な利点には、正確性、スケーラビリティ、効率性が含まれます。ユーザーは、脆弱でサイト固有のスクレイパーを構築・維持する代わりに、単一の堅牢なAPIに依存できます。エンティティを認識するNLPはデータの品質と関連性を保証し、事前に構築されたナレッジグラフは、社内で構築するには何年もかかるであろう膨大なデータセットへの即時アクセスを提供します。

料金プラン

Diffbotは、趣味のプロジェクトから大企業まで、さまざまな使用レベルに対応するための階層的な料金体系を提供しています。

  • 無料プラン:月額$0。10,000クレジット、完全なAPIアクセスが含まれ、永久に無料です。テストや小規模プロジェクトに最適です。
  • スタートアッププラン:月額$299。250,000クレジットが含まれ、プラグアンドプレイのスクレイピングとナレッジグラフアクセスが必要な小規模チーム向けに設計されています。
  • プラスプラン:月額$899。1,000,000クレジット、Crawl製品へのアクセス、より高いAPIコールレートが含まれます。より大きなデータニーズを持つ成長中のビジネスに適しています。
  • エンタープライズプラン:カスタム価格。大規模なデータ操作向けに、カスタムクレジット割り当て、最高のAPIコールレート、プレミアムSLAサポート、マネージドソリューションを備えたオーダーメイドのプランを提供します。

クレジットは、APIコールの種類と複雑さに応じて消費されます。詳細な内訳はウェブサイトで確認できます。

Hyperbrowser

Hyperbrowserは、AIエージェントとアプリケーションをウェブ全体に接続するために構築された、強力なBrowser-as-a-Service(BaaS)プラットフォームです。開発者に高速で安全、かつスケーラブルなクラウドブラウザのフリートへのアクセスを提供し、ローカルのブラウザインスタンスを管理する複雑さを解消します。このサービスは、大規模なウェブスクレイピング、ブラウザの自動化、洗練されたAIエージェントが人間のようにウェブサイトと対話できるようにするなど、要求の厳しいタスクに特化して設計されています。分離されたコンテナでヘッドレスブラウザを提供することにより、Hyperbrowserは、単純なデータ抽出から複雑でミッションクリティカルな自動化ワークフローまで、あらゆるプロジェクトで信頼性、セキュリティ、および最高のパフォーマンスを保証します。

Hyperbrowserの使い方

Hyperbrowserの利用開始は、開発者向けに設計された簡単なプロセスです。まず、ウェブサイトでサインアップしてアカウントを作成し、一意のAPIキーを取得します。クレジットカード不要の寛大な無料プランから始めることができます。キーを取得したら、PythonおよびNodeJS向けの使いやすいSDKを使用するか、APIに直接cURLリクエストを送信することで、Hyperbrowserをアプリケーションに統合できます。プラットフォームは、OpenAI ToolsやAnthropic Toolsなどの人気のあるAIフレームワークとの統合を含む、明確なドキュメントとコード例を提供します。たとえば、ブラウザセッションを起動し、AIエージェントにタスク(例:「DoordashでBurma Loveのガーリックヌードルを注文する」)を割り当て、Hyperbrowserにウェブインタラクション全体を管理させ、構造化された結果を返させることができます。

Hyperbrowserの主な機能

  • スケーラブルなクラウドブラウザ:パフォーマンスの低下なしに1,000以上の同時ブラウザを実行し、500ms未満で起動して即座にスケーリングします。
  • 高度なブラウザ自動化:複雑なウェブスクレイピング、自動テスト、複数のサイトにわたるフォーム入力など、あらゆるブラウザベースのタスクを自動化します。
  • AIエージェント統合:OpenAIやAnthropicなどのフレームワークのAIエージェントとシームレスに接続し、ウェブの閲覧、データ収集、ウェブアプリケーションとの対話によるタスク完了を可能にします。
  • 自動キャプチャ解決:統合されたキャプチャ処理機能が、さまざまな種類のキャプチャ(reCAPTCHAを含む)を自動的に解決し、自動化ワークフローが中断なく実行されることを保証します。
  • ステルスブラウジング:高度なステルスモードで動作し、洗練されたボット検出システムを回避して、データ収集と自動化タスクの高い成功率を確保します。
  • 堅牢なセッション管理:ロギング、デバッグ、安全なリソース分離、繰り返しログインを避けるためのユーザープロファイルの再利用などの機能でブラウザセッションを管理します。
  • 開発者フレンドリーなAPI:PythonおよびNodeJS向けの公式SDKを備えたシンプルで強力なAPIにより、既存の技術スタックへの統合がスムーズかつ効率的になります。

Hyperbrowserの使用例

Hyperbrowserは多用途であり、幅広いシナリオに適用できます。主な使用例には、大規模なウェブスクレイピングがあり、ユーザーはブロックされることなくGoogle検索結果やShopifyなどのeコマースサイトから数百万ページのデータを抽出・構造化できます。もう一つの重要な応用は、AIウェブエージェントの動力源となり、予約、購入、詳細な競合分析などの複雑なアクションを実行できるようにすることです。また、自動ソフトウェアテストにも非常に価値があり、開発者は実際のブラウザ環境で大規模なエンドツーエンドテストを実行できます。さらに、企業は競合他社の価格、製品、マーケティング戦略に関するデータ収集を自動化することで、市場調査と競合分析に利用しています。

Hyperbrowserの利点

Hyperbrowserの主な利点は、スケーラブルで信頼性が高く、検出不可能なブラウザ自動化を提供する能力です。プラットフォームは99.9%の稼働時間を保証し、ミッションクリティカルなアプリケーションに適しています。その超高速、サブ秒のブラウザ起動時間は、オンデマンドでの迅速なスケーリングを可能にします。組み込みのフォールトトレランスと自動回復メカニズムにより、ワークフローは回復力があり信頼性が高くなります。最も重要なのは、その高度なステルス機能と自動キャプチャ解決が、ボット対策によってブロックされる可能性のあるウェブ自動化タスクの成功率を大幅に向上させることです。

料金プラン

Hyperbrowserは、さまざまなニーズに合わせてフリーミアムモデルを備えた、柔軟で透明性の高い料金体系を提供しています。
無料プラン:月額$0、1,000クレジット、同時ブラウザ1台、7日間のデータ保持、基本ステルスモードが含まれます。
スタートアッププラン:月額$30(+従量課金)、30,000クレジット、同時ブラウザ25台、30日間のデータ保持、自動キャプチャ解決、基本ステルスモードが含まれます。
スケールプラン:月額$100(+従量課金)、100,000クレジット、同時ブラウザ100台、30日間のデータ保持、自動キャプチャ解決、高度ステルスモードが含まれます。
エンタープライズプラン:大量利用向けのカスタム価格設定。250台以上の同時ブラウザ、180日以上のデータ保持、プレミアムサポート、HIPAA/SOC 2などのコンプライアンスオプションを提供します。
使用量は、クレジットあたり$0.001、ブラウザ時間あたり$0.10、プロキシデータGBあたり$10で請求されます。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
ウェブスクレイピングAPI自動化
のみ Diffbot
市場情報
のみ Hyperbrowser
確認済みデータなし

タグ

共通
APIデータ抽出開発者ツールWebスクレイピング
のみ Diffbot
ビジネスインテリジェンスデータエンリッチメント知識グラフ市場インテリジェンス自然言語処理ニュースモニタリングウェブクローリング
のみ Hyperbrowser
AIエージェントブラウザ自動化キャプチャ解決ヘッドレスブラウザステルスブラウジング

対象ユーザーと職種

共通
確認済みデータなし
のみ Diffbot
確認済みデータなし
のみ Hyperbrowser
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Diffbot monthly traffic:

Latest traffic · 2026-05

月間訪問数
47.2K
平均滞在時間
0:36
訪問あたりページ数
2.02
直帰率
38.73%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 65.5K
  • 2026-01: 49.6K
  • 2026-02: 69.2K
  • 2026-03: 61.7K
  • 2026-04: 44.6K
  • 2026-05: 47.2K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States31.36%14.8K
🇳🇬Nigeria28.45%13.4K
🇮🇳India20.17%9.5K
🇬🇧United Kingdom11.29%5.3K
🇵🇰Pakistan8.73%4.1K

流入元

Source typePercentageEstimated visits
ダイレクト89.5%42.2K
参照元8.3%3.9K
Eメール2.2%1K

検索キーワード

crawlydifbotdiffbotdiffbot apiwebsite content extractor

Hyperbrowser monthly traffic:

Latest traffic · 2026-05

月間訪問数
71.4K
平均滞在時間
0:38
訪問あたりページ数
2.21
直帰率
40.26%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 34.5K
  • 2026-01: 71.4K
  • 2026-02: 66.8K
  • 2026-03: 67.3K
  • 2026-04: 56.7K
  • 2026-05: 71.4K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States43.97%31.4K
🇮🇳India28.23%20.2K
🇻🇳Vietnam12.18%8.7K
🇧🇷Brazil8.2%5.9K
🇩🇪Germany7.42%5.3K

流入元

Source typePercentageEstimated visits
ダイレクト91.73%65.5K
参照元7.22%5.2K
Eメール1.05%750

検索キーワード

hyper agenthyperagenthyper browserhyperbrowserhyperbrowser ai

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

Diffbot

評価
未確認
コメント
0
お気に入り
196
いいね
188

Hyperbrowser

評価
未確認
コメント
0
お気に入り
153
いいね
162

Diffbot vs Hyperbrowser · 比較 FAQ

What do Diffbot and Hyperbrowser have in common?
Both tools are listed under ウェブスクレイピング、API、自動化. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Diffbot and Hyperbrowser free?
Listed pricing models: Diffbot — Freemium; Hyperbrowser — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Diffbot and Hyperbrowser?
The primary listed category is 市場情報 for Diffbot, and ウェブスクレイピング for Hyperbrowser. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較