ToolMage
ログイン

AI TOOL COMPARISON

Elementary Data vs Lilac

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

Elementary Data 製品概要

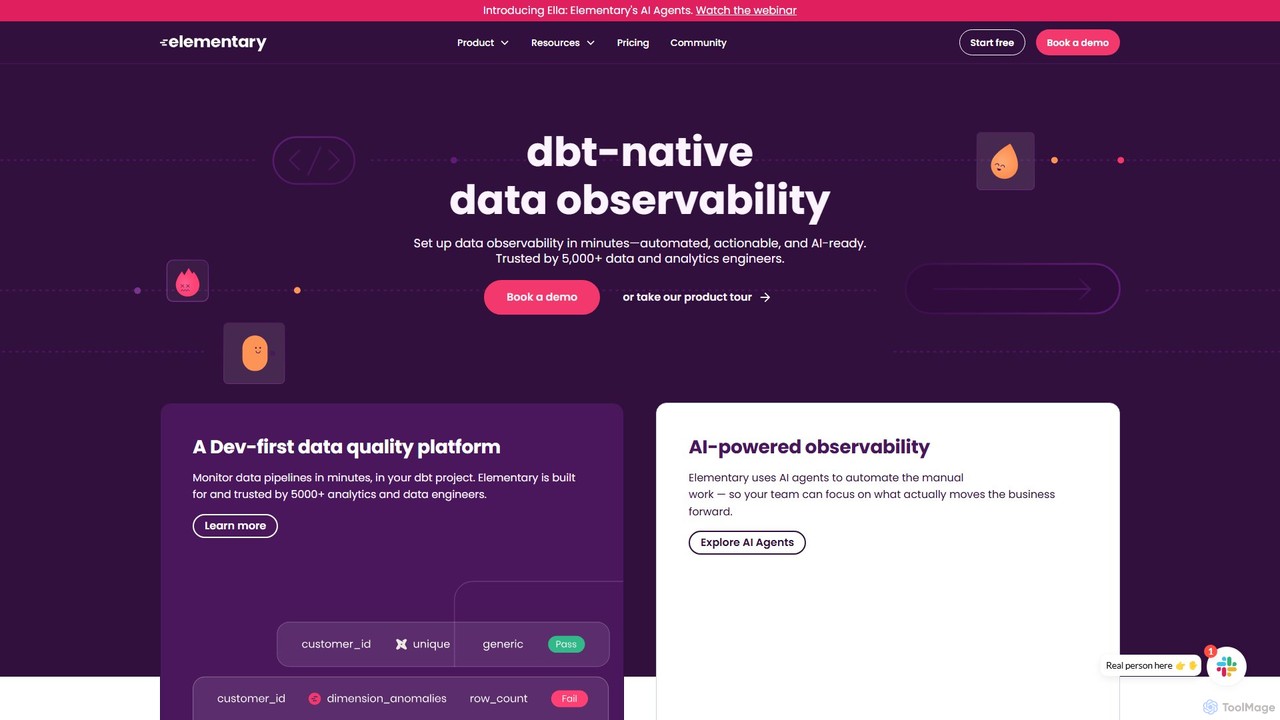
Elementary Dataは、データおよび分析エンジニア向けに設計されたdbtネイティブのデータオブザーバビリティプラットフォームです。AIエージェントを使用してデータ品質の監視を自動化し、異常を検出し、エンドツーエンドのデータリネージを提供します。このプラットフォームは、チームがアラートノイズを削減し、インシデントを迅速に解決し、AIおよび分析アプリケーションのデータへの信頼を構築するのに役立ちます。

Preview

Lilac 製品概要

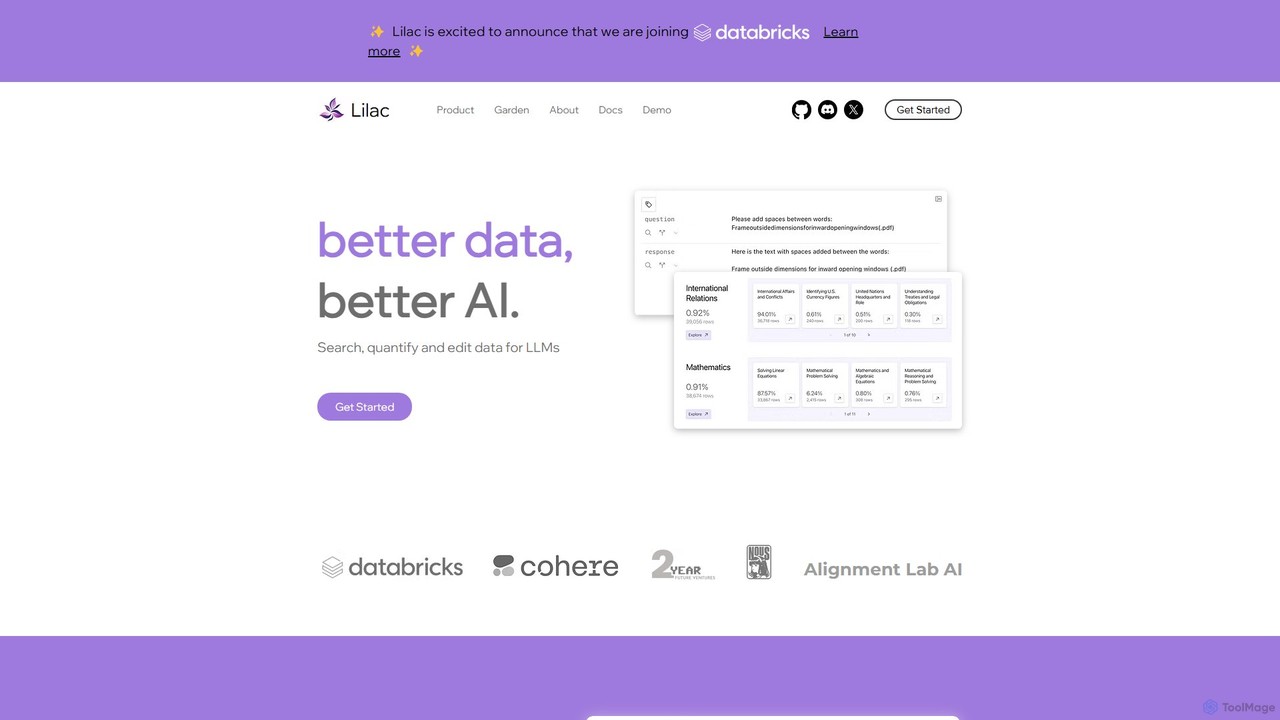
Lilacは、データサイエンティストやMLエンジニアが大規模言語モデル(LLM)用のデータセットを探索、クリーンアップ、改善するためのオープンソースツールです。より良いAIを構築するために、強力なセマンティック検索、データクラスタリング、品質分析を提供します。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Elementary Data VS Lilac — 基本情報
基本情報Elementary DataLilac
Pricing modelFreemiumFree
Product typeWebWeb
Primary focus可観測性モデルトレーニング
対象ユーザーと職種未確認未確認
カテゴリー可観測性 · データ管理 · 分析モデルトレーニング · データ分析 · データ管理
Added2025/08/122025/08/06
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Elementary Data

Elementary Dataは、何千人ものデータおよび分析エンジニアから信頼されている、開発者第一のdbtネイティブなデータオブザーバビリティプラットフォームです。検出から解決まで、データライフサイクル全体にわたってデータ品質を運用化するように設計されています。AIエージェントを活用することで、Elementaryは手作業を自動化し、データチームがビジネス価値を推進する影響の大きい活動に集中できるようにします。このプラットフォームは、AIの導入やデータ製品の採用における主要な障害となることが多いデータ品質という重大な課題に対処し、不正な入力がモデルの破損や信頼できない意思決定につながらないようにします。

Elementary Dataの使い方

Elementary Dataの導入は、特にdbtを既に使用しているチームにとって、迅速かつシームレスに行えるように設計されています。プロセスは通常、次のとおりです。

  1. インストール: 既存のdbtプロジェクト内に、オープンソースのElementary dbtパッケージをSDKとしてインストールします。これは数分で完了します。
  2. 設定: 環境を設定し、データソースを接続します。Elementaryは生データではなく、メタデータとテスト結果への読み取りアクセスのみを必要とするため、セキュリティとコンプライアンス(SOC-2 Type II認定)が保証されます。
  3. 監視: 設定が完了すると、Elementaryは自動的にデータパイプラインの監視を開始します。dbtテストの失敗をキャプチャし、データの鮮度と量の異常を検出し、パフォーマンスメトリクスを収集します。
  4. アラートとトリアージ: Elementary Cloud Platformを使用してアラートを管理します。Slackや他のチャネルを介して適切な担当者やチームに通知するようにルーティングルールをカスタマイズできます。プラットフォームは、リネージや所有者などのコンテキストを提供し、問題のトリアージと解決を迅速化します。
  5. 探索とガバナンス: ネイティブのデータカタログを利用してスキーマを探索し、列レベルのデータリネージを表示し、データの健全性を理解します。AIエージェントは、テストカバレッジの発見や自動トリアージを支援できます。

Elementary Dataの主な機能

  • AIエージェント(Ella): インシデントのトリアージ、テストカバレッジの発見、パフォーマンスの最適化、データガバナンスなどの手作業を自動化し、効率を向上させます。
  • データ品質テスト: dbtテスト、ネイティブのElementaryテスト、カスタムSQLテストを単一の統合プラットフォームから管理します。
  • 自動異常検出: 手動設定なしで、データの鮮度、量、スキーマの異常をプロアクティブに監視します。
  • エンドツーエンドのデータリネージ: 列レベルのデータリネージを視覚化し、データの依存関係を理解し、問題の原因を追跡し、変更の影響を評価します。
  • インシデントとアラート管理: シンプルでコンテキスト豊富なアラートでノイズを削減します。適切な利害関係者に通知をルーティングし、検出から解決までインシデントを管理します。
  • データヘルススコア: さまざまな品質次元にわたるデータの品質と信頼性の概要を迅速に把握します。
  • パフォーマンスとコストの監視: データパイプラインのボトルネックを特定して解決し、実行時間を追跡し、パフォーマンストレンドを監視してコストを最適化します。
  • ネイティブデータカタログ: dbt docsの強化版であり、データディスカバリ、メタデータ管理、データ資産の理解のための一元的な場所を提供します。

Elementary Dataの使用例

Elementary Dataは多用途であり、さまざまなデータ駆動型のイニシアチブをサポートします。たとえば、Flock Safetyのような企業は、Elementaryを使用して実践的なデータガバナンスプログラムを確立しました。データ品質とディスカバリに焦点を当てることで、ビジネスパートナーと分析エンジニアの間で信頼を築きました。これにより、データ消費の増加、より良いコラボレーション、より信頼性の高い意思決定がもたらされました。その他の使用例は次のとおりです。

  • AIの幻覚の防止: AIおよび機械学習モデルに高品質のデータ入力を保証し、誤った出力を防ぎ、信頼できるシステムを構築します。
  • アラート疲労の軽減: Hippoのような企業のデータチームは、Elementaryを使用してノイズをフィルタリングし、本番環境での実際の障害に対してのみアラートを受け取ることで、絶え間ない無関係な通知の「悪夢」を解消します。
  • 利害関係者の信頼向上: 利害関係者にデータの健全性に関する明確な日次概要を提供し、意思決定に使用するデータの品質に自信を持たせます。
  • データ信頼の確立: Elementaryのテスト、タグ付け、メタデータ機能を使用して、データ資産における信頼の「黄金標準」を確立します。

Elementary Dataの利点

Elementaryの主な利点は、dbtエコシステムとの深くネイティブな統合であり、現代のデータチームにとって自然な選択肢となっています。開発者第一のアプローチにより、既存のワークフローにシームレスに適合します。自動化のためのAIエージェントの使用は、手作業を大幅に削減し、チームの効率を向上させます。さらに、テストと監視からインシデント解決とガバナンスまで、データ品質ライフサイクル全体を包括的にカバーしているため、オールインワンソリューションとなっています。プラットフォームは設計上安全であり、生データにアクセスすることはなく、強力なオープンソースバージョンと企業向けのスケーラブルなクラウドプランの両方を提供します。

料金プラン

Elementaryは、ユーザーシートに基づいた柔軟な料金モデルを提供しており、無料のオープンソースオプションと有料のクラウドプランがあります。Essentialsプランの30日間無料トライアルが利用可能です。

  • オープンソース(OSS): 何千ものチームが本番環境で使用している、自己ホスト型の無料コミュニティバージョンです。
  • Starterプラン: 月額650ドル。最大2ユーザー、データ問題の検出とトリアージ、自動異常検出、列レベルのデータリネージ、パフォーマンス監視が含まれます。
  • Essentialsプラン: 月額1600ドル。Starterのすべてに加えて、最大8ユーザー、コラボレーション機能、すべてのAIエージェント、インシデント管理、エンドツーエンドのデータリネージ、専用のSlackサポートが含まれます。
  • Enterpriseプラン: カスタム価格。Essentialsのすべてに加えて、柔軟なシート、エンタープライズグレードのセキュリティ(RBAC、SCIM)、高度なデプロイメントオプション、プレミアムサポートSLA、JiraやPagerDutyなどのツールとの統合が含まれます。

Lilac

Lilacは、開発者やデータサイエンティストがAIモデル開発のためのデータと対話する方法を革新するために設計された、強力なオープンソースプラットフォームです。「より良いデータ、より良いAI」という原則に基づき、Lilacは特に大規模言語モデル(LLM)のトレーニングやファインチューニングに使用されるデータセットを検索、定量化、編集するための包括的なツールスイートを提供します。データ探索、クリーニング、キュレーションのプロセスをより効率的、直感的、スケーラブルにすることで、高品質なデータに対する重要なニーズに応えます。

このプラットフォームは、Alignment Lab AIやNousResearchなどの主要な組織から信頼されており、チームが単純なキーワード検索を超えて、データの深い概念的な理解を得ることを可能にします。その超高速計算エンジンにより、Lilacは膨大なデータセットを驚異的な速度で処理できます。例えば、100万のデータポイントをわずか20分でクラスタリングしたり、1分あたり5億トークンのレートでデータを埋め込んだりすることができます。このパフォーマンスにより、Lilacはあらゆる本格的なデータ品質評価パイプラインにおいて重要な構成要素となります。

Lilacの使い方

Lilacの使い始めは、特にPythonエコシステムに慣れている人にとっては簡単です。主な使用方法は、ローカルへのインストールと、探索のためのウェブベースのユーザーインターフェースを含みます。

  1. インストール:まず、Pythonパッケージインストーラーであるpipを使用してLilacライブラリをインストールします。ターミナルまたはコマンドプロンプトを開き、pip install lilacコマンドを実行します。
  2. Lilacの起動:インストール後、ターミナルからLilacサーバーを起動できます。これは通常、lilac start [path_to_your_project_dir]のようなコマンドを実行して行います。このコマンドはデータセットを処理し、ローカルウェブサーバーを起動します。
  3. データの読み込み:Lilacにデータセットを指示します。さまざまなデータ形式やソースを扱うことができ、ローカルファイル(CSV、JSONなど)からデータをインポートしたり、Hugging Faceなどのハブから直接インポートしたりできます。
  4. 探索と分析:サーバーが実行されたら、提供されたURLをウェブブラウザで開き、Lilac UIにアクセスします。ここで、その強力な機能を使用してデータを探索できます。セマンティック検索を実行し、データクラスターを表示し、PIIや言語などのシグナルを分析します。
  5. キュレーションと編集:インターフェースを使用して、データポイントを直接タグ付け、フィルタリング、編集します。新しいラベルを作成したり、重複を削除したり、ノイズの多いエントリをクリーンアップしたりできます。
  6. エクスポートと活用:データセットをキュレーションした後、改善されたバージョンや生成されたインサイト(例:削除するIDのリスト)をエクスポートして、モデルトレーニングパイプラインで使用できます。

Lilacの主な機能

  • セマンティック&キーワード検索:基本的なテキストマッチングを超えます。Lilacでは、自然言語クエリを使用してデータセットを検索し、概念的に類似したエントリを見つけることができます。従来のキーワード検索もサポートしています。
  • 自動データクラスタリング:Lilacは類似したデータポイントを自動的にグループ化し、これらのクラスターにタイトルを割り当てることで、データに存在するトピックやテーマの概要を即座に把握できます。
  • ファジーコンセプト検索:特定のキーワードで定義するのが難しい抽象的または微妙な概念を検索し、より高度なデータスライシングと探索を可能にします。
  • 組み込みのデータ品質シグナル:プラットフォームには、個人識別情報(PII)、ほぼ重複、テキストの複雑さ、テキストの言語を自動的に検出するための事前構築済みシグナルが付属しています。
  • カスタムシグナルの作成:ユーザーは、データセット上で独自のカスタムシグナルと変換を定義・実行することでLilacの機能を拡張し、特定のニーズに合わせて分析を調整できます。
  • データ編集と比較:UI内で直接データフィールドを編集し、データセットの異なるフィールドやバージョンを並べて比較して、変更の影響を理解できます。
  • 高性能エンジン:速度と規模を考慮して設計されたLilacは、数十億トークンを含むデータセットを処理でき、大規模なデータキュレーションを可能にします。

Lilacの使用例

Lilacは、AI開発ライフサイクル全体で適用できる多目的なツールです。

  • 事前学習データのキュレーション:基盤モデルを事前学習する前に、大規模なウェブスケールのデータセットを分析・クリーニングして、低品質なコンテンツ、重複、PIIを削除します。
  • ファインチューニングデータセットの改善:インストラクションファインチューニングなどのタスクでは、Lilacを使用してインストラクションとレスポンスのペアの品質を分析し、バイアスを特定し、データの多様性を確保します。
  • モデルの評価とデバッグ:モデルのパフォーマンスが低い特定のデータスライスを発見・分析します。失敗例をクラスタリングして調査することで、モデルの弱点を理解し、より良いデータで対処できます。
  • データ探索と理解:コードを書き始める前に、新しいテキストデータセットの質的な感触をすばやく掴みます。その構成を理解し、主要なトピックを特定し、潜在的な問題を早期に発見します。
  • コンテンツモデレーションと安全性:セマンティック検索とカスタムシグナルを使用して、データセット内の有害、不適切、またはその他の機密性の高いコンテンツを効率的に特定し、タグ付けします。

Lilacの利点

Lilacは、LLMを扱うチームに大きな利点をもたらします。

  • モデルパフォーマンスの向上:データ品質を体系的に改善することで、Lilacはより正確で信頼性が高く、バイアスの少ないAIモデルの構築を支援します。
  • 開発ワークフローの加速:データ探索とクリーニングに必要な時間と手作業を劇的に削減し、チームがより迅速に反復できるようにします。
  • データインサイトの民主化:直感的なUIにより、MLエンジニアだけでなく、プロダクトマネージャーやドメインエキスパートを含むすべてのチームメンバーが詳細なデータセット分析にアクセスできます。
  • オープンソースと拡張性:無料でオープンソースであることは、透明性、コミュニティの協力を促進し、独自のプロジェクト要件に合わせて完全にカスタマイซすることができます。
  • 実世界データへのスケーラビリティ:その効率的なアーキテクチャにより、小規模から大規模な本番スケールのデータセットまで、同じ厳格なデータ品質プロセスを適用できます。

料金プラン

Lilacはオープンソースプロジェクトであり、そのコアライブラリとユーザーインターフェースは完全に無料で使用できます。ローカルマシンやプライベートインフラストラクチャにコストなしでインストールして実行できます。このプロジェクトは、そのコミュニティと貢献者によって維持されています。コアツールは無料ですが、言及されている「Lilac Garden」など、商用利用向けのマネージドクラウドサービス、専用サポート、または高度な機能を提供する将来のエンタープライズレベルのオファリングがある可能性があります。ただし、個人の開発者、研究者、およびほとんどのチームにとっては、オープンソースバージョンが完全な機能を提供します。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
データ管理
のみ Elementary Data
可観測性分析
のみ Lilac
モデルトレーニングデータ分析

タグ

共通
データ品質
のみ Elementary Data
AIエージェント分析エンジニアリング異常検知データカタログデータリネージデータ監視データ可観測性dbt
のみ Lilac
データ分析データクレンジングデータ探索データセット開発者ツール大規模言語モデル機械学習オープンソースセマンティック検索

対象ユーザーと職種

共通
確認済みデータなし
のみ Elementary Data
確認済みデータなし
のみ Lilac
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Elementary Data monthly traffic:

Latest traffic · 2026-05

月間訪問数
16K
平均滞在時間
0:21
訪問あたりページ数
1.54
直帰率
47.25%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: 未確認
  • 2025-09: 18.7K
  • 2026-01: 17K
  • 2026-02: 16.9K
  • 2026-03: 18.3K
  • 2026-04: 12.1K
  • 2026-05: 16K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States48.18%7.7K
🇩🇪Germany25.01%4K
🇧🇷Brazil11.23%1.8K
🇮🇳India8.01%1.3K
🇫🇷France7.57%1.2K

検索キーワード

dbt test accepted valuesdbt tests relationshipelementary dataelementary performance alertsnowflake summit

Lilac monthly traffic:

Latest traffic · 2026-05

月間訪問数
16.7K
平均滞在時間
1:00
訪問あたりページ数
1.12
直帰率
80.5%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: 682
  • 2025-09: 504
  • 2026-01: 未確認
  • 2026-02: 693
  • 2026-03: 0
  • 2026-04: 709
  • 2026-05: 16.7K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States100%16.7K

検索キーワード

lilac data managementsportwetten ohne lugas

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

Elementary Data

評価
未確認
コメント
0
お気に入り
153
いいね
162

Lilac

評価
未確認
コメント
0
お気に入り
170
いいね
175

Elementary Data vs Lilac · 比較 FAQ

What do Elementary Data and Lilac have in common?
Both tools are listed under データ管理. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Elementary Data and Lilac free?
Listed pricing models: Elementary Data — Freemium; Lilac — Free. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Elementary Data and Lilac?
The primary listed category is 可観測性 for Elementary Data, and モデルトレーニング for Lilac. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較