ToolMage
ログイン

AI TOOL COMPARISON

Flower vs TensorFlow

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

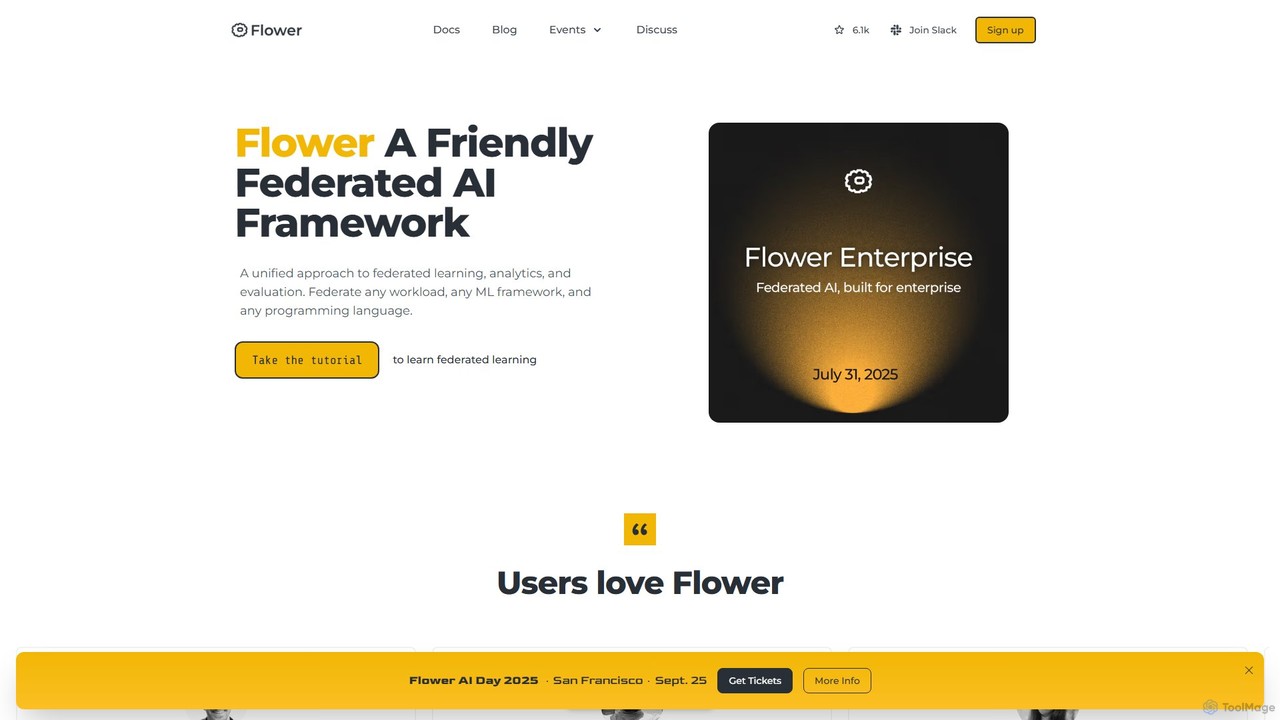
Flower 製品概要

Flowerは、連合学習、分析、評価をサポートする、使いやすいオープンソースの連合学習フレームワークです。プライバシーを損なうことなく、様々なデバイスやプラットフォームに分散したデータでAIモデルをトレーニングでき、PyTorch、TensorFlow、Hugging Faceなど多数のMLフレームワークをサポートします。

Preview

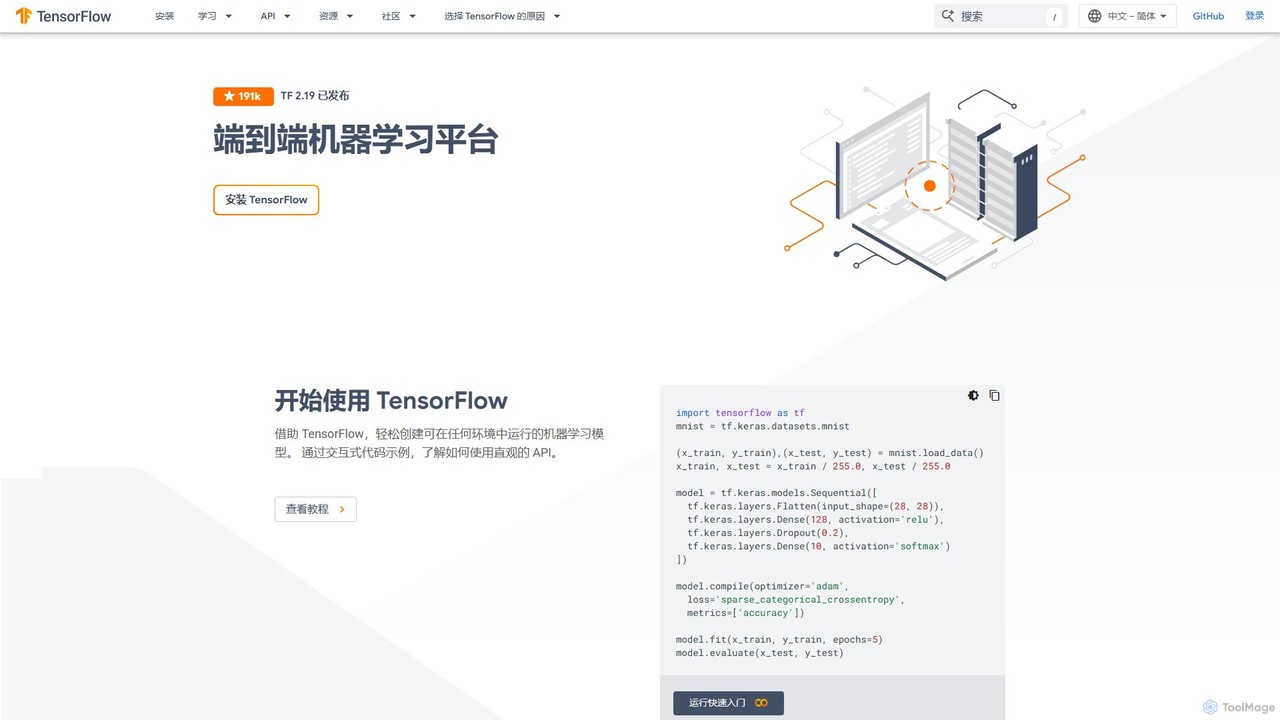
TensorFlow 製品概要

TensorFlowは、Googleが開発したエンドツーエンドのオープンソース機械学習プラットフォームです。研究者や開発者がMLを活用したアプリケーションを構築・展開できるよう、ツール、ライブラリ、コミュニティリソースからなる包括的で柔軟なエコシステムを提供します。初心者から専門家まで、TensorFlowは簡単なモデル構築のための直感的な高レベルAPIと、高度な研究のための強力な低レベルAPIを提供し、サーバー、エッジデバイス、ブラウザへの展開を可能にします。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Flower VS TensorFlow — 基本情報
基本情報FlowerTensorFlow
Pricing modelFreeFree
Product typeWebWeb
Primary focusフレームワークフレームワーク
対象ユーザーと職種未確認未確認
カテゴリーフレームワーク · 機械学習 · 分散型AIフレームワーク · 機械学習 · 開発者ツール
Added2025/08/022025/08/11
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Flower

Flowerは、連合学習、連合分析、連合評価を統一するために設計された、包括的なオープンソースのフレームワークです。現代の機械学習におけるプライバシー、データ規制(GDPRやCCPAなど)、データ量の増大という課題に対応します。トレーニングのためにデータを一元化する従来のアプローチとは異なり、Flowerは分散型の手法を推進します。つまり、計算(モデルトレーニング)をデータが存在する場所へ移動させるのです。この「プライバシー・バイ・デザイン」のアプローチにより、組織や開発者は、生データを一切公開することなく、機密性の高い分散データセット上で協力して強力なAIモデルを構築できます。

スケーラビリティと使いやすさを重視して構築されたFlowerは、研究者と本番環境のエンジニアの両方が利用しやすいように設計されています。最小限のエンジニアリングオーバーヘッドで、研究プロトタイプから大規模な本番システムへとスムーズに移行できます。このフレームワークはMozillaのような主要な組織に信頼され使用されており、その効率性とシンプルさで研究者から賞賛されています。

Flowerの使い方

Flowerの使い始めは、特にPythonや人気の機械学習ライブラリに慣れている開発者にとっては簡単です。プロセスはいくつかの簡単なステップに分けられます。

  1. インストール: pipを使用してFlowerライブラリをインストールします。典型的なシミュレーション設定の場合、コマンドは pip install flwr[simulation] です。
  2. Flowerアプリの作成: Flowerは、新しいプロジェクトを迅速に構築するためのコマンドラインツールを提供しています。flwr new を実行し、対話型のプロンプトに従って好みのMLフレームワーク(例:TensorFlow, PyTorch)を選択するだけです。
  3. クライアントとサーバーのロジックの実装: クライアント(データを保持し、ローカルトレーニングを実行)とサーバー(連合学習プロセスを調整し、モデルの更新を集約)の動作を定義します。これはPythonで行われ、Flowerは既存のモデルトレーニングコードを統合するための明確な抽象化を提供します。基本的なシステムはわずか20行程度のコードで設定できます。
  4. 連合アプリの実行: クライアントとサーバーのロジックが定義されたら、単一のコマンドで連合学習プロセスを開始できます:flwr run .。

Flowerは、PyTorch、TensorFlow、Hugging Face、JAX、scikit-learn、XGBoostなど、さまざまなフレームワークのクイックスタートガイドやチュートリアルを含む広範なドキュメントを提供しており、既存のプロジェクトを簡単に連合化できます。

Flowerの主な機能

  • MLフレームワーク非依存: PyTorch、TensorFlow、Keras、JAX、scikit-learn、XGBoostなど、ほぼすべての機械学習フレームワークとシームレスに統合します。特定のエコシステムに縛られることなく、お気に入りのツールを使用できます。
  • 統一されたアプローチ: 連合学習、連合評価(分散データでのモデル性能評価)、連合分析(分散データからの洞察導出)のための単一で一貫したフレームワークを提供します。
  • 極めて高いスケーラビリティ:膨大な数のクライアントを持つ現実世界のシナリオを処理するように設計されています。数千万のクライアントを持つシミュレーションで成功裏に使用されています。
  • プラットフォーム非依存: さまざまなハードウェアやオペレーティングシステムで動作します。主要なクラウドプロバイダー(AWS、GCP、Azure)や、Android、iOS、Raspberry Pi、NVIDIA Jetsonなどのエッジデバイスと互換性があります。
  • 研究から本番まで: 初期の研究や実験から、堅牢で本番環境に対応したデプロイメントまで、スムーズなパイプラインを促進します。
  • プライバシー強化技術: 差分プライバシー(DP)やセキュアアグリゲーション(SecAgg+)などの高度なプライバシー技術をサポートし、定量化可能なプライバシー保証を提供し、モデルの更新を保護します。
  • 広範なSDK: 主にPythonフレームワークですが、FlowerはAndroid(Java/Kotlin)、iOS(Swift)、C++(近日公開)向けのSDKで拡張しており、ネイティブのオンデバイストレーニングを可能にします。

Flowerの使用例

Flowerのプライバシー保護機能は、多くの機密性の高い分野でAIアプリケーションを可能にします。

  • ヘルスケア: 病院は、機密性の高い医療記録を共有することなく、それぞれの患者データでがん検出モデルを共同でトレーニングできます。
  • 金融: 金融機関は、顧客のプライバシーを侵害することなく精度を向上させるために、自社のプライベートな取引データでトレーニングして共有の不正検出モデルを構築できます。
  • 自動車&IoT: 自動車メーカーは、何千台もの車両からの位置情報や運転データに対して連合学習を使用することで、電気自動車の航続距離予測を改善しつつ、ユーザーデータをデバイス上に保持できます。
  • モバイル&オンデバイスAI: 開発者は、ユーザーの携帯電話からのテキスト入力を使用して、よりスマートなキーボードのオートコンプリートモデルをトレーニングできますが、そのテキストがデバイスから出ることはありません。
  • 大規模言語モデル(LLM): Flowerは、機密情報を一元化することなく、プライベートでドメイン固有のデータセット上でLLMを連合ファインチューニング(例:FlowerTune LLMを使用)し、専門的なモデルを作成することを可能にします。
  • ロボティクス: 複数のロボットで制御モデルをトレーニングし、それぞれが異なる環境での個々の経験から学習させます。

Flowerの利点

Flowerの主な利点は、これまでプライバシー、法的、または物流上の制約のために機械学習が不可能だったシナリオでそれを可能にすることです。オープンで柔軟かつ強力なツールを提供することで、協調的なAIへのアクセスを民主化します。フレームワーク非依存の設計により、開発者は既存のスキルとコードベースを活用できます。SlackやGitHubの強力なコミュニティは優れたサポートを提供し、包括的なドキュメントと例は連合学習分野への参入障壁を下げます。

料金プラン

FlowerはApache 2.0ライセンスの下で提供されるオープンソースプロジェクトです。学術目的および商業目的で完全に無料で使用できます。開発は、活発な貢献者コミュニティと商業パートナーによって支えられています。

TensorFlow

TensorFlowは、機械学習と人工知能のための無料のオープンソースソフトウェアライブラリです。Google Brainチームによって開発され、ニューラルネットワークの構築とトレーニングにおいて最も人気があり、広く使用されているプラットフォームの1つとなっています。TensorFlowは、開発者が大規模なサーバーファームから小型のエッジデバイス、さらにはウェブブラウザまで、幅広いプラットフォームでMLモデルを簡単に構築、トレーニング、デプロイできるエンドツーエンドのエコシステムを提供します。

TensorFlowの中核は、テンソル(多次元配列)を含む計算を定義し実行するためのシステムです。このデータフローグラフベースのモデルは、絶大な柔軟性とスケーラビリティを可能にします。大規模な研究実験から堅牢な本番環境対応のアプリケーションまで、あらゆるものを容易にするように設計されており、検索、Gmail、フォトなど、Google自身の多くの製品を支えています。

TensorFlowの使い方

TensorFlowを使用する一般的なワークフローには、いくつかの重要なステップが含まれます:

  1. インストール: TensorFlowはPythonのパッケージマネージャーを使用して簡単にインストールできます:pip install tensorflow。
  2. データの読み込みと前処理: 強力なtf.data APIを使用して、効率的で複雑な入力パイプラインを構築します。これにより、さまざまなソースからデータを読み込み、変換し、モデルにシームレスに供給できます。
  3. モデルの構築: ほとんどのユースケースでは、高レベルのKeras API(tf.keras)を使用してモデルを構築することが推奨されます。単純なシーケンシャルモデルを作成するか、より柔軟なFunctional APIやモデルのサブクラス化を使用して複雑なアーキテクチャを構築できます。基本的なモデルは次のようになります:
    model = tf.keras.models.Sequential([...layers...])
  4. モデルのコンパイル: トレーニングの前に、model.compile()メソッドを使用して学習プロセスを設定する必要があります。ここで、オプティマイザ(例:'adam')、損失関数(例:'sparse_categorical_crossentropy')、監視するメトリクス(例:'accuracy')を指定します。
  5. トレーニング: model.fit()メソッドを呼び出してモデルをトレーニングし、トレーニングデータ、エポック数、検証データを渡します。
  6. 評価と予測: トレーニング後、model.evaluate()でテストセット上のモデルのパフォーマンスを評価するか、model.predict()で新しいデータに対する予測を行います。
  7. デプロイ: トレーニング済みのモデルを保存し、TensorFlowエコシステムのツール(本番サーバー用のTensorFlow Serving、モバイルおよび組み込みデバイス用のTensorFlow Lite、ブラウザでモデルを実行するためのTensorFlow.jsなど)を使用してデプロイします。

TensorFlowの主な機能

  • 柔軟なモデル構築: 迅速なプロトタイピングのためのシンプルで直感的なKeras APIと、完全な制御と高度な研究のための低レベルAPIの両方を提供します。
  • 堅牢なMLOps - 本番環境対応: TensorFlow Extended (TFX)は、データ取り込みからモデルのデプロイと管理までのライフサイクル全体を管理する、本番MLパイプラインをデプロイするための完全なプラットフォームを提供します。
  • マルチプラットフォーム展開: 一度トレーニングすれば、どこにでも展開できます。TensorFlow Liteは、モバイル(Android/iOS)および組み込みシステムでのオンデバイス推論用にモデルを最適化し、TensorFlow.jsは、MLアプリケーションがブラウザまたはNode.jsで直接実行できるようにします。
  • 強力な実験ツール: TensorBoardは、TensorFlowプログラムを理解、デバッグ、最適化するための一連のWebベースの視覚化ツールを提供します。損失や精度などのメトリクスを追跡し、モデルグラフを視覚化し、重みとバイアスのヒストグラムを表示します。
  • 包括的なエコシステム: 事前トレーニング済みモデルの広大なリポジトリであるTensorFlow Hub、標準データセットに簡単にアクセスできるTensorFlow Datasets、強化学習用のTF-Agentsやグラフニューラルネットワーク用のTensorFlow GNNなどの専門ライブラリが含まれます。

TensorFlowの使用例

TensorFlowの多様性は、業界を問わず幅広いアプリケーションに適しています:

  • コンピュータビジョン: 画像分類、物体検出、画像セグメンテーション、顔認識。
  • 自然言語処理(NLP): 感情分析、テキスト生成、機械翻訳、チャットボット。
  • 強化学習: ゲーム、ロボット工学、およびSpotifyのプレイリスト生成などの最適化問題のためのエージェントのトレーニング。
  • 音声処理: 音声認識、音声合成、およびMagentaなどのプロジェクトによる音楽生成。
  • 予測分析: 金融の時系列予測、小売の需要予測、交通予測。
  • 医療発見: 医療画像の分析、病気の発生予測、創薬支援。

TensorFlowの利点

TensorFlowは、その数多くの利点により際立っています:

  • スケーラビリティ: 単一のCPU/GPUシステムから、大規模な分散サーバークラスターやTPU(テンソルプロセッシングユニット)などの特殊なハードウェアまで、幅広いハードウェアで実行できるように設計されています。
  • 成熟度と信頼性: Googleに支えられており、数え切れないほどの現実世界の大規模アプリケーションを動かしている、成熟し、十分にテストされたフレームワークです。
  • 強力なコミュニティとサポート: 開発者と研究者の巨大なグローバルコミュニティ、広範なドキュメント、チュートリアル、専門的なサポートを誇ります。
  • エンドツーエンドプラットフォーム: 機械学習ワークフロー全体をカバーする、まとまりのある包括的なツールセットを提供し、複数の異なるツールの必要性を減らします。

料金プラン

TensorFlowは、Apache 2.0ライセンスの下で配布される、完全に無料でオープンソースのプロジェクトです。ソフトウェア自体の使用には、料金、サブスクリプション、または有料プランはありません。ユーザーは、研究目的および商用目的で自由にダウンロード、変更、配布できます。TensorFlowの使用に関連するコストは、通常、基盤となるハードウェア(例:GPUの購入)またはクラウドコンピューティングリソース(例:トレーニングとデプロイのためのGoogle Cloud AI Platform、AWS、Azureの使用)に関連します。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
フレームワーク機械学習
のみ Flower
分散型AI
のみ TensorFlow
開発者ツール

タグ

共通
データサイエンス機械学習オープンソースPython
のみ Flower
AIフレームワーク分散型AI連合学習プライバシーPyTorchTensorFlow
のみ TensorFlow
コンピュータビジョンディープラーニングデプロイグーグルモデル学習ニューラルネットワークNLP

対象ユーザーと職種

共通
確認済みデータなし
のみ Flower
確認済みデータなし
のみ TensorFlow
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Flower monthly traffic:

Latest traffic · 2026-05

月間訪問数
78.9K
平均滞在時間
1:20
訪問あたりページ数
2.3
直帰率
38.15%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 100.9K
  • 2026-01: 78.6K
  • 2026-02: 69.2K
  • 2026-03: 69.7K
  • 2026-04: 68.3K
  • 2026-05: 78.9K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇧🇷Brazil37.03%29.2K
🇺🇸United States20.99%16.6K
🇮🇳India17.3%13.7K
🇩🇪Germany13.13%10.4K
🇵🇱Poland11.55%9.1K

流入元

Source typePercentageEstimated visits
ダイレクト79.68%62.9K
参照元18.58%14.7K
Eメール1.74%1.4K

検索キーワード

flowerflower aiflower federated learningprometheus flower federated learningstrategy stasrty method flower return

TensorFlow monthly traffic:

Latest traffic · 2026-05

月間訪問数
688.6K
平均滞在時間
1:55
訪問あたりページ数
7.28
直帰率
50.17%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 894.8K
  • 2026-01: 811K
  • 2026-02: 769.2K
  • 2026-03: 803.4K
  • 2026-04: 735.1K
  • 2026-05: 688.6K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States40.89%281.6K
🇮🇳India36.17%249.1K
🇩🇪Germany9.26%63.8K
🇳🇬Nigeria6.94%47.8K
🇨🇳China6.74%46.4K

流入元

Source typePercentageEstimated visits
ダイレクト63.62%438.1K
参照元33.53%230.9K
Eメール2.85%19.6K

検索キーワード

tensorboardtensor flowtensorflowtensorflow playgroundword2vec

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

Flower

評価
未確認
コメント
0
お気に入り
167
いいね
164

TensorFlow

評価
未確認
コメント
0
お気に入り
149
いいね
138

Flower vs TensorFlow · 比較 FAQ

What do Flower and TensorFlow have in common?
Both tools are listed under フレームワーク、機械学習. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Flower and TensorFlow free?
Listed pricing models: Flower — Free; TensorFlow — Free. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Flower and TensorFlow?
The primary listed category is フレームワーク for Flower, and フレームワーク for TensorFlow. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較