ToolMage
ログイン

AI TOOL COMPARISON

No-Code Scraper vs ParseHub

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

No-Code Scraper 製品概要

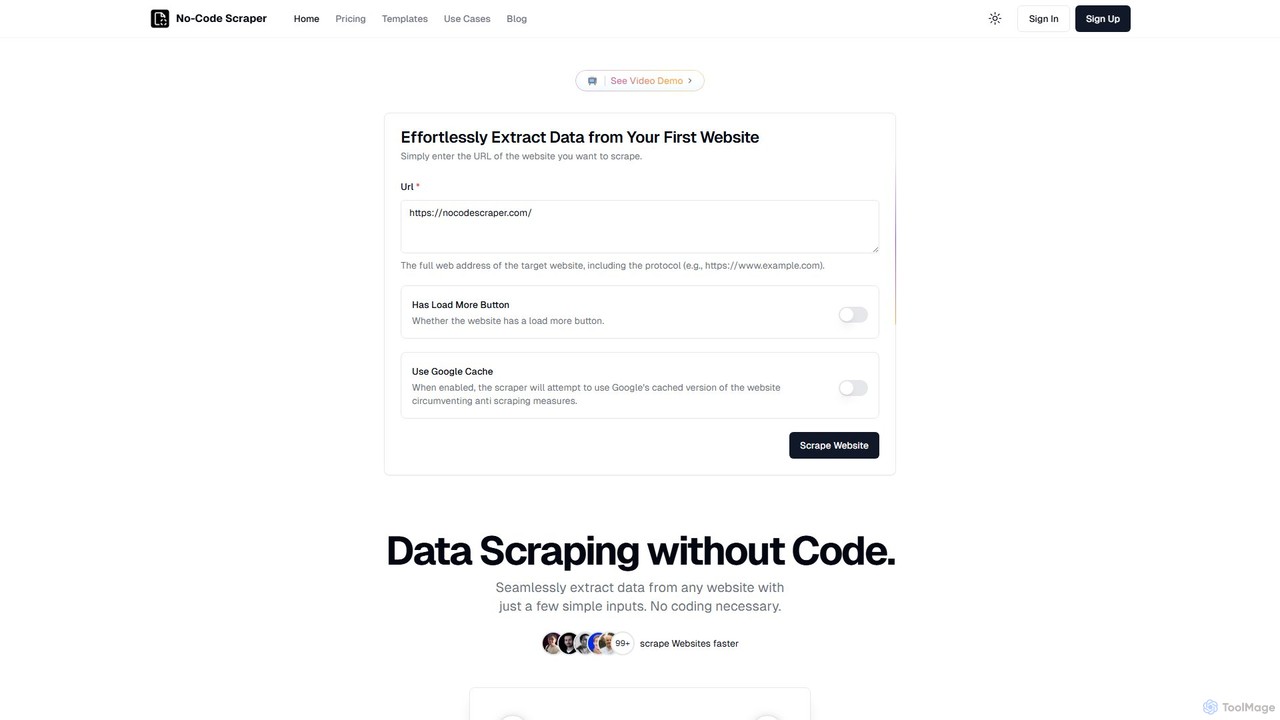
No-Code Scraperは、一行のコードも書かずにあらゆるウェブサイトからデータを抽出できるAI搭載プラットフォームです。大規模言語モデルを使用してデータ抽出、クリーニング、構造化を自動化し、誰でもウェブスクレイピングをアクセスしやすく、信頼性が高く、効率的に利用できるようにします。

Preview

ParseHub 製品概要

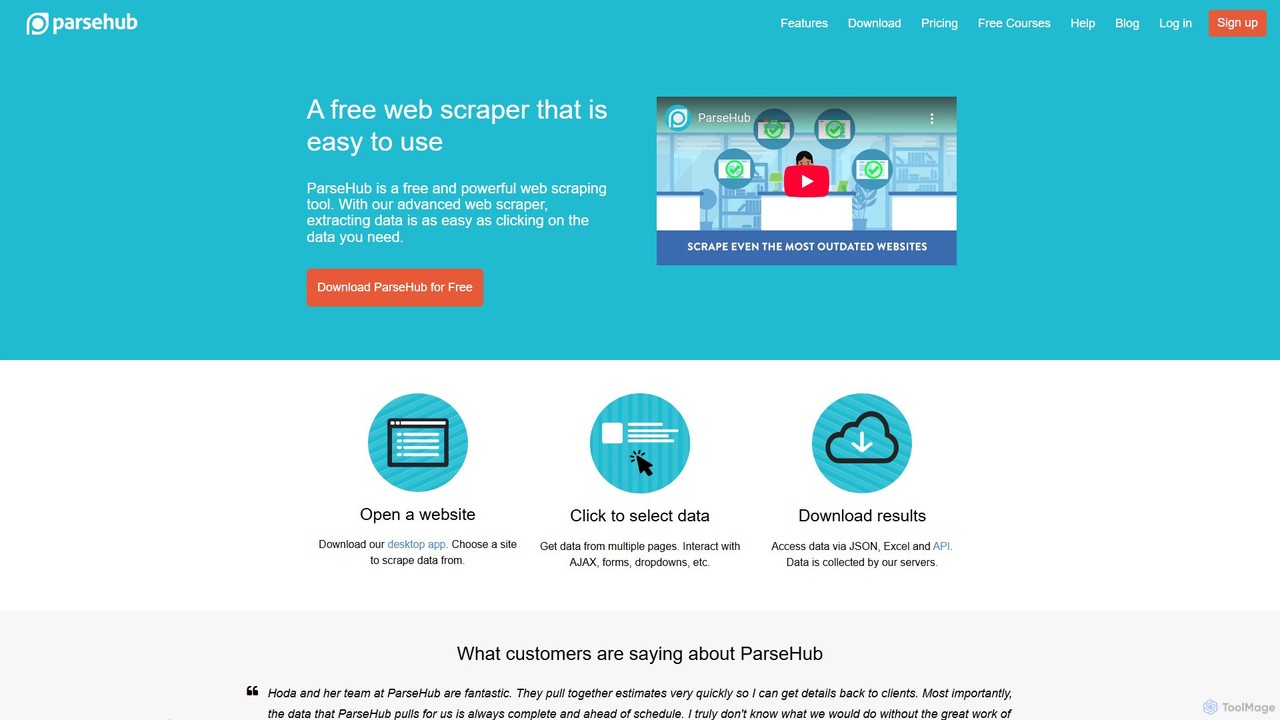
ParseHubは、強力なノーコードのウェブスクレイピングツールで、簡単なポイント&クリック操作で任何のウェブサイトからデータを抽出できます。JavaScript、AJAX、フォーム、無限スクロールなど、複雑で動的なサイトに対応するよう設計されています。データをスケジュール収集し、JSON/Excelでエクスポート、またはAPI経由でアクセスでき、リードジェネレーション、市場調査、データ集約に最適です。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

No-Code Scraper VS ParseHub — 基本情報
基本情報No-Code ScraperParseHub
Pricing modelFreemiumFreemium
Product typeWebApp
Primary focusウェブスクレイピングウェブスクレイピング
対象ユーザーと職種未確認未確認
カテゴリーウェブスクレイピング · リードジェネレーション · 開発 · 自動化ウェブスクレイピング · データ抽出 · リードジェネレーション · 自動化
Added2025/08/102025/08/06
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

No-Code Scraper

No-Code Scraperは、ウェブデータ抽出を民主化するために設計された革新的なツールです。技術的な背景に関係なく、ユーザーがどんなウェブサイトからでも価値ある情報をシームレスに引き出すことを可能にします。高度なAIと大規模言語モデル(LLM)の力を活用することで、このプラットフォームは従来複雑で脆弱だったウェブスクレイピングのプロセスを自動化します。開発者の必要性、ウェブサイトの更新によるスクレイパーの頻繁な破損、生データのクリーニングにかかる時間など、一般的な問題点を解決します。

このプラットフォームは、シンプルさと回復力の原則に基づいて構築されています。ユーザーは数回のクリックでスクレイピングを開始でき、基盤となるAIはウェブサイトの構造変化に適応するように設計されており、一貫性のある信頼性の高いデータ収集を保証します。この「壊れない」品質は、一つのテンプレートを作成し、何千もの類似サイトで継続的なメンテナンスなしに使用できることを意味します。

No-Code Scraperの使い方

No-Code Scraperを始めるのは、簡単な3つのステップです:

  1. ウェブサイトのインポート:まず、対象のウェブサイトのURLを入力します。一括スクレイピング操作のために、CSVファイルからウェブサイトのリストをインポートすることもできます。
  2. 抽出するデータポイントの定義:直感的なノーコードインターフェースを使用してスクレイピングテンプレートを作成します。抽出したいデータ(例:「商品名」、「価格」、「カスタマーレビュー」)を説明するだけです。AIがあなたの要件を理解し、抽出、クリーニング、検証を処理します。Yelp、Google Maps、Product Huntなどの人気サイト用に事前に構築された多種多様なテンプレートから選択することもできます。
  3. スクレイピングジョブの開始:テンプレートが設定されたら、ワンクリックでジョブを開始します。AIが仕様に従ってデータのスクレイピングを開始します。完了後、完全に構造化された結果をCSV、Excel、またはJSONファイルとしてダウンロードするか、上位プランではGoogle Sheets、Notion、Airtableなどのツールに直接エクスポートできます。

No-Code Scraperの主な機能

  • AI搭載ノーコードインターフェース:HTMLやCSSの知識がなくても、必要なデータを平易な言葉で説明するだけで簡単にスクレイパーを設定できます。
  • 壊れない回復力:AIがウェブサイトのレイアウト変更に自動的に適応し、スクレイパーの破損を防ぎ、継続的なメンテナンスの必要性を排除します。
  • 自動データクリーニング:完全に構造化され、クリーンで、フォーマットされたデータを即座に取得し、手作業でのデータ準備時間を節約します。
  • 豊富な事前構築済みテンプレート:Crunchbase、Glassdoor、Yelp、Kickstarterなどの一般的なユースケースや人気ウェブサイト向けの多数のテンプレートがあり、すぐにスクレイピングを開始できます。
  • 高度なスクレイピング機能:ページネーション、「もっと読み込む」ボタン、動的なJavaScriptレンダリングコンテンツなど、複雑なシナリオに対応します。
  • Googleキャッシュ統合:一部のアンチスクレイピング対策を回避するために、Googleのキャッシュされたバージョンのウェブサイトを使用するオプション。
  • 柔軟なデータエクスポート:CSV、Excel、またはJSON形式でデータをダウンロードします。
  • 統合とAPIアクセス:Google Sheets、Notion、Airtableと連携(Proプラン)するか、APIアクセス(Expertプラン)で完全なプログラム制御が可能です。
  • スケジュールされたスクレイピング:定期的にスクレイピングジョブを実行するようにスケジュールし、データ収集を自動化します(Proプラン以上)。

No-Code Scraperの使用例

No-Code Scraperは多機能で、マーケター、創業者、研究者、営業チームがさまざまな目的で使用できます:

  • リードジェネレーション:BBBやYelpなどのディレクトリからビジネス詳細を抽出したり、Mediumから専門家のプロフィールを抽出したりします。
  • 市場調査:Product Huntから製品データを、アプリストアからアプリ情報を、CrunchbaseやIndie Hackersから市場動向をスクレイピングします。
  • 競合分析:eコマースサイトやレビュープラットフォームから競合他社の価格、製品機能、顧客レビューを監視します。
  • 採用:Glassdoor、Upwork、Y Combinatorなどのプラットフォームから求人情報を収集し、採用トレンドを分析して機会を見つけます。
  • 不動産分析:Redfinなどのサイトから物件リストや詳細をスクレイピングし、市場動向を追跡して投資機会を見つけます。
  • コンテンツ集約:ウェブ上のさまざまなソースからデータを抽出して、ディレクトリを構築したり、ジャーナルを編集したりします。

No-Code Scraperの利点

主な利点はそのアクセシビリティです。非技術的なユーザーにウェブデータの世界を開きます。AI駆動の回復力は、従来のスクレイパーに典型的なメンテナンスのオーバーヘッドを大幅に削減します。自動データクリーニングは、すぐに使えるデータを提供することで生産性を大幅に向上させます。このオールインワンプラットフォームは、単純なデータ取得から複雑な複数ページのスクレイピングシナリオまで、すべてを処理し、包括的で費用対効果の高いソリューションとなっています。

料金プラン

No-Code Scraperは5日間の無料トライアルと、クレジットシステムに基づくいくつかのサブスクリプションプランを提供しています。クレジットは、ページのスクレイピングやデータの抽出などのアクションに使用されます。

  • Starterプラン:月額$16.99で400クレジット。Javascriptレンダリングと基本的なデータエクスポート(JSON、CSV、Excel)が含まれます。
  • Proプラン:月額$19.99で400クレジット。Starterの全機能に加え、Google Sheets、Notion、Airtableへのエクスポート、スケジュールされたスクレイピングジョブが含まれます。
  • Expertプラン:月額$25.99で400クレジット。Proの全機能に加え、完全なAPIアクセスと、より要求の厳しいタスクのためのプレミアムプロキシサポートが含まれます。

必要なクレジット数はタスクによって異なります。例えば、単純なページのスクレイピングは1クレジット、プロキシを使用してページからデータをスクレイピングおよび抽出するには6クレジットかかります。

ParseHub

ParseHubは、コーディングスキルに関係なく、誰もがウェブから簡単にデータを抽出できるように設計された、無料で強力なウェブスクレイピングツールです。高度なビジュアルインターフェースにより、必要な情報をクリックするだけでデータ抽出が完了します。データサイエンティスト、マーケター、開発者、Eコマースの専門家など、ウェブから効率的にデータを収集する必要があるすべての人にとって堅牢なソリューションです。

このツールは、特に現代的で複雑なウェブサイトの扱いに長けています。フォーム、ドロップダウンメニュー、ログイン、地図などのインタラクティブな要素をナビゲートできます。また、他のスクレイパーにとってはしばしば困難な、無限スクロール、タブ、ポップアップを持つサイトもシームレスに管理します。ParseHubの機械学習リレーションシップエンジンは、ページの構造をインテリジェントに分析し、要素の階層を理解し、数秒で目的のデータを取得するため、手動でのデータ入力や複雑なスクリプト作成は不要です。

ParseHubの使い方

ParseHubを始めるのは、簡単な3ステップのプロセスです:

  1. ダウンロードとインストール:まず、お使いのオペレーティングシステム用の無料のParseHubデスクトップアプリケーションをダウンロードしてインストールします。
  2. データの選択:アプリケーションを開き、スクレイピングしたいウェブサイトのURLを入力します。サイトが読み込まれたら、抽出したいデータフィールドをクリックするだけです。ParseHubの選択ツールは、類似の要素をインテリジェントに識別し、ページ上の複数のアイテムからデータをキャプチャします。複数のページをスクレイピングするためのページネーションの処理や、検索クエリを送信するためのフォーム操作などを学習させることができます。
  3. 実行とダウンロード:プロジェクトの設定が完了したら、スクレイピングを実行できます。データはParseHubのクラウドサーバーで収集されるため、作業中にアプリを閉じることができます。実行が完了した後、APIを介して抽出されたデータにアクセスするか、ExcelやJSONを含むさまざまな形式でダウンロードして、分析や他のシステムへの統合に利用できます。

ParseHubの主な機能

  • ノーコードインターフェース:要素をクリックするだけでスクレイパーを構築できる、ユーザーフレンドリーなグラフィカルインターフェース。
  • 動的ウェブサイトの処理:JavaScript、AJAX、Cookie、リダイレクトを使用するサイトからデータをスクレイピングできます。ログイン、ポップアップ、ドロップダウンなどを処理できます。
  • クラウドベースのスクレイピング:すべてのデータ抽出はParseHubのサーバーで行われるため、ローカルコンピュータのリソースを解放します。
  • スケジュール収集:プロジェクトを毎日、毎週、またはカスタムスケジュールで自動実行し、最新のデータを取得します。
  • IPローテーション:スクレイピング中にブロックされるのを防ぐため、大規模なIPアドレスプールを自動的にローテーションします。
  • 強力なデータクリーニング:ダウンロード前に、アプリ内で直接正規表現(RegEx)を使用してテキストとHTMLをクリーンアップし、フォーマットします。
  • APIと統合:REST APIを使用してプログラムでデータにアクセスし、Webhookを使用してリアルタイムの通知を受け取ります。また、Google Sheets、Tableau、Dropboxとも統合されています。
  • 柔軟なデータエクスポート:スクレイピングしたデータをJSON、CSV、Excel形式でダウンロードし、他のアプリケーションで簡単に分析・使用できます。

ParseHubの使用例

ParseHubは、さまざまな業界で活用される多目的なツールです:

  • Eコマース:競合他社のウェブサイトから製品詳細、価格、評価、レビューをスクレイピングし、価格監視や市場分析に利用します。
  • リードジェネレーション:オンラインディレクトリ、専門家ネットワーク、コミュニティから連絡先情報を抽出し、セールスファネルを構築します。
  • 市場調査:業界分析、競合追跡、市場トレンドの特定のためにデータを集約します。
  • データジャーナリズムと学術研究:研究プロジェクト、レポート、データ駆動型の記事のために、公共のソースから大規模なデータセットを収集します。
  • コンテンツ集約:複数のウェブサイトから記事、ニュース、投稿を収集し、ニュースアグリゲーターやコンテンツプラットフォームを強化します。
  • 不動産:不動産ウェブサイトから物件リスト、価格、エージェントの詳細をスクレイピングします。

ParseHubの利点

ParseHubはいくつかの重要な理由で際立っています。その主な利点は、コーディングの障壁を取り除くことでウェブスクレイピングを民主化する使いやすさです。あらゆるインタラクティブなウェブサイトを処理できる強力さと柔軟性は、複雑なタスクのための信頼できるツールとなります。クラウドベースでスケーラブルであるため、ユーザーがインフラを管理することなく、数ページから数百万ページまでのあらゆる規模のプロジェクトを処理できます。これにより、時間とリソースが大幅に節約され、ユーザーはデータ収集ではなく分析に集中できます。

料金プラン

ParseHubは、さまざまなニーズに合わせて複数のプランを提供しています:

  • 無料プラン:小規模なプロジェクトや学習に最適です。実行ごとに200ページ、5つの公開プロジェクト、14日間のデータ保持が含まれます。
  • スタンダードプラン(月額$189):プロフェッショナル向けに設計されています。実行ごとに10,000ページ、20のプライベートプロジェクト、IPローテーション、スケジュールスクレイピングを提供します。
  • プロフェッショナルプラン(月額$599):大量のスクレイピング向けです。実行ごとの無制限ページ、120のプライベートプロジェクト、優先サポート、30日間のデータ保持が含まれます。
  • ParseHub Plus(エンタープライズ):大規模なデータニーズを持つ企業向けのカスタムプランで、専用サポート、カスタム機能、スクレイピングプロジェクト設定の専門家による支援を提供します。

非営利団体、学生、学術機関向けの割引があります。すべての価格は米ドルです。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
ウェブスクレイピングリードジェネレーション自動化
のみ No-Code Scraper
開発
のみ ParseHub
データ抽出

タグ

共通
自動化データ抽出データマイニングリード生成市場調査ノーコードWebスクレイピング
のみ No-Code Scraper
AIデータクレンジング
のみ ParseHub
データ収集価格追跡

対象ユーザーと職種

共通
確認済みデータなし
のみ No-Code Scraper
確認済みデータなし
のみ ParseHub
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

No-Code Scraper monthly traffic:

Latest traffic · 2026-05

月間訪問数
3.3K
平均滞在時間
0:47
訪問あたりページ数
2.03
直帰率
45.35%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5K
  • 2026-01: 2.6K
  • 2026-02: 2.2K
  • 2026-03: 5.1K
  • 2026-04: 3.9K
  • 2026-05: 3.3K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States39.52%1.3K
🇭🇰Hong Kong33.21%1.1K
🇮🇩Indonesia18.52%617
🇮🇳India8.75%292

流入元

Source typePercentageEstimated visits
参照元94.54%3.2K
ダイレクト5.46%182

検索キーワード

instant data scraperinstant data scraper extensionno code scrapernocodescraperno code web scraper

ParseHub monthly traffic:

Latest traffic · 2026-05

月間訪問数
68.7K
平均滞在時間
0:19
訪問あたりページ数
1.89
直帰率
39.47%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 136.2K
  • 2026-01: 120.4K
  • 2026-02: 102.7K
  • 2026-03: 82.7K
  • 2026-04: 74K
  • 2026-05: 68.7K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States39.93%27.4K
🇮🇳India23.24%16K
🇳🇬Nigeria14.19%9.7K
🇬🇧United Kingdom13.27%9.1K
🇧🇷Brazil9.37%6.4K

流入元

Source typePercentageEstimated visits
ダイレクト91.62%62.9K
参照元6.21%4.3K
Eメール2.17%1.5K

検索キーワード

free webscraping coursehow to get an html sentence for a specific value on a websitepareshubparsehubparse hub how to click on gdpr agreement first

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

No-Code Scraper

評価
未確認
コメント
0
お気に入り
184
いいね
181

ParseHub

評価
未確認
コメント
0
お気に入り
166
いいね
165

No-Code Scraper vs ParseHub · 比較 FAQ

What do No-Code Scraper and ParseHub have in common?
Both tools are listed under ウェブスクレイピング、リードジェネレーション、自動化. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are No-Code Scraper and ParseHub free?
Listed pricing models: No-Code Scraper — Freemium; ParseHub — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between No-Code Scraper and ParseHub?
The primary listed category is ウェブスクレイピング for No-Code Scraper, and ウェブスクレイピング for ParseHub. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較