
Free
Llm Lab Three
개발자와 연구원을 위한 무료 도구로, 대규모 언어 모델(LLM)을 나란히 비교할 수 있습니다. 프롬프트를 테스트하고, 매개변수를 조정하며, 응답을 즉시 분석하여 모든 작업에 최적의 모델을 찾으세요.
모델 비교Visits 7.3KFavorites 135Likes 131
Popular 모델 비교 AI tools in AI 도구 include Choosy Chat, Prompto 및 Llm Lab Three, helping you work more efficiently.
개발자와 연구원을 위한 무료 도구로, 대규모 언어 모델(LLM)을 나란히 비교할 수 있습니다. 프롬프트를 테스트하고, 매개변수를 조정하며, 응답을 즉시 분석하여 모든 작업에 최적의 모델을 찾으세요.
모델 비교
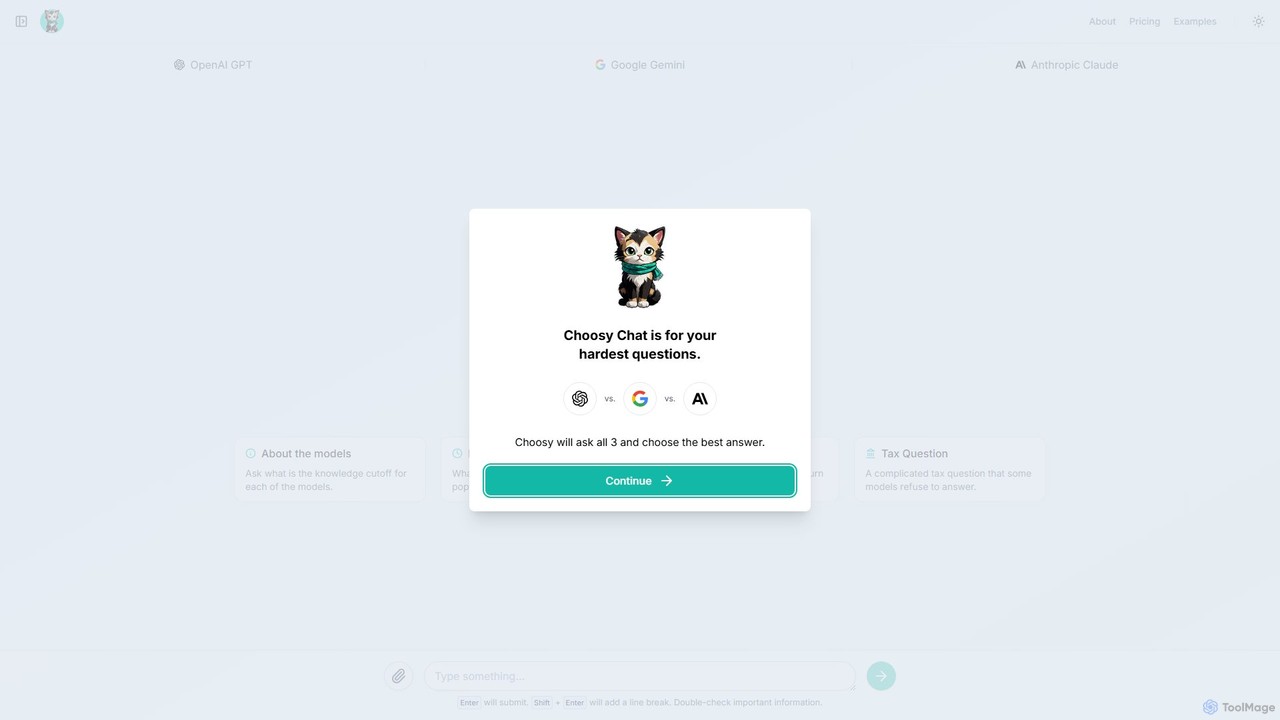
Choosy Chat은 사용자의 프롬프트를 GPT, Gemini, Claude에 동시에 전송하여 답변을 나란히 비교할 수 있게 해주는 AI 도구입니다. 코딩부터 창의적인 글쓰기까지 모든 질문에 대한 최상의 답변을 찾는 데 도움을 줍니다.
모델 비교모델 비교 도구는 다양한 AI 모델의 성능을 나란히 평가하고 벤치마킹하기 위한 전문 플랫폼입니다. 이러한 도구는 표준화된 데이터셋, 사용자 지정 프롬프트, 그리고 정확성, 속도, 비용과 같은 핵심 성능 지표를 사용하여 모델을 테스트할 수 있는 구조화된 환경을 제공합니다. 개발자, 연구원, 기업이 특정 애플리케이션에 가장 적합한 AI 모델을 선택할 때 데이터 기반의 의사 결정을 내리는 데 필수적입니다. 이를 통해 마케팅 주장을 넘어선 객관적인 분석이 가능하며, 최적의 성능과 비용 효율성을 보장합니다.
이러한 도구는 새로운 애플리케이션의 기반 모델을 선택하는 AI 개발자, 모델 성능 저하를 모니터링하는 MLOps 팀, OpenAI, Anthropic, Google과 같은 공급업체의 비용 대비 성능 비율을 비교하는 제품 관리자에게 널리 사용됩니다. 연구원들은 또한 기존 벤치마크에 대해 새로운 모델의 성능을 검증하기 위해 사용합니다.
도구를 선택할 때는 지원되는 모델의 범위(오픈 소스 대 독점), 사용 가능한 평가 지표 및 벤치마크, 테스트에 사용자 지정 데이터를 사용할 수 있는지 여부, 그리고 사용자 친화적인 UI, 자동화를 위한 API 또는 둘 다 필요한지 여부를 고려하십시오. 또한 테스트 볼륨에 맞는 가격 모델을 평가해야 합니다.
전자상거래 회사의 제품 관리자는 새로운 AI 챗봇을 위한 대규모 언어 모델(LLM)을 선택해야 합니다. 모델 비교 도구를 사용하여 100개의 일반적인 고객 문의가 포함된 테스트 스위트를 만듭니다. 이 스위트를 GPT-4, Claude 3, Llama 3과 같은 모델에 대해 실행하여 응답 정확성, 공손함, 지연 시간 및 1,000개 쿼리당 비용을 비교합니다. 플랫폼의 사이드 바이 사이드 뷰는 특정 사용 사례에 대해 Claude 3이 품질과 비용의 최상의 균형을 제공함을 보여주며, 수 주간의 수동 테스트 대신 몇 시간 만에 데이터 기반 결정을 내릴 수 있게 합니다.
ML 엔지니어링 팀이 회사 내부 지식 기반에 대해 Llama 3 모델을 미세 조정했습니다. 그 효과를 검증하기 위해 모델 비교 플랫폼을 사용하여 기본 Llama 3 모델 및 GPT-4와 벤치마킹합니다. 일반 지식을 위한 MMLU와 같은 업계 표준 테스트와 50개의 내부 Q&A 쌍으로 구성된 사용자 지정 테스트 세트를 실행합니다. 결과에 따르면 미세 조정한 모델이 내부 질문에서 기본 모델보다 30% 더 나은 성능을 보여 미세 조정에 투입된 자원의 정당성을 입증했습니다.
한 스타트업이 사용자를 위해 기사를 요약하는 AI 기능을 제공합니다. 사용자 증가가 가속화되면서 현재 사용 중인 고급 모델 API의 비용이 문제가 됩니다. 개발팀은 모델 비교 도구를 사용하여 요약 작업에 대해 더 저렴하고 작은 모델을 테스트합니다. 그들은 비용 분석 대시보드를 모니터링하면서 출력의 품질, 일관성 및 길이를 비교합니다. 그 결과, 단 40%의 비용으로 95%의 품질을 제공하는 더 작은 증류 모델을 발견하여 수익 마진을 크게 향상시켰습니다.
마케팅 팀이 새로운 광고 캠페인을 위한 비주얼을 생성해야 합니다. 그들은 원하는 미학을 위해 Midjourney, Stable Diffusion 또는 DALL-E 3 중 어느 것을 사용해야 할지 확신하지 못합니다. 모델 비교 도구를 사용하여 동일한 창의적인 프롬프트 세트를 세 가지 모델 모두에 입력합니다. 플랫폼은 출력을 정리하여 팀이 브랜드 정렬, 시각적 매력 및 창의성을 기준으로 생성된 이미지에 투표하고 순위를 매길 수 있도록 합니다. 이 구조화된 프로세스는 캠페인 스타일에 가장 적합한 것으로 Stable Diffusion을 신속하게 식별하는 데 도움이 됩니다.
한 대학 연구원이 최신 AI 모델의 추론 능력을 연구하고 있습니다. 그들은 모델 비교 플랫폼의 API를 활용하여 수십 개의 다른 모델에 걸쳐 수천 개의 논리 퍼즐과 수학 문제를 프로그래밍 방식으로 실행합니다. 이 도구는 테스트를 자동화하고 결과를 수집하며 집계된 정확도 점수를 제공합니다. 이를 통해 연구원은 수백 시간의 수동 스크립팅 및 실행 시간을 절약하고 데이터 분석 및 모델 성능 동향에 대한 연구 결과 발표에 집중할 수 있습니다.
IDE 플러그인을 구축하는 회사가 AI 코드 완성 기능을 추가하고자 합니다. 엔지니어링 리드는 GitHub Copilot(GPT 기반), Code Llama 및 기타 전문 코딩 모델 중에서 결정해야 합니다. 그들은 HumanEval과 같은 벤치마크 스위트가 있는 모델 비교 도구를 사용합니다. 이를 통해 다양한 프로그래밍 언어에 걸쳐 정확하고 효율적인 코드 스니펫을 생성하는 각 모델의 능력을 객관적으로 측정하여 사용자에게 가장 신뢰할 수 있고 성능이 뛰어난 옵션을 통합할 수 있습니다.
AI 모델 비교 도구는 다양한 AI 모델을 체계적으로 평가하고 벤치마킹하도록 설계된 플랫폼입니다. 단일 모델을 제공하는 대신, 동일한 입력을 사용하여 여러 모델(예: GPT-4, Claude 3, Llama 3)을 나란히 테스트할 수 있는 환경을 제공합니다. 이를 통해 사용자는 출력, 속도 및 정확성과 같은 성능 지표, 운영 비용을 객관적으로 비교하여 정보에 입각한 결정을 내릴 수 있습니다.
올바른 플랫폼을 선택하려면 다음 요소를 고려하십시오:
OpenAI나 Anthropic과 같은 모델 제공업체는 API를 통해 액세스하는 실제 AI 모델(예: GPT-4, Claude 3)을 개발하고 호스팅합니다. 반면, 모델 비교 도구는 여러 모델 제공업체에 연결되는 별도의 메타 수준 플랫폼입니다. 그 목적은 모델 자체가 되는 것이 아니라, 다른 제공업체의 모델을 통제되고 표준화된 방식으로 테스트, 평가 및 비교할 수 있는 인프라를 제공하는 것입니다.
AI 모델을 비교하는 주요 지표는 일반적으로 여러 범주로 나뉩니다:
이러한 도구는 다양한 사용자에게 유용합니다. 개발자와 엔지니어는 애플리케이션에 가장 성능이 좋고 비용 효율적인 모델을 선택하기 위해 사용합니다. 연구원은 새로운 모델을 벤치마킹하고 학술 논문을 발표하기 위해 사용합니다. 제품 관리자와 비즈니스 리더는 어떤 AI 기술을 채택할지에 대한 전략적 결정을 내리기 위해 사용합니다. MLOps 팀도 시간 경과에 따른 모델 성능을 모니터링하기 위해 사용합니다.