ToolMage
로그인

AI TOOL COMPARISON

Bright Data vs Crawly

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

제품 개요

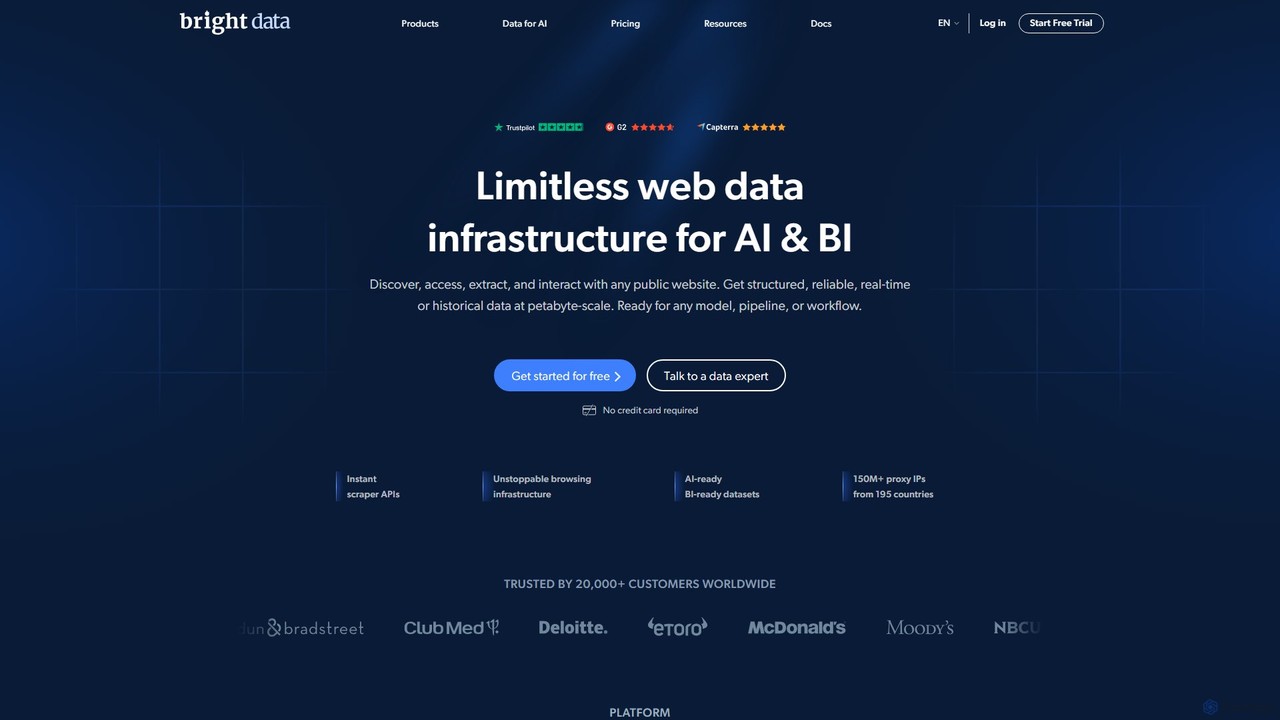
Bright Data 제품 개요

Bright Data는 프록시 네트워크, AI 기반 웹 스크레이퍼, 즉시 사용 가능한 데이터셋을 포함한 포괄적인 도구 모음을 제공하는 세계 최고의 웹 데이터 플랫폼입니다. 기업이 AI 훈련, 시장 조사 및 경쟁 정보 수집을 위해 방대한 양의 공개 웹 데이터를 수집할 수 있도록 지원합니다.

Preview

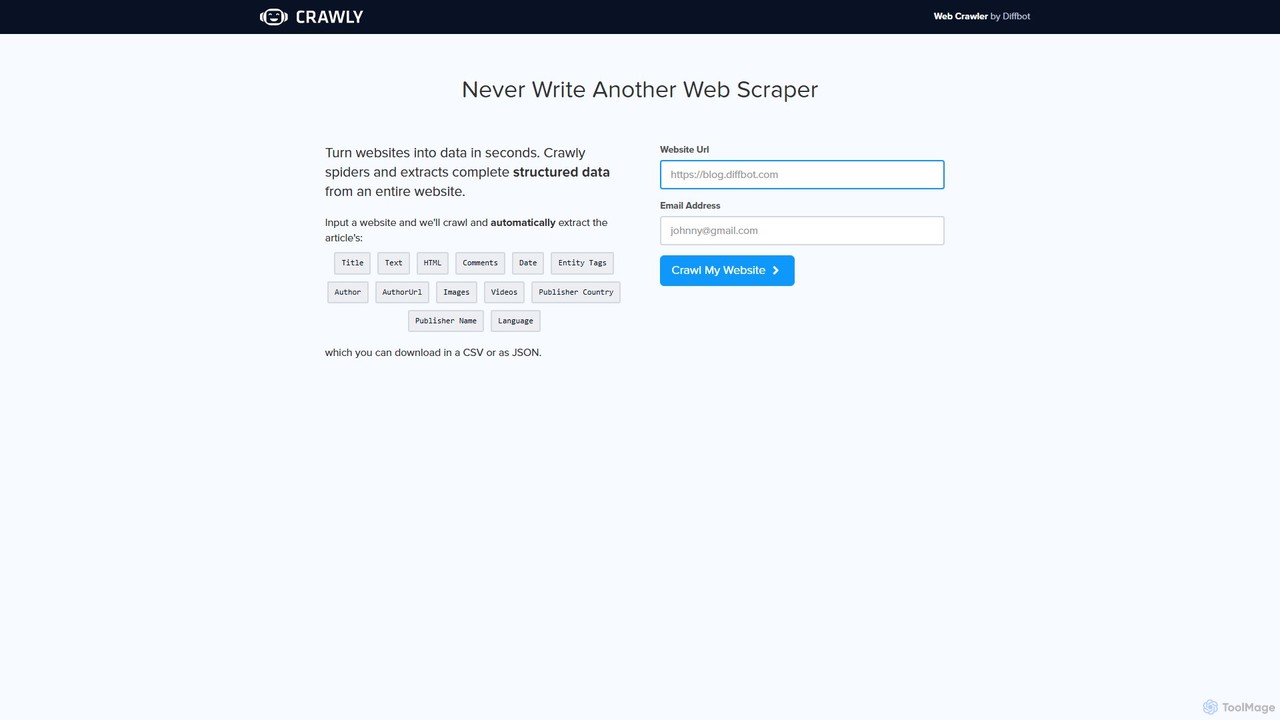
Crawly 제품 개요

Crawly는 Diffbot이 만든 AI 기반 웹 크롤러로, 전체 웹사이트에서 구조화된 데이터를 자동으로 추출합니다. URL을 입력하기만 하면 Crawly가 사이트를 스파이더링하여 기사, 제품, 토론과 같은 주요 정보를 가져와 코딩 없이 깨끗한 JSON 또는 CSV 데이터로 변환합니다.

Preview

핵심 정보

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Bright Data VS Crawly — 핵심 정보
핵심 정보Bright DataCrawly
Pricing modelPaidFreemium
Product typeWebWeb
Primary focus비즈니스 인텔리전스웹 스크래핑
대상과 직무확인되지 않음확인되지 않음
카테고리비즈니스 인텔리전스 · 웹 스크래핑 · API · 시장 조사웹 스크래핑 · API · 시장 조사 · 자동화
Added2025. 8. 12.2025. 8. 10.
업데이트2026. 11. 19.2026. 11. 19.

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Bright Data

Bright Data는 거의 모든 산업 분야에서 20,000개 이상의 조직이 신뢰하는 세계 1위 웹 데이터 플랫폼입니다. 모든 규모의 공개 웹 데이터를 발견, 액세스 및 추출하기 위한 강력한 올인원 솔루션을 제공합니다. 실시간 데이터든 과거 데이터든, Bright Data의 인프라는 모든 모델, 파이프라인 또는 워크플로우에 즉시 사용할 수 있는 구조화되고 신뢰할 수 있는 정보를 제공하도록 구축되었습니다. 이 플랫폼은 AI 개발을 촉진하고, 시장 조사를 지원하며, 온라인 자산을 모니터링하고, 데이터 기반 의사 결정을 가능하게 하도록 설계되었습니다.

Bright Data 사용 방법

Bright Data는 필요에 따라 여러 가지 방법으로 활용할 수 있는 유연한 플랫폼을 제공합니다:

  1. 프록시 네트워크: Bright Data의 수상 경력에 빛나는 프록시 네트워크(주거용, ISP, 데이터센터, 모바일)를 기존 데이터 수집 스크립트나 애플리케이션에 통합하세요. 이를 통해 수백만 개의 실제 사용자 IP를 통해 요청을 라우팅하여 지리적 제한을 우회하고 차단을 피해 모든 공개 웹사이트에 익명으로 성공적으로 액세스할 수 있습니다.
  2. 웹 스크레이퍼 IDE: 맞춤형 스크레이퍼를 구축하려는 사용자를 위해 웹 스크레이퍼 IDE는 사전 구축된 기능과 템플릿을 갖춘 강력한 환경을 제공합니다. 기본 프록시 인프라, 확장 또는 차단 문제를 처리하지 않고도 웹 스크레이퍼를 개발, 실행 및 관리할 수 있습니다.
  3. 데이터셋 마켓플레이스: 가장 쉽게 시작하는 방법은 데이터셋 마켓플레이스에 액세스하는 것입니다. 아마존, 링크드인, 질로우, 인스타그램과 같은 수백 개의 인기 웹사이트에서 즉시 사용 가능한 구조화된 데이터셋을 구매할 수 있습니다. 데이터는 일회성 구매 또는 정기적인 업데이트를 위한 구독을 통해 다운로드할 수 있습니다.
  4. 데이터셋 API: 프로그래밍 방식의 액세스를 위해 데이터셋 API를 사용하면 맞춤형 데이터 컬렉션을 정의, 요청 및 검색할 수 있습니다. 워크플로우는 일반적으로 다음을 포함합니다: 1) 대상 사이트와 데이터 포인트를 정의하여 컬렉션을 요청합니다. 2) 컬렉션 작업의 상태를 확인합니다. 3) 컬렉션을 시작하여 선호하는 형식(JSON, CSV, Parquet)으로 데이터를 수신합니다.

Bright Data의 핵심 기능

  • 포괄적인 프록시 네트워크: 195개국에 걸쳐 주거용, 데이터센터, ISP 및 모바일 네트워크를 포함한 7,200만 개 이상의 IP에 액세스할 수 있습니다.
  • AI 기반 웹 스크레이핑: 복잡한 자바스크립트 기반 웹사이트를 처리하고, CAPTCHA를 해결하며, 브라우저 지문을 자동으로 관리할 수 있는 고급 웹 스크레이퍼 및 스크레이퍼 IDE.
  • 방대한 데이터셋 마켓플레이스: 주요 전자상거래, 소셜 미디어, 부동산 및 비즈니스 인텔리전스 웹사이트에서 사전 수집 및 검증된 데이터셋의 대규모 카탈로그.
  • 확장성 및 성능: 페타바이트 규모의 데이터를 처리하도록 구축된 인프라로, 대규모 데이터 수집 프로젝트의 높은 성공률과 가동 시간을 보장합니다.
  • 데이터 규정 준수 및 윤리: GDPR 및 CCPA와 같은 데이터 보호법을 준수하는 업계 최고의 규정 준수로, 윤리적이고 책임감 있는 데이터 수집을 보장합니다.
  • 유연한 데이터 제공: 즉각적인 분석이나 모델 훈련에 사용할 수 있도록 JSON, CSV, Parquet 등 다양한 형식의 깨끗하고 구조화된 데이터를 제공합니다.
  • 관리형 서비스: 직접 관여하지 않는 접근 방식을 선호하는 기업을 위해 Bright Data는 전문가가 전체 데이터 수집 프로세스를 처리해주는 완전 관리형 데이터 서비스를 제공합니다.

Bright Data의 사용 사례

Bright Data의 솔루션은 다목적이며 다양한 애플리케이션에 적합합니다:

  • AI 및 머신러닝: 웹 전반에서 고품질의 대규모 데이터셋을 수집하여 머신러닝 모델을 훈련하고 검증합니다.
  • 전자상거래 및 소매 인텔리전스: 경쟁사 가격을 모니터링하고, 제품 가용성을 추적하며, 제품 데이터를 집계하고, 고객 리뷰를 분석하여 전략을 최적화합니다.
  • 시장 조사: 뉴스 사이트, 포럼, 소셜 미디어에서 데이터를 수집하여 시장 동향을 분석하고, 브랜드 정서를 추적하며, 포괄적인 경쟁사 분석을 수행합니다.
  • 금융 서비스: 투자 분석, 위험 평가 및 금융 모델링을 위해 공공 소스에서 대체 데이터를 수집합니다.
  • 브랜드 보호: 지적 재산권 침해, 위조 제품 및 브랜드 자산의 무단 사용을 위해 웹을 스캔합니다.

Bright Data의 장점

Bright Data를 선택하면 상당한 경쟁 우위를 확보할 수 있습니다. 올인원 플랫폼은 프록시, 스크레이퍼, 데이터셋을 한 곳에서 제공하여 여러 공급업체의 필요성을 통합합니다. 강력한 검증 프로세스 덕분에 데이터의 품질과 신뢰성은 타의 추종을 불허합니다. 플랫폼의 엄청난 규모와 글로벌 도달 범위는 어떤 목표도 도달 불가능하지 않음을 의미합니다. 결정적으로, Bright Data의 윤리적이고 규정을 준수하는 데이터 수집에 대한 강력한 약속은 복잡한 규제 환경에서 운영되는 기업에 안심을 제공합니다. 개발자 친화적인 도구와 전담 지원은 온보딩에서 프로덕션까지 원활한 경험을 보장합니다.

가격 및 플랜

Bright Data는 다양한 요구와 규모에 맞춰 유연한 종량제 가격 모델과 월간 및 연간 구독 플랜을 제공합니다.

  • 프록시 네트워크: 가격은 일반적으로 트래픽(GB당) 또는 IP당을 기준으로 하며, 데이터센터, 주거용, ISP 및 모바일 프록시에 따라 요금이 다릅니다. 플랜은 스타터 패키지부터 대규모 기업 약정까지 다양합니다.
  • 웹 스크레이퍼 IDE: 사용량에 따라 가격이 책정되며, 종종 성공적인 요청 수(CPM)로 계산됩니다.
  • 데이터셋 마켓플레이스: 데이터셋은 일회성 구매 또는 구독 모델(월간, 분기별, 반기별)을 통해 구매할 수 있으며, 구독 모델은 상당한 할인을 제공합니다. 가격은 레코드당으로 계산되며(예: 1,000개 레코드당 2.5달러부터), 데이터의 복잡성과 새로고침 빈도에 따라 비용이 달라집니다.
  • 지원 플랜: 모든 고객에게 표준 지원 플랜이 포함됩니다. 향상된 서비스를 위해 프리미엄 및 엔터프라이즈 플랜을 이용할 수 있으며, 24/7 지원, 전담 계정 관리자 및 우선 응답을 제공합니다. 프리미엄 플랜은 월별 청구액의 8%(최소 500달러/월), 엔터프라이즈 플랜은 10,000달러/월입니다.

상세하고 맞춤화된 가격 정보는 Bright Data 영업팀에 문의하거나 공식 가격 페이지를 방문하는 것이 좋습니다.

Crawly

Crawly는 AI 기반 데이터 추출 분야의 선두주자인 Diffbot이 개발한 강력하고 지능적인 웹 크롤러입니다. 웹 스크래핑의 수동적이고 기술적인 어려움을 완전히 제거하도록 설계되었습니다. 웹사이트 업데이트 시 깨지기 쉬운 복잡한 코드를 작성하거나 취약한 선택자를 사용하는 대신, Crawly는 컴퓨터 비전과 자연어 처리를 포함한 고급 인공 지능을 활용하여 인간처럼 웹 페이지를 이해하고 해석합니다. 이를 통해 단일 URL 입력만으로 전체 웹사이트에서 완전하고 구조화된 데이터를 자동으로 식별하고 추출할 수 있습니다.

Crawly의 핵심 약속은 '웹사이트를 몇 초 만에 데이터로 변환'하는 것입니다. 웹사이트를 탐색하며 링크를 따라가고 각 페이지의 구조를 분석하여 기사, 제품, 토론, 이미지 갤러리와 같은 다양한 콘텐츠 유형을 구별합니다. 추출된 데이터는 애플리케이션, 데이터 분석 또는 머신 러닝 모델에서 즉시 사용할 수 있도록 깨끗하고 구조화된 형식으로 정리됩니다.

Crawly 사용 방법

Crawly는 기술 수준에 관계없이 누구나 매우 간단하고 접근하기 쉽게 설계되었습니다. 과정은 몇 단계만 거치면 됩니다:

  1. URL 입력: Crawly 웹사이트로 이동합니다. 제공된 입력 필드에 크롤링하려는 웹사이트의 전체 URL을 입력합니다.
  2. 이메일 제공: 이메일 주소를 입력합니다. 크롤링이 완료되면 알림을 받고 결과를 전달하는 데 사용됩니다.
  3. 크롤링 시작: 'Crawl My Website' 버튼을 클릭합니다. 그러면 Crawly의 AI 엔진이 전체 사이트를 스파이더링하기 시작하여 페이지를 분석하고 정보를 추출합니다.
  4. 데이터 다운로드: 프로세스가 완료되면 추출된 데이터를 받게 됩니다. JSON 또는 CSV와 같은 편리하고 구조화된 형식으로 다운로드하여 데이터베이스, 스프레드시트 또는 기타 소프트웨어로 쉽게 가져올 수 있습니다.

Crawly의 핵심 기능

  • AI 기반 자동 추출: Diffbot의 고급 AI를 활용하여 수동 구성 없이 기사, 제품, 토론 등에서 데이터를 자동으로 인식하고 추출합니다.
  • 포괄적인 데이터 필드: 제목, 텍스트, HTML, 댓글, 날짜, 저자, 저자 URL, 이미지, 비디오, 게시자 정보(국가, 이름) 및 언어를 포함한 풍부한 데이터 포인트를 추출합니다.
  • 개체 인식: 텍스트 내에서 사람, 조직, 장소와 같은 개체를 자동으로 식별하고 태그를 지정하여 가치 있는 메타데이터의 또 다른 계층을 추가합니다.
  • 전체 사이트 크롤링: 단일 페이지 스크레이퍼와 달리 Crawly는 전체 웹사이트를 탐색하여 포괄적으로 데이터를 수집합니다.
  • 구조화된 데이터 출력: 깨끗하고 잘 구조화된 데이터를 JSON 또는 CSV 형식으로 제공하여 후처리 및 데이터 정제 필요성을 제거합니다.
  • 노코드 솔루션: 프로그래밍 기술이나 웹 스크래핑 기술에 대한 지식이 필요 없어 마케터, 연구원, 비즈니스 분석가도 사용할 수 있습니다.
  • 견고하고 복원력 있음: 콘텐츠의 의미 구조를 이해하기 때문에 웹사이트 레이아웃 변경에 쉽게 깨지지 않으며, 이는 기존 스크레이퍼의 일반적인 문제입니다.

Crawly의 사용 사례

Crawly는 다양한 애플리케이션에 적합한 다목적 도구입니다:

  • 시장 조사: 경쟁사의 제품 정보, 가격, 고객 리뷰 및 뉴스 언급을 자동으로 수집하여 경쟁 우위를 확보합니다.
  • 리드 생성: 기업 웹사이트 및 온라인 디렉토리에서 연락처 정보, 회사 정보 및 주요 인력을 추출합니다.
  • 콘텐츠 집계: 여러 소스에서 기사, 블로그 게시물 및 비디오를 집계하여 맞춤형 뉴스 피드 또는 콘텐츠 플랫폼을 구축합니다.
  • 머신 러닝용 데이터: 제품 리뷰에 대한 감성 분석이나 뉴스 기사의 트렌드 분석과 같은 머신 러닝 모델 훈련을 위한 대규모 고품질 데이터 세트를 생성합니다.
  • 브랜드 모니터링: 웹 전반에서 브랜드, 제품 또는 경영진이 어떻게 언급되는지 실시간으로 추적합니다.

Crawly의 장점

Crawly의 주요 장점은 단순성과 강력함입니다. 웹 데이터 추출을 민주화하여 비개발자도 일반적으로 엔지니어 팀이 필요한 작업을 수행할 수 있게 합니다. 전체 스크래핑 프로세스를 자동화하여 막대한 시간과 자원을 절약합니다. 또한 AI 기반 접근 방식은 기존 방법보다 높은 정확도와 뛰어난 복원력을 보장하여 신뢰할 수 있는 고품질 데이터 스트림을 제공합니다. Diffbot의 제품으로서 전 세계 주요 기업들이 신뢰하는 엔터프라이즈급 기술의 지원을 받습니다.

가격 및 플랜

Crawly는 홈페이지에서 직접 무료 평가판 크롤링을 제공하여 사용자가 URL과 이메일 주소를 입력하여 기능을 테스트할 수 있도록 합니다. 이는 도구가 생성할 수 있는 구조화된 데이터의 샘플을 제공하기 위해 설계되었습니다. 대규모 크롤링, 빈번한 데이터 추출 또는 프로그래밍 방식 사용을 위한 API 액세스와 같은 더 광범위한 요구 사항의 경우, 사용자는 일반적으로 모회사인 Diffbot이 제공하는 전체 도구 제품군에 가입해야 합니다. Diffbot의 가격은 계층화되어 있으며, 스타트업, 비즈니스 및 대기업을 위한 플랜이 제공되며 다양한 수준의 API 호출 및 기능을 제공합니다.

제품 포지셔닝

분류 체계는 제품의 공통 영역과 각 제품의 뚜렷한 초점을 보여 줍니다. 확인되지 않은 필드는 명확히 표시하며 추측으로 채우지 않습니다.

카테고리

공통
웹 스크래핑API시장 조사
전용 Bright Data
비즈니스 인텔리전스
전용 Crawly
자동화

태그

공통
API데이터 추출시장 조사구조화된 데이터웹 스크래핑
전용 Bright Data
AI 훈련 데이터대체 데이터데이터 수집전자상거래 데이터프록시
전용 Crawly
자동화DiffbotJSON리드 생성노코드웹 크롤러

대상과 직무

공통
검증된 데이터 없음
전용 Bright Data
검증된 데이터 없음
전용 Crawly
검증된 데이터 없음

트래픽 비교

시장 가시성 차이를 왜곡하지 않도록 동일한 척도로 표시합니다.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Bright Data monthly traffic:

Latest traffic · 2026-05

월 방문
810.9K
평균 방문 시간
3:21
방문당 페이지
4.77
이탈률
42.51%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 771K
  • 2026-01: 735.5K
  • 2026-02: 714.5K
  • 2026-03: 830.2K
  • 2026-04: 833K
  • 2026-05: 810.9K

주요 지역

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States46.92%380.5K
🇨🇳China21.71%176.1K
🇮🇳India13.14%106.6K
🇬🇧United Kingdom10.78%87.4K
🇻🇳Vietnam7.45%60.4K

트래픽 소스

Source typePercentageEstimated visits
직접86.27%699.6K
리퍼럴10.39%84.3K
이메일3.34%27.1K

검색 키워드

apifybright databrightdatasnapchatwayback machine

Crawly monthly traffic:

Latest traffic · 2026-05

월 방문
1.8K
평균 방문 시간
0:31
방문당 페이지
1.15
이탈률
93.85%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

주요 지역

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

검색 키워드

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

커뮤니티 신호

평점과 반응은 커뮤니티 신호이며 제품 적합성을 대신하지 않습니다.

Bright Data

평점
확인되지 않음
댓글
0
즐겨찾기
140
좋아요
156

Crawly

평점
확인되지 않음
댓글
0
즐겨찾기
162
좋아요
160

Bright Data vs Crawly · 비교 FAQ

What do Bright Data and Crawly have in common?
Both tools are listed under 웹 스크래핑、API、시장 조사. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Bright Data and Crawly free?
Listed pricing models: Bright Data — Paid; Crawly — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Bright Data and Crawly?
The primary listed category is 비즈니스 인텔리전스 for Bright Data, and 웹 스크래핑 for Crawly. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

관련 비교