Browserless
데이터 추출
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
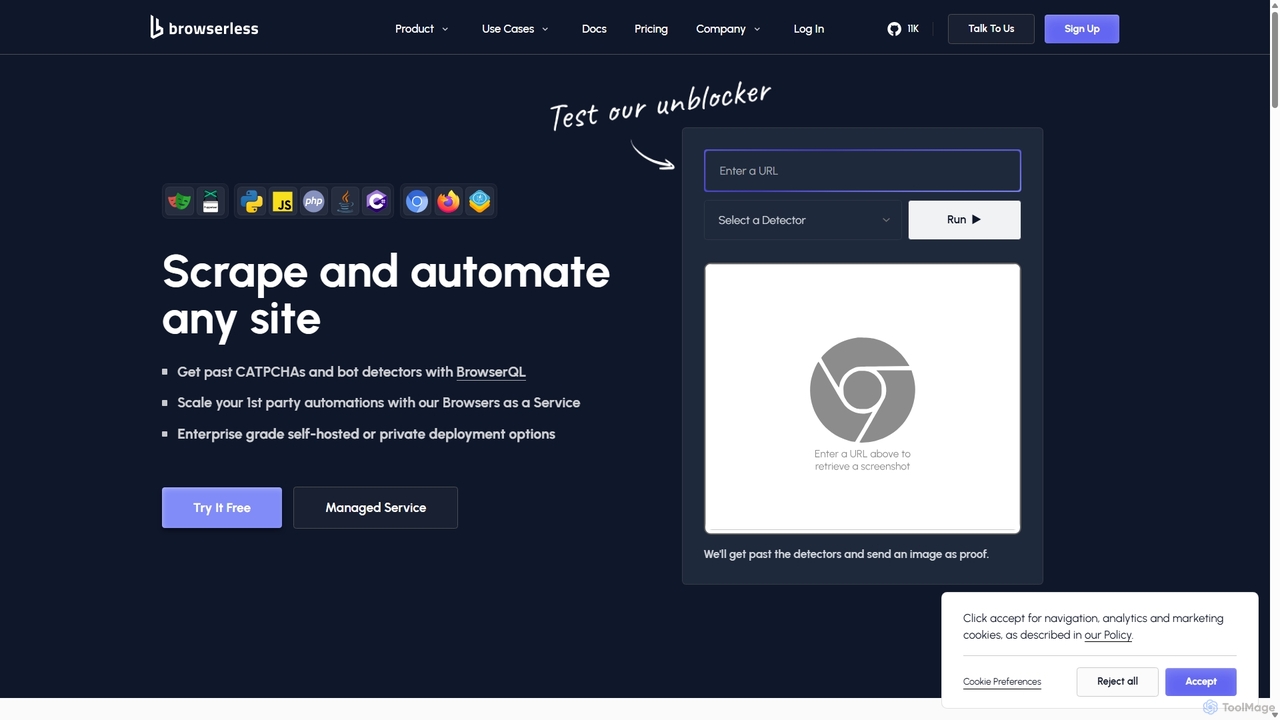
Browserless는 확장 가능한 웹 스크래핑 및 브라우저 자동화를 위해 설계된 강력한 BaaS(Browser-as-a-Service) 플랫폼입니다. 개발자가 Puppeteer, Playwright 또는 독점적인 BrowserQL 언어를 사용하여 CAPTCHA 및 봇 탐지기를 손쉽게 우회할 수 있도록 지원합니다. 이 서비스는 브라우저 인프라를 관리하여 사용자가 업데이트, 메모리 누수 또는 확장에 대한 걱정 없이 자동화 스크립트 구축에 집중할 수 있도록 합니다.
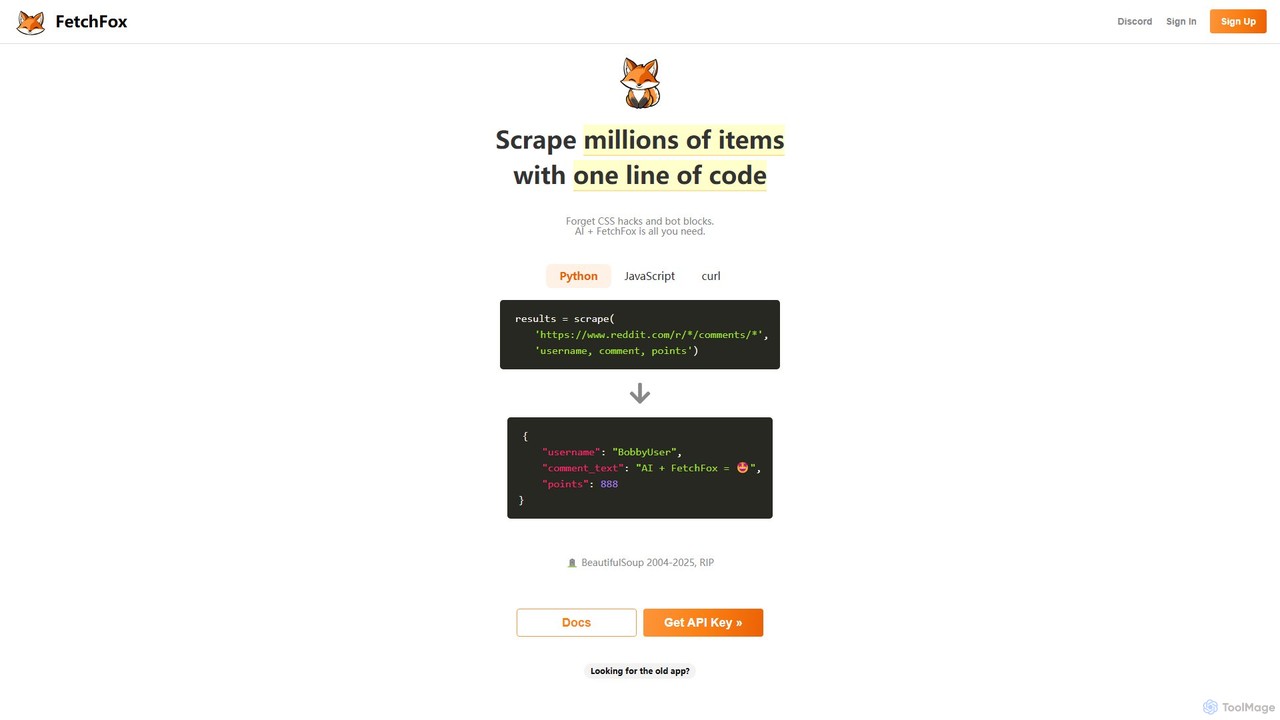
FetchFox는 AI 기반 웹 스크래핑 도구로, 사용자가 간단한 텍스트 프롬프트를 사용하여 모든 웹사이트에서 데이터를 추출할 수 있도록 합니다. 복잡한 코딩이나 CSS 선택자가 필요 없으며, 봇 차단 조치를 자동으로 처리합니다. API, JavaScript 라이브러리, Chrome 확장 프로그램으로 제공되어 개발자와 비기술 사용자 모두 손쉽게 데이터 수집을 자동화할 수 있도록 설계되었습니다.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| 핵심 정보 | Browserless | FetchFox |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | 데이터 추출 | 데이터 추출 |
| 대상과 직무 | 데이터 분석가 · 데이터 과학자 · 데브옵스 엔지니어 · 마케팅 매니저 · 프로덕트 매니저 · QA 엔지니어 · 소프트웨어 개발자 | 확인되지 않음 |
| 카테고리 | 데이터 추출 · 웹 스크래핑 · 자동화 | 데이터 추출 · 웹 스크래핑 · 리드 생성 · 자동화 |
| Added | 2025. 9. 15. | 2025. 8. 13. |
| 업데이트 | 2026. 11. 19. | 2026. 11. 19. |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Browserless는 광범위한 웹 자동화 및 데이터 추출 작업을 위한 헤드리스 브라우저 인스턴스를 제공하는 포괄적인 클라우드 기반 플랫폼입니다. 인프라 관리, 성능 문제, 정교한 봇 탐지 시스템 회피와 같이 개발자가 대규모로 헤드리스 브라우저를 사용할 때 직면하는 일반적인 문제를 해결하기 위해 구축되었습니다. Browserless는 강력한 관리형 브라우저 풀을 제공함으로써 개발자와 기업이 브라우저 자동화 시스템 배포 및 유지 관리의 복잡성보다는 핵심 로직에 집중할 수 있도록 합니다.
이 서비스는 신뢰성, 확장성 및 고급 기능으로 스타트업부터 대기업에 이르기까지 수천 개의 회사로부터 신뢰를 받고 있습니다. 관리형 클라우드 서비스와 자체 호스팅 엔터프라이즈 솔루션을 모두 제공하여 SOC 2 Type II 규정 준수를 포함한 다양한 보안 및 규정 준수 요구 사항에 대한 유연성을 제공합니다.
Browserless는 워크플로에 서비스를 통합하는 여러 가지 방법을 제공하여 다양한 기술 수준과 프로젝트 요구 사항에 맞게 사용할 수 있습니다.
Browserless는 다재다능하며 다양한 시나리오에 적용될 수 있습니다.
Browserless를 사용하면 다음과 같은 몇 가지 주요 이점이 있습니다.
Browserless는 다양한 요구에 맞는 유연한 단위 기반 가격 모델을 제공합니다.
"유닛"은 최대 30초의 브라우저 시간에 해당합니다. 더 긴 세션은 추가 유닛을 소모합니다. 유닛은 주거용 프록시 및 성공적인 CAPTCHA 해결에도 사용됩니다.
FetchFox는 웹에서 데이터 추출 과정을 단순화하고 자동화하기 위해 설계된 혁신적인 AI 기반 웹 스크래핑 플랫폼입니다. 복잡한 코딩, CSS 선택자, 깨지기 쉬운 스크립트 유지를 간단하고 자연스러운 언어 프롬프트로 대체하여 사용자가 웹 스크래핑에 접근하는 방식을 근본적으로 바꿉니다. 애플리케이션에 데이터를 통합해야 하는 개발자이든, 시장 정보를 수집하려는 비즈니스 사용자이든, FetchFox는 강력하고 접근성 높은 솔루션을 제공합니다.
FetchFox의 핵심 원리는 웹페이지의 구조와 콘텐츠를 지능적으로 이해하는 AI 엔진입니다. 사용자는 추출하고자 하는 데이터를 설명하기만 하면 AI가 나머지 작업을 처리합니다. 여기에는 페이지 탐색, 관련 데이터 포인트 식별, 출력을 JSON과 같은 깨끗하고 사용 가능한 형식으로 구조화하는 작업이 포함됩니다. 이 플랫폼은 웹사이트 레이아웃 변경에 자동으로 적응하고 CAPTCHA 및 IP 차단과 같은 일반적인 스크래핑 방지 기술을 우회하도록 설계되어 있어 기존 스크래핑 방법의 주요 장애물을 극복합니다.
FetchFox는 다양한 사용자 요구에 맞춰 유연한 사용 방법을 제공합니다:
1. 개발자용 (API 및 라이브러리):
2. 비기술 사용자용 (Chrome 확장 프로그램):
FetchFox는 다재다능하며 다양한 산업과 역할에 적용될 수 있습니다:
FetchFox의 주요 장점은 급진적인 단순성과 강력함입니다. 웹 스크래핑을 민주화하여 기술적 배경이 없는 사용자도 접근할 수 있게 만듭니다. 개발자에게는 스크래핑의 가장 지루하고 어려운 측면을 추상화하여 개발 프로세스를 크게 단축시킵니다. 웹사이트 변경에 대한 복원력은 깨진 스크립트를 유지하는 데 드는 시간을 줄이고 데이터 활용에 더 집중할 수 있게 해줍니다. 강력한 AI 엔진과 견고한 인프라의 결합은 모든 데이터 추출 작업에 매우 효율적이고 신뢰할 수 있는 도구입니다.
FetchFox는 간단하고 투명한 종량제 가격 모델을 사용합니다.
분류 체계는 제품의 공통 영역과 각 제품의 뚜렷한 초점을 보여 줍니다. 확인되지 않은 필드는 명확히 표시하며 추측으로 채우지 않습니다.
시장 가시성 차이를 왜곡하지 않도록 동일한 척도로 표시합니다.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇧🇷Brazil | 28.09% | 68K |
| 🇺🇸United States | 26.55% | 64.3K |
| 🇨🇭Switzerland | 23.8% | 57.6K |
| 🇨🇦Canada | 11.55% | 28K |
| 🇪🇸Spain | 10.01% | 24.2K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| 직접 | 81.79% | 198K |
| 리퍼럴 | 13.74% | 33.3K |
| 이메일 | 4.47% | 10.8K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇮🇳India | 45.78% | 18.5K |
| 🇺🇸United States | 44.91% | 18.1K |
| 🇪🇸Spain | 9.31% | 3.8K |
평점과 반응은 커뮤니티 신호이며 제품 적합성을 대신하지 않습니다.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.