
ToolMage
Entrar

Best 1 Big Data AI tools for Infraestrutura de IA

Popular Big Data AI tools in Infraestrutura de IA include LakeSail, helping you work more efficiently.

LakeSail
Freemium

LakeSail

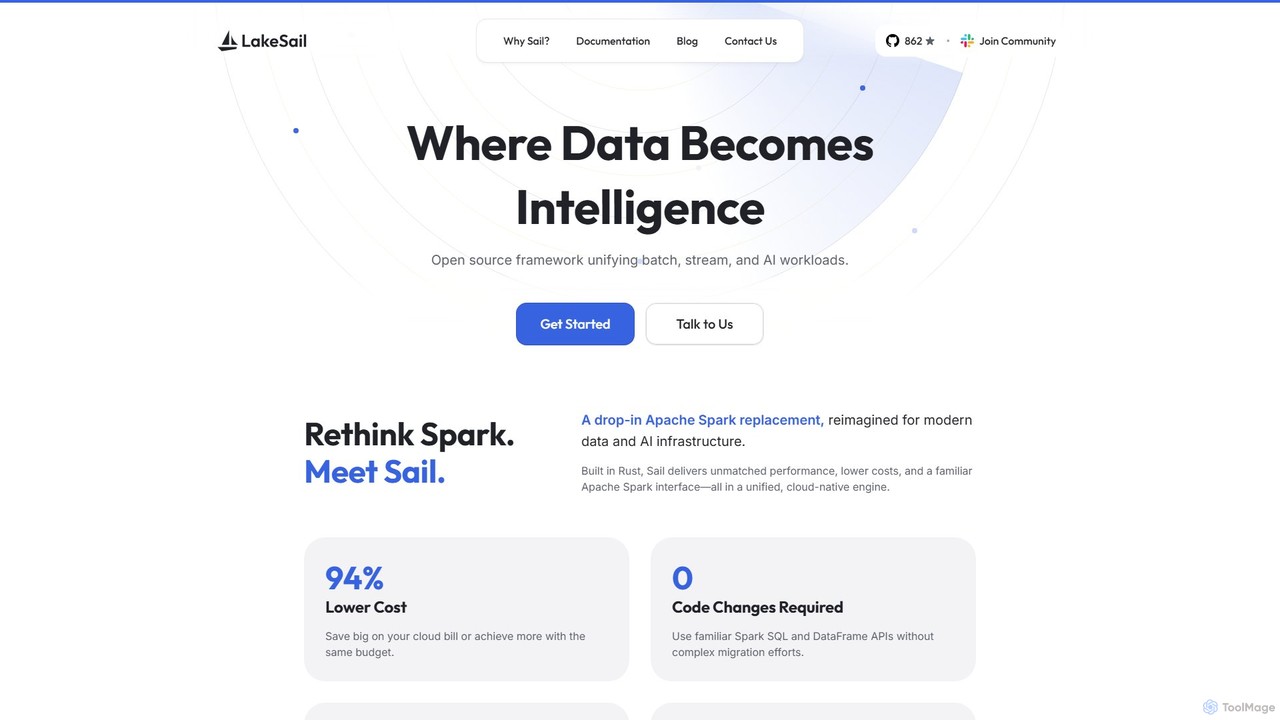
O LakeSail oferece um framework de código aberto de alto desempenho chamado Sail, projetado como um substituto direto para o Apache Spark. Construído em Rust, ele unifica cargas de trabalho de lote, streaming e IA, oferecendo execução até 8x mais rápida e custos de nuvem 94% menores, sem exigir alterações de código. Ele elimina a sobrecarga da JVM para eficiência e escalabilidade superiores em infraestruturas modernas de dados e IA.

Big Data
Visits 13.1KFavorites 139Likes 155

About Big Data

As ferramentas de Big Data são plataformas especializadas projetadas para processar, gerenciar e analisar conjuntos de dados massivos e complexos que excedem as capacidades do software de processamento de dados tradicional. Como um componente central da Infraestrutura de IA, essas ferramentas utilizam frameworks de computação distribuída e processamento paralelo para lidar com o grande volume, velocidade e variedade da informação. Elas permitem que as organizações extraiam insights valiosos, identifiquem padrões ocultos e construam modelos preditivos a partir de seus dados. Essa capacidade é fundamental para treinar modelos de aprendizado de máquina em grande escala e para alimentar aplicações de IA intensivas em dados.

Recursos Principais

  • Processamento Distribuído: Executa consultas complexas e transformações de dados em múltiplos servidores simultaneamente usando frameworks como Apache Spark ou Hadoop.
  • Armazenamento Escalável: Oferece soluções de armazenamento flexíveis, como data lakes ou sistemas de arquivos distribuídos (como HDFS), que podem escalar para petabytes e além.
  • Ingestão de Dados em Tempo Real: Captura e processa fluxos contínuos de dados de fontes como dispositivos IoT, feeds de mídias sociais e logs de aplicativos.
  • Análise Avançada e Integração com ML: Fornece bibliotecas e APIs integradas para tarefas de aprendizado de máquina, análise estatística e mineração de dados diretamente em grandes conjuntos de dados.

Cenários de Aplicação

As ferramentas de Big Data são essenciais em indústrias que lidam com vastas quantidades de informação. Por exemplo, os serviços financeiros as utilizam para detecção de fraudes em tempo real e análise de risco. As plataformas de comércio eletrônico dependem delas para alimentar motores de recomendação personalizados e otimizar cadeias de suprimentos. Na área da saúde, são usadas para analisar dados genômicos e registros de pacientes para avançar na pesquisa médica.

Critérios de Seleção

Ao escolher uma ferramenta de Big Data, considere sua escalabilidade para garantir que ela possa lidar com o crescimento futuro dos dados. Avalie suas capacidades de processamento — se você precisa de processamento de fluxo em tempo real ou processamento em lote. Analise seu ecossistema de integração para compatibilidade com suas ferramentas de BI e frameworks de aprendizado de máquina existentes. Por fim, considere o modelo de implantação (nuvem, local ou híbrido) e a expertise técnica necessária para gerenciar a plataforma.

Big Data use cases

1

Previsão de Churn de Clientes em Telecomunicações

Uma equipe de ciência de dados em uma grande empresa de telecomunicações usa uma plataforma de big data para reduzir o churn de clientes. Eles ingerem terabytes de dados diários, incluindo registros detalhados de chamadas, uso da rede, informações de faturamento e interações de suporte ao cliente. Usando processamento distribuído, eles limpam e agregam esses dados para criar perfis de cliente abrangentes. A equipe então aplica algoritmos de aprendizado de máquina na plataforma para construir um modelo preditivo que identifica clientes com alto risco de sair. Isso permite que a equipe de marketing lance campanhas de retenção direcionadas, oferecendo descontos personalizados ou atualizações de serviço, reduzindo o churn em uma porcentagem mensurável.

2

Detecção de Fraude em Tempo Real para Serviços Financeiros

Uma instituição financeira implementa uma plataforma de streaming de big data em tempo real para combater fraudes. O sistema ingere milhões de eventos de transação por segundo de várias fontes, como pagamentos com cartão de crédito, pagamentos online e saques em caixas eletrônicos. Ele analisa continuamente esses fluxos em comparação com dados históricos e padrões complexos de fraude usando modelos de aprendizado de máquina. Se uma transação se desviar do comportamento normal de um usuário ou corresponder a uma assinatura de fraude conhecida, o sistema a sinaliza instantaneamente e pode acionar um alerta ou bloquear a transação em milissegundos. Essa abordagem proativa reduz significativamente as perdas financeiras e protege as contas dos clientes sem impactar a experiência do usuário.

3

Otimização de Cadeias de Suprimentos com Análise Preditiva

Uma empresa de logística global utiliza uma plataforma de análise de big data para aprimorar a eficiência de sua cadeia de suprimentos. A plataforma integra dados de diversas fontes, incluindo rastreadores GPS em veículos, previsões do tempo, dados de tráfego e sistemas de inventário de armazéns. Ao analisar este vasto conjunto de dados, os analistas de dados podem construir modelos que preveem os tempos de entrega com alta precisão, identificam rotas de envio ideais em tempo real e preveem a demanda para evitar rupturas de estoque ou excesso de estoque. Essa abordagem orientada por dados leva à redução dos custos de combustível, melhores taxas de entrega no prazo e uma cadeia de suprimentos mais resiliente, capaz de se adaptar a interrupções imprevistas.

4

Personalização de Experiências do Cliente em E-commerce

Um gigante do varejo online usa uma plataforma de big data para criar experiências de compra altamente personalizadas. O sistema coleta e processa dados em tempo real sobre o comportamento do usuário, como cliques, produtos visualizados, itens adicionados ao carrinho e compras anteriores. Esses dados são combinados com informações demográficas para alimentar um sofisticado motor de recomendação. À medida que um usuário navega no site, o motor sugere produtos relevantes, cria páginas iniciais personalizadas и envia promoções por e-mail direcionadas. Esse nível de personalização, possibilitado pelo processamento de conjuntos de dados massivos, aumenta significativamente o engajamento do usuário, as taxas de conversão e o valor médio do pedido.

5

Avançando a Pesquisa Médica com Análise de Dados Genômicos

Um instituto de pesquisa biomédica usa uma plataforma de big data para analisar petabytes de dados de sequenciamento genômico. Processar esses dados com métodos tradicionais seria proibitivamente lento. As capacidades de computação distribuída da plataforma permitem que os pesquisadores executem pipelines complexos de bioinformática, realizem estudos de associação genômica ampla e identifiquem marcadores genéticos ligados a doenças como câncer e Alzheimer. Ao acelerar a análise de vastos conjuntos de dados genômicos, essas ferramentas capacitam os cientistas a fazer avanços na medicina personalizada, na descoberta de medicamentos e na compreensão da base genética da saúde humana.

6

Habilitação da Manutenção Preditiva na Manufatura

Um fabricante de máquinas pesadas equipa seus produtos com sensores IoT que transmitem dados operacionais como temperatura, vibração e pressão. Esses dados são inseridos em uma plataforma de big data para análise em tempo real. Os engenheiros de dados constroem modelos que detectam anomalias sutis nos fluxos de dados, que muitas vezes precedem a falha do equipamento. Quando o sistema prevê uma falha potencial, ele gera automaticamente um alerta de manutenção para as equipes de serviço. Essa mudança da manutenção reativa para a preditiva permite que a empresa agende reparos antes que uma avaria ocorra, minimizando o tempo de inatividade dispendioso, prolongando a vida útil do equipamento e melhorando a satisfação do cliente.

Big Data FAQ

O que são ferramentas de Big Data com IA?

As ferramentas de Big Data com IA são plataformas de software projetadas para gerenciar e analisar conjuntos de dados que são muito grandes ou complexos para os sistemas de banco de dados tradicionais. Elas são caracterizadas por sua capacidade de lidar com os '3 Vs': alto Volume (de terabytes a petabytes), alta Velocidade (dados de streaming em tempo real) e alta Variedade (dados estruturados, semiestruturados e não estruturados). Como parte fundamental da infraestrutura de IA, elas usam computação distribuída para processar dados em muitos servidores, permitindo tarefas como preparação de dados em grande escala, engenharia de recursos e treinamento de modelos de aprendizado de máquina.

Como escolher a plataforma de Big Data certa?

A escolha da plataforma de Big Data certa depende de vários fatores. Considere o seguinte:

  • Tipo e Volume de Dados: Avalie suas necessidades de dados atuais e futuras. Você lida principalmente com dados estruturados ou uma mistura que inclui arquivos não estruturados e fluxos em tempo real?
  • Necessidades de Processamento: Determine se você precisa de processamento em lote para trabalhos grandes e periódicos (como o Apache Hadoop) ou processamento de fluxo em tempo real para insights imediatos (como o Apache Flink ou Spark Streaming).
  • Ecossistema e Integração: Verifique a compatibilidade com suas ferramentas existentes, como software de BI, ferramentas de visualização de dados e bibliotecas de aprendizado de máquina.
  • Habilidades e Gerenciamento: Avalie a expertise técnica de sua equipe. Serviços de nuvem gerenciados (por exemplo, Google BigQuery, Amazon Redshift) exigem menos sobrecarga operacional do que soluções auto-hospedadas.
Qual é a diferença entre uma plataforma de Big Data e um banco de dados tradicional?

A principal diferença reside na escala, na estrutura dos dados и no paradigma de processamento. Os bancos de dados tradicionais (como os bancos de dados SQL) são otimizados para dados estruturados e operações transacionais (OLTP) em um único servidor, com escalabilidade limitada. As plataformas de Big Data são projetadas para ambientes distribuídos para lidar com volumes massivos de dados estruturados, semiestruturados e não estruturados. Elas se destacam em consultas analíticas (OLAP) em grandes conjuntos de dados e podem escalar horizontalmente adicionando mais servidores ao cluster, tornando-as adequadas para cargas de trabalho de IA e análise intensivas em dados.

Quais são os componentes chave de um ecossistema de Big Data?

Um ecossistema de Big Data típico consiste em várias camadas. Os componentes chave incluem:

  • Ingestão de Dados: Ferramentas para coletar dados de várias fontes (por exemplo, Apache Kafka, Flume).
  • Armazenamento de Dados: Sistemas de armazenamento escaláveis como o Hadoop Distributed File System (HDFS) ou armazenamento de objetos na nuvem (por exemplo, Amazon S3).
  • Processamento de Dados: Frameworks que realizam computação nos dados (por exemplo, Apache Spark, Apache Flink, MapReduce).
  • Consulta e Análise de Dados: Ferramentas que permitem aos usuários consultar e analisar os dados processados (por exemplo, Apache Hive, Presto e bibliotecas de ML como Spark MLlib).
  • Gerenciamento de Recursos: Um componente que gerencia os recursos do cluster (por exemplo, YARN, Kubernetes).
Quem normalmente usa ferramentas de Big Data em uma organização?

Vários papéis dentro de uma organização usam ferramentas de Big Data. Os Engenheiros de Dados são os principais usuários que constroem e mantêm a arquitetura e os pipelines de dados, garantindo que os dados estejam limpos e acessíveis. Os Cientistas de Dados usam essas plataformas para explorar dados, construir e treinar modelos complexos de aprendizado de máquina em escala. Os Analistas de Dados e Analistas de Negócios também as utilizam, muitas vezes através de interfaces de nível superior, como consultas SQL ou painéis de BI, para extrair insights, gerar relatórios e apoiar a tomada de decisões estratégicas sem a necessidade de gerenciar a infraestrutura subjacente.