ToolMage
Entrar

Best 1 Geração de Dados AI tools for Infraestrutura de IA

Popular Geração de Dados AI tools in Infraestrutura de IA include Datacurve, helping you work more efficiently.

Datacurve
Paid

Datacurve

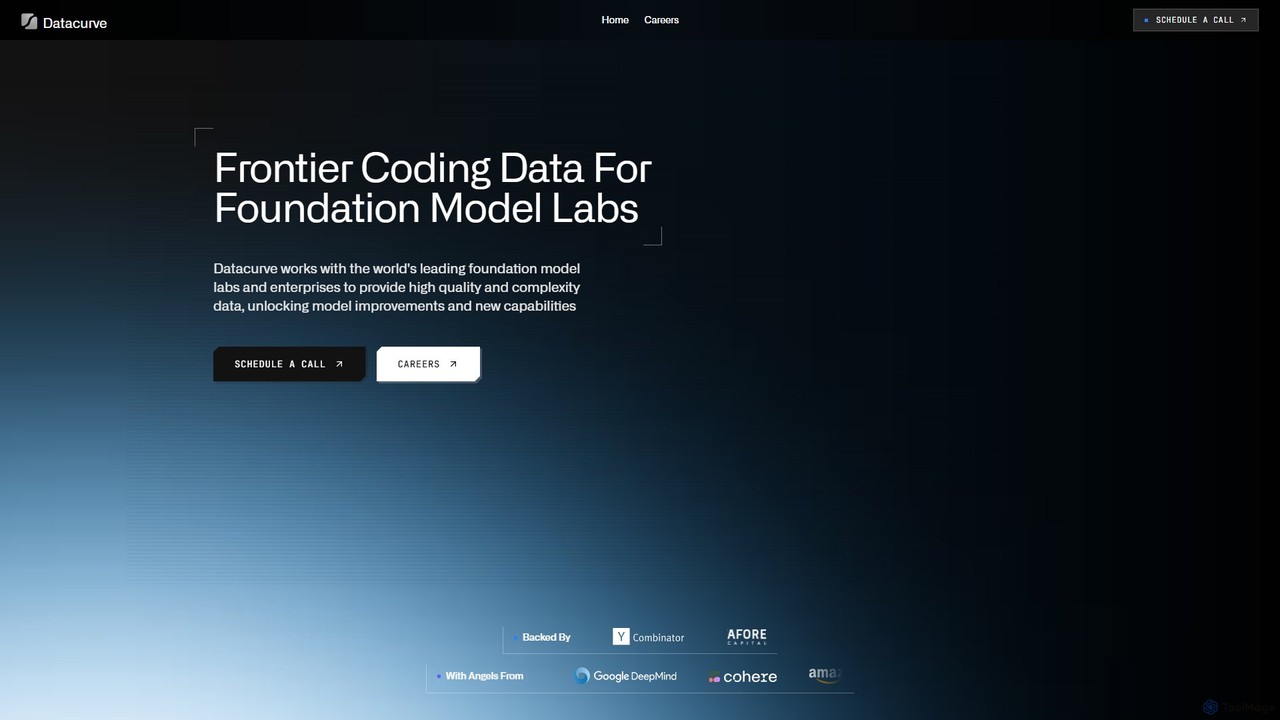
A Datacurve fornece dados de codificação complexos e de alta qualidade para treinar e avaliar modelos de fundação de IA avançados. Especializada em formatos como SFT, RLHF e rastreamentos de fluxo de trabalho agêntico, utiliza uma plataforma gamificada com mais de 14.000 engenheiros para gerar dados de fronteira. Seu serviço é projetado para os principais laboratórios de IA e empresas que buscam desbloquear novas capacidades de modelo e melhorar o desempenho através de qualidade, escala e velocidade de dados superiores.

Geração de Dados
Visits 101.7KFavorites 110Likes 120

About Geração de Dados

As ferramentas de Geração de Dados são uma classe de sistemas de IA projetados para criar novos dados sintéticos que espelham estatisticamente informações do mundo real. Essas ferramentas utilizam modelos avançados como Redes Geradoras Adversariais (GANs) ou Autoencoders Variacionais (VAEs) para produzir conjuntos de dados de alta fidelidade do zero ou com base em amostras existentes. Seu valor principal reside em resolver a escassez de dados, proteger a privacidade e permitir testes de sistema robustos onde dados reais não estão disponíveis ou são sensíveis. Como um componente chave da Infraestrutura de IA, elas fornecem a matéria-prima fundamental necessária para treinar, validar e implantar outros modelos de IA de forma eficaz.

Recursos Principais

  • Criação de Dados Sintéticos: Gera dados estruturados (tabulares, CSV) e não estruturados (imagens, texto, áudio) que imitam os padrões e correlações de um conjunto de dados de origem.
  • Anonimização de Dados: Cria conjuntos de dados que preservam a privacidade, substituindo informações de identificação pessoal (PII) por equivalentes sintéticos realistas, auxiliando na conformidade com regulamentos como o GDPR.
  • Aumento de Dados: Expande conjuntos de dados pequenos ou desbalanceados gerando amostras novas e diversas, particularmente útil para treinar modelos em eventos raros.
  • Geração Controlável: Permite que os usuários definam parâmetros, distribuições e condições específicas para gerar dados para cenários de teste ou simulação direcionados.
  • Métricas de Fidelidade e Utilidade: Fornece ferramentas para avaliar a semelhança estatística entre dados sintéticos e reais, garantindo que os dados gerados sejam úteis para o propósito pretendido.

Casos de Uso

As ferramentas de Geração de Dados são cruciais em setores como finanças para treinar modelos de detecção de fraudes sem usar dados sensíveis de clientes, na saúde para criar dados anônimos de pacientes para pesquisa, e no desenvolvimento de software para gerar dados realistas em grande escala para testes de carga de aplicativos. Elas também são amplamente utilizadas por engenheiros de aprendizado de máquina para equilibrar conjuntos de dados e melhorar a robustez do modelo.

Como Escolher

Ao selecionar uma ferramenta de Geração de Dados, considere o tipo de dados que você precisa gerar (por exemplo, tabular, imagem, série temporal). Avalie o equilíbrio entre a fidelidade dos dados (o quão próximos eles são dos dados reais) e as garantias de privacidade (como privacidade diferencial). Avalie sua escalabilidade para lidar com grandes conjuntos de dados e sua facilidade de uso — se é uma biblioteca focada em desenvolvedores ou uma plataforma sem código. Por fim, verifique suas capacidades de integração com seus pipelines de dados e frameworks de aprendizado de máquina existentes.

Geração de Dados use cases

1

Treinamento de um Modelo de Detecção de Fraude

Uma empresa de tecnologia financeira está desenvolvendo um modelo de IA para detectar transações fraudulentas. Seu conjunto de dados do mundo real é altamente desbalanceado, com poucos exemplos de fraude, o que prejudica a precisão do modelo. Usando uma ferramenta de geração de dados, sua equipe de ciência de dados cria um grande volume de dados de transações fraudulentas sintéticas e realistas. Esses dados sintéticos capturam os padrões complexos da fraude real sem expor nenhuma informação sensível do cliente. Ao aumentar seu conjunto de treinamento com esses dados, eles conseguem equilibrar o conjunto de dados, resultando em um modelo que pode identificar atividades fraudulentas com precisão e recall significativamente maiores.

2

Geração de Dados Realistas para Testes de Carga de Software

Uma equipe de desenvolvimento de software está se preparando para lançar uma nova plataforma de e-commerce. Para garantir que o sistema possa lidar com o tráfego de pico, eles precisam realizar testes de carga extensivos. Criar manualmente um conjunto de dados de teste suficientemente grande e realista é impraticável. A equipe usa uma ferramenta de geração de dados para criar milhões de perfis de usuário, listas de produtos e históricos de transações sintéticos. Isso permite que eles simulem vários cenários, como uma corrida de vendas na Black Friday, e identifiquem gargalos de desempenho no banco de dados e nos servidores de aplicação antes que a plataforma seja lançada, garantindo uma experiência de usuário estável e confiável.

3

Anonimização de Dados de Saúde para Colaboração em Pesquisa

Um instituto de pesquisa médica possui um valioso conjunto de dados de registros de pacientes, mas não pode compartilhá-lo diretamente com colaboradores externos devido a regulamentações de privacidade rigorosas como a HIPAA. Para facilitar a pesquisa, eles usam uma ferramenta de geração de dados para criar uma versão sintética do conjunto de dados. A ferramenta aprende as distribuições estatísticas e as correlações dos dados reais e gera um novo conjunto de dados artificial que é estrutural e estatisticamente idêntico. Este conjunto de dados sintético não contém informações reais de pacientes, permitindo que eles o compartilhem com segurança com instituições parceiras, acelerando descobertas médicas sem comprometer a privacidade do paciente.

4

Criação de Rostos Diversos para Auditoria de Viés em IA

Uma equipe de ética em IA tem a tarefa de auditar um sistema de reconhecimento facial em busca de viés demográfico. Os conjuntos de dados do mundo real disponíveis carecem de diversidade, especialmente para grupos étnicos sub-representados. Para realizar uma auditoria completa, a equipe usa uma ferramenta de IA generativa para criar um grande e balanceado conjunto de dados de rostos sintéticos. Eles podem especificar atributos como etnia, idade, gênero e até condições de iluminação. Isso permite que eles testem sistematicamente o sistema de reconhecimento em um amplo espectro de demografias, identifiquem fraquezas e vieses específicos e forneçam recomendações acionáveis à equipe de desenvolvimento para melhorar a justiça e a equidade.

5

Geração de Dados de Texto para Treinamento de Chatbots de Nicho

Uma startup está construindo um chatbot especializado para a indústria jurídica, mas os dados de conversas jurídicas disponíveis publicamente são escassos. Para treinar seu modelo de Processamento de Linguagem Natural (PNL) de forma eficaz, eles precisam de um grande corpus de texto relevante. Usando uma ferramenta de geração de dados, eles definem padrões e entidades específicas para consultas jurídicas (por exemplo, tipos de contrato, estatutos legais, citações de casos). A ferramenta então gera milhares de perguntas de usuários sintéticas e as explicações legais correspondentes. Este texto gerado permite que eles pré-treinem seu modelo em linguagem específica do domínio, melhorando significativamente a capacidade do chatbot de entender e responder com precisão às consultas de usuários reais desde o primeiro dia.

6

Simulação do Comportamento do Cliente para Análise de Mercado

Uma empresa de varejo quer testar uma nova estratégia de preços sem arriscar a receita real. Sua equipe de análise de marketing usa uma ferramenta de geração de dados para criar uma população sintética de clientes. Essa população espelha o comportamento demográfico e de compra de sua base de clientes real. Eles podem então executar simulações nesses dados sintéticos, modelando como diferentes segmentos de clientes podem reagir a mudanças de preços, promoções ou introdução de novos produtos. Isso permite que a empresa preveja resultados potenciais, refine sua estratégia e tome decisões baseadas em dados com maior confiança antes de implementá-las no mercado real.

Geração de Dados FAQ

O que é Geração de Dados por IA?

A Geração de Dados por IA é o processo de usar modelos de inteligência artificial, como GANs ou VAEs, para criar novos dados sintéticos que imitam as características dos dados do mundo real. Não se trata de copiar dados existentes, mas de aprender seus padrões estatísticos subjacentes e gerar pontos de dados inteiramente novos que aderem a esses padrões. Isso é usado para resolver problemas como escassez de dados (quando você não tem dados suficientes), preocupações com a privacidade (para evitar o uso de informações sensíveis) e desequilíbrio de dados (para criar mais exemplos de eventos raros para treinar modelos de IA).

Como escolher a ferramenta de Geração de Dados certa?

A escolha da ferramenta certa depende de suas necessidades específicas. Considere os seguintes fatores:

  • Tipo de Dados: A ferramenta suporta os dados com os quais você trabalha? Isso pode ser dados tabulares (como CSVs), imagens, texto ou dados de séries temporais.
  • Fidelidade vs. Privacidade: Determine sua prioridade. Algumas ferramentas se destacam na criação de dados altamente realistas (alta fidelidade), enquanto outras se concentram em fornecer fortes garantias matemáticas de privacidade, como a privacidade diferencial.
  • Escalabilidade: A ferramenta pode lidar com o volume de dados que você precisa gerar? Verifique seu desempenho em grandes conjuntos de dados.
  • Facilidade de Uso: É uma biblioteca baseada em código para cientistas de dados (por exemplo, bibliotecas Python) ou uma plataforma sem código e amigável para analistas de negócios? Escolha uma que corresponda às habilidades técnicas de sua equipe.
Qual é a diferença entre Geração de Dados e Aumento de Dados?

Geração de Dados e Aumento de Dados são conceitos relacionados, mas distintos. O Aumento de Dados geralmente se refere à criação de novos pontos de dados fazendo modificações pequenas e realistas nos dados existentes. Por exemplo, rotacionar uma imagem, alterar ligeiramente a redação de uma frase ou adicionar ruído a um arquivo de áudio. Ele expande um conjunto de dados, mas depende de ter um conjunto de dados inicial para modificar.

A Geração de Dados é um termo mais amplo. Pode incluir o aumento de dados, mas também se refere à criação de conjuntos de dados sintéticos inteiramente novos do zero, muitas vezes baseados apenas em modelos estatísticos aprendidos a partir de dados reais. Isso permite a criação de dados mesmo quando não há um conjunto de dados inicial disponível para modificação, ou para gerar dados com propriedades específicas e controladas para testes.

Por que usar dados sintéticos em vez de dados reais?

Existem várias razões importantes para usar dados sintéticos. A primeira é a privacidade; dados sintéticos não contêm informações de identificação pessoal (PII), tornando-os seguros para compartilhar e usar sem violar regulamentos como o GDPR ou a HIPAA. A segunda é o acesso e a disponibilidade de dados; dados reais podem ser escassos, caros ou demorados para coletar, especialmente para eventos raros como fraude financeira. Dados sintéticos podem ser gerados sob demanda em grandes quantidades. A terceira é o controle e o equilíbrio; você pode gerar conjuntos de dados perfeitamente balanceados para treinar modelos de IA mais justos ou criar cenários de casos extremos específicos para tornar os testes de software mais robustos. Esse nível de controle é muitas vezes impossível com dados coletados no mundo real.

Os dados sintéticos são tão bons quanto os dados reais para treinar IA?

Dados sintéticos de alta qualidade podem ser tão eficazes, e às vezes até mais eficazes, do que os dados reais para treinar modelos de IA. A qualidade é fundamental. Um bom conjunto de dados sintéticos captura com sucesso os complexos padrões estatísticos, correlações e distribuições dos dados reais nos quais se baseia. Quando isso é alcançado, pode levar a modelos com desempenho comparável aos treinados com dados reais. Nos casos em que os dados reais são ruidosos, incompletos ou muito desbalanceados, um conjunto de dados sintéticos limpo e balanceado pode, na verdade, resultar em um modelo mais robusto e justo. No entanto, a eficácia deve sempre ser validada testando o modelo final em um conjunto de dados reais de validação.