
ToolMage
Entrar

Best 1 Dados de Treinamento AI tools for Desenvolvimento de Modelo de IA

Popular Dados de Treinamento AI tools in Desenvolvimento de Modelo de IA include Label Studio, helping you work more efficiently.

Label Studio
Freemium

Label Studio

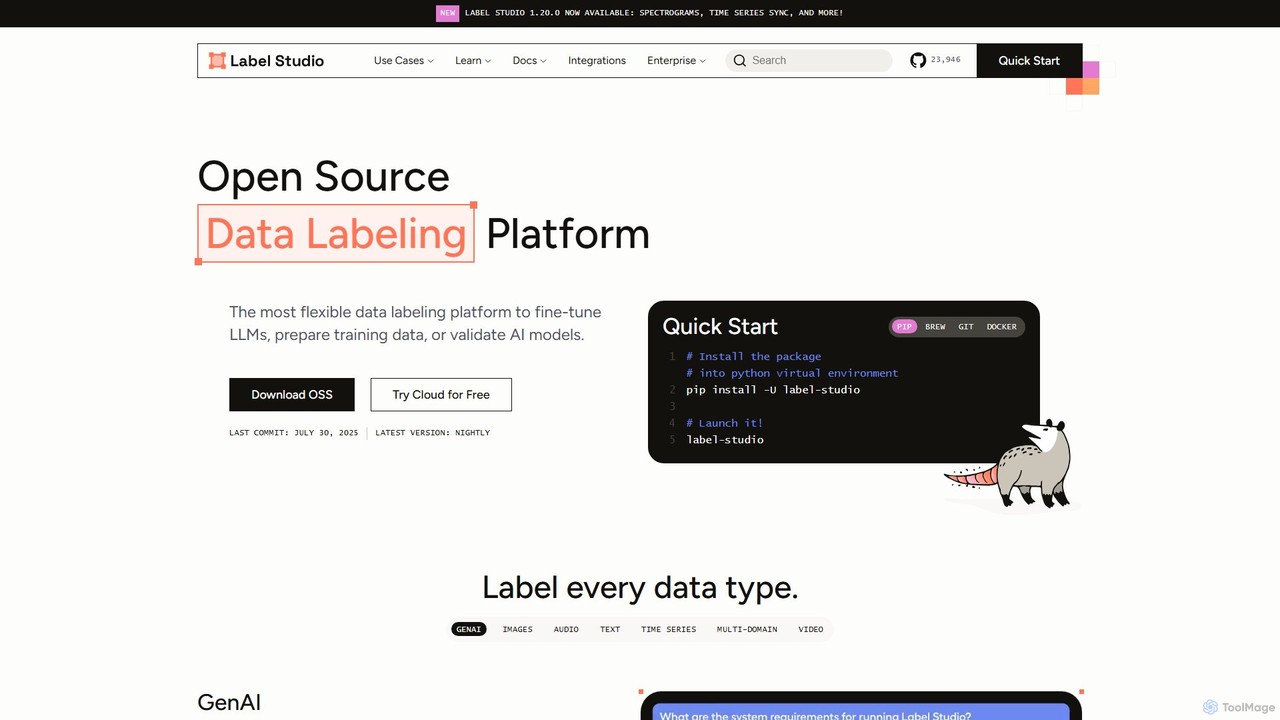
O Label Studio é uma plataforma versátil de rotulagem de dados de código aberto, projetada para uma ampla gama de tipos de dados. Ele permite que os usuários anotem imagens, texto, áudio, vídeo e dados de séries temporais para ajustar LLMs, preparar dados de treinamento para aprendizado de máquina e validar modelos de IA com feedback humano no ciclo.

Dados de Treinamento
Visits 268.1KFavorites 160Likes 171

About Dados de Treinamento

As ferramentas de Dados de Treinamento são plataformas especializadas impulsionadas por IA, projetadas para coletar, anotar e preparar conjuntos de dados de alta qualidade, essenciais para desenvolver e refinar modelos de aprendizado de máquina. Essas ferramentas otimizam a fase inicial crucial do desenvolvimento de modelos de IA, garantindo que os dados sejam rotulados e formatados com precisão. Elas permitem que os profissionais de IA construam modelos robustos que funcionam de forma confiável em várias aplicações, desde visão computacional até processamento de linguagem natural.

Principais Recursos

  • Coleta e Origem de Dados: Facilita a reunião de dados brutos diversos e relevantes de várias fontes.
  • Anotação e Rotulagem de Dados: Fornece interfaces e recursos assistidos por IA para marcar, categorizar e segmentar dados com precisão.
  • Aumento de Dados: Gera dados sintéticos ou modifica dados existentes para aumentar o tamanho e a diversidade do conjunto de dados.
  • Garantia e Validação de Qualidade: Implementa mecanismos para verificar a precisão da anotação e a consistência dos dados.
  • Controle de Versão e Gerenciamento de Dados: Rastreia alterações em conjuntos de dados, garantindo reprodutibilidade e fluxos de trabalho colaborativos.

Casos de Uso

Essas ferramentas são indispensáveis para pesquisadores de IA, cientistas de dados e engenheiros de aprendizado de máquina. Elas são usadas para preparar conjuntos de dados para treinar modelos de visão computacional para detecção de objetos, anotar texto para compreensão de linguagem natural ou rotular dados de sensores para sistemas de direção autônoma. O objetivo é transformar informações brutas em formatos estruturados e utilizáveis para a ingestão do modelo.

Como Escolher

Ao selecionar uma plataforma de dados de treinamento, considere os tipos de dados que você precisa processar (imagens, texto, áudio, vídeo), a complexidade das tarefas de anotação e os requisitos de escalabilidade para grandes conjuntos de dados. Avalie suas capacidades de integração com pipelines de ML existentes, o nível de automação oferecido para anotação e a robustez de seus recursos de controle de qualidade. Modelos de precificação e suporte para fluxos de trabalho colaborativos também são fatores importantes.

Dados de Treinamento use cases

1

Anotação de Imagens para Modelos de Visão Computacional

Um engenheiro de aprendizado de máquina precisa treinar um modelo de detecção de objetos para veículos autônomos. Ele usa uma plataforma de dados de treinamento para rotular precisamente milhares de imagens com caixas delimitadoras em torno de pedestres, veículos e sinais de trânsito. Essa anotação detalhada garante que o modelo identifique e localize objetos com precisão em cenários de condução do mundo real, crucial para a segurança e o desempenho.

2

Preparação de Dados de Texto para Processamento de Linguagem Natural

Um cientista de dados está construindo um modelo de PNL para análise de sentimento de avaliações de clientes. Ele utiliza ferramentas de dados de treinamento para anotar dados de texto, categorizando frases ou expressões como positivas, negativas ou neutras. Esse processo envolve a identificação de entidades-chave e relacionamentos dentro do texto, permitindo que o modelo compreenda e classifique com precisão o tom emocional do feedback do cliente.

3

Geração de Dados Sintéticos para Cenários Raros

Em setores como saúde ou finanças, dados do mundo real para eventos raros, mas críticos (por exemplo, surtos de doenças específicas, padrões de fraude), são escassos. Engenheiros de dados usam ferramentas de dados de treinamento com capacidades de aumento para gerar dados sintéticos que imitam esses cenários raros. Isso expande o conjunto de dados, permitindo que os modelos de IA sejam treinados em uma gama mais abrangente de situações, melhorando sua capacidade de detectar e responder a anomalias.

4

Transcrever e Anotar Áudio para Reconhecimento de Fala

Uma empresa que desenvolve um assistente de voz precisa de dados de áudio de alta qualidade para treinamento. Eles empregam ferramentas de dados de treinamento para transcrever a linguagem falada em texto e anotar elementos específicos como turnos de fala, ruído de fundo ou tom emocional. Esse processo meticuloso garante que o modelo de reconhecimento de fala possa converter com precisão diversas entradas de áudio em texto, melhorando a compreensão e a capacidade de resposta do assistente.

5

Validação e Limpeza de Conjuntos de Dados para Robustez do Modelo

Antes de implantar um modelo de IA, um especialista em qualidade de dados usa ferramentas de dados de treinamento para validar e limpar os conjuntos de dados preparados. Isso envolve identificar e corrigir inconsistências, remover entradas duplicadas e lidar com valores ausentes. Garantir que os dados estejam limpos e precisos evita que o modelo aprenda padrões errôneos, levando a um desempenho do sistema de IA mais robusto, justo e confiável em ambientes de produção.

6

Preparação de Dados Geoespaciais para Monitoramento Ambiental

Cientistas ambientais usam ferramentas de dados de treinamento para processar e rotular dados geoespaciais, como imagens de satélite ou filmagens de drones, para modelos de IA que monitoram o desmatamento, a expansão urbana ou os impactos das mudanças climáticas. Isso envolve segmentar tipos de cobertura do solo, identificar características específicas e rastrear mudanças ao longo do tempo. Dados geoespaciais rotulados de alta qualidade são críticos para desenvolver modelos preditivos precisos para a conservação ambiental e o gerenciamento de recursos.

Dados de Treinamento FAQ

O que são Dados de Treinamento em IA?

Dados de treinamento em IA referem-se à coleção de informações, como imagens, texto, áudio ou vídeo, que foi cuidadosamente preparada e rotulada para ensinar um modelo de aprendizado de máquina. Serve como entrada para o modelo durante sua fase de aprendizado, permitindo que ele identifique padrões, faça previsões ou execute tarefas específicas. Dados de treinamento de alta qualidade são fundamentais para construir modelos de IA eficazes e precisos, impactando diretamente seu desempenho e confiabilidade em aplicações do mundo real.

Como escolher a plataforma de Dados de Treinamento certa?

Escolher a plataforma de dados de treinamento certa envolve avaliar vários fatores-chave. Primeiro, considere os tipos de dados com os quais você trabalhará (por exemplo, imagens, texto, áudio, vídeo) e certifique-se de que a plataforma os suporte. Segundo, avalie suas capacidades de anotação, incluindo a variedade de ferramentas de anotação e o nível de assistência de IA. Terceiro, observe a escalabilidade para lidar com grandes volumes de dados e sua integração com seus pipelines de aprendizado de máquina existentes. Finalmente, avalie seus recursos de controle de qualidade, estrutura de preços e suporte para fluxos de trabalho colaborativos em equipe.

Qual é a diferença entre coleta e anotação de dados?

A coleta de dados envolve a reunião de informações brutas e não processadas de várias fontes, como web scraping, feeds de sensores ou bancos de dados existentes. A anotação de dados, por outro lado, é o processo de rotular ou marcar esses dados brutos coletados com atributos significativos para torná-los compreensíveis para modelos de aprendizado de máquina. Por exemplo, coletar imagens é coleta de dados, enquanto desenhar caixas delimitadoras em torno de objetos nessas imagens e rotulá-los é anotação de dados. Ambos são passos cruciais na preparação de dados de treinamento, mas a anotação adiciona o contexto necessário para o aprendizado de IA.

Por que dados de treinamento de alta qualidade são cruciais para modelos de IA?

Dados de treinamento de alta qualidade são cruciais porque influenciam diretamente a precisão, a justiça e a robustez dos modelos de IA. Os modelos aprendem com os padrões e exemplos presentes nos dados; se os dados forem tendenciosos, imprecisos ou incompletos, o modelo herdará essas falhas, levando a um desempenho ruim, previsões incorretas e resultados potencialmente prejudiciais. Dados limpos, diversos e rotulados com precisão garantem que o modelo generalize bem para dados novos e não vistos e funcione de forma confiável em cenários do mundo real, tornando-o confiável e eficaz.

Quais são os passos-chave na preparação de dados de treinamento?

A preparação de dados de treinamento geralmente envolve várias etapas-chave. Primeiro, a coleta de dados reúne informações brutas de fontes relevantes. Segundo, a limpeza e pré-processamento de dados envolve o tratamento de valores ausentes, a remoção de duplicatas e a transformação de dados em um formato consistente. Terceiro, a anotação e rotulagem de dados adiciona tags ou atributos significativos aos dados. Quarto, o aumento de dados expande o conjunto de dados criando variações. Finalmente, a garantia e validação de qualidade garantem a precisão e a consistência dos dados preparados antes de serem usados para treinar modelos de IA.