
ToolMage
Entrar

Best 1 Banco de Dados Vetorial AI tools for Ciência de Dados

Popular Banco de Dados Vetorial AI tools in Ciência de Dados include PostgresML, helping you work more efficiently.

PostgresML
Freemium

PostgresML

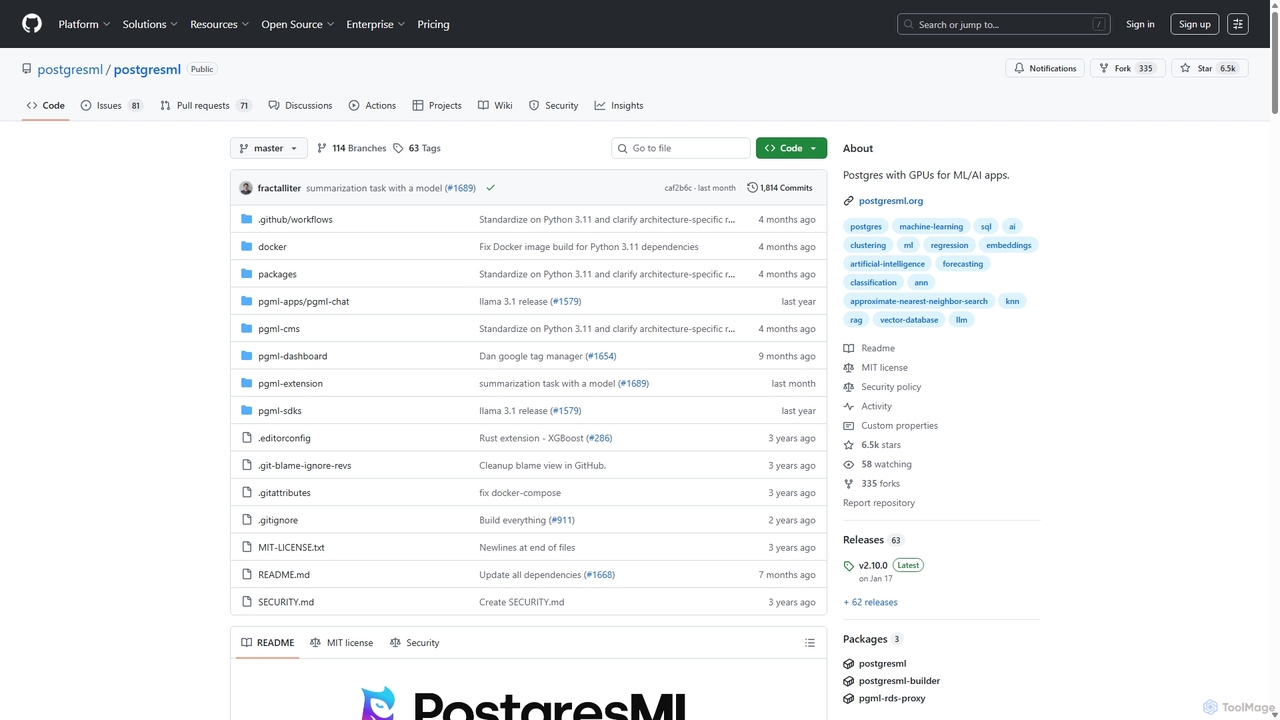
PostgresML é uma poderosa extensão de código aberto que integra machine learning e IA diretamente no seu banco de dados PostgreSQL. Ele permite inferência acelerada por GPU, busca vetorial e pipelines RAG completos usando comandos SQL simples, eliminando a movimentação de dados e simplificando a pilha de MLOps para aplicações de IA escaláveis e de alto desempenho.

MLOps
Visits 6.4KFavorites 137Likes 137

About Banco de Dados Vetorial

Um Banco de Dados Vetorial é um banco de dados especializado projetado para armazenar, gerenciar e pesquisar eficientemente embeddings vetoriais de alta dimensão. Diferente dos bancos de dados tradicionais que consultam com base em correspondências exatas, os bancos de dados vetoriais usam algoritmos de Vizinho Mais Próximo Aproximado (ANN) para encontrar itens com base em sua similaridade semântica. Isso permite que as aplicações entendam o contexto e as relações em dados complexos e não estruturados, como texto, imagens e áudio. Como um componente chave no stack de IA moderno, eles impulsionam recursos avançados como busca semântica, motores de recomendação e memória de longo prazo para grandes modelos de linguagem (LLMs).

Recursos Principais

  • Armazenamento de Vetores de Alta Dimensão: Lida e indexa nativamente vetores com centenas ou milhares de dimensões, que são saídas comuns de modelos de IA.
  • Busca por Vizinho Mais Próximo Aproximado (ANN): Fornece busca de similaridade ultrarrápida ao encontrar os vetores 'mais próximos' no banco de dados, permitindo desempenho em tempo real em conjuntos de dados massivos.
  • Filtragem de Metadados: Combina a busca por similaridade vetorial com a filtragem tradicional baseada em atributos, permitindo consultas complexas como "encontrar imagens semelhantes a esta, mas apenas aquelas com a tag 'externo'".
  • Escalabilidade e Desempenho: Projetado para escalonamento horizontal para gerenciar bilhões de vetores, mantendo respostas de consulta de baixa latência.
  • Indexação em Tempo Real: Suporta a adição contínua de novos vetores de dados sem degradação significativa de desempenho ou tempo de inatividade.

Casos de Uso

Bancos de dados vetoriais são cruciais para desenvolvedores e cientistas de dados que constroem aplicações nativas de IA. Eles são amplamente utilizados no comércio eletrônico para criar sistemas de recomendação de produtos, em software empresarial para construir buscas inteligentes em bases de conhecimento e em aplicações de IA generativa para fornecer memória de longo prazo para chatbots através da Geração Aumentada por Recuperação (RAG).

Como Escolher

Ao selecionar um banco de dados vetorial, considere suas métricas de desempenho, como latência de consulta e velocidade de indexação. Avalie o modelo de implantação — se você precisa de um serviço em nuvem totalmente gerenciado, uma solução auto-hospedada ou uma opção sem servidor. Além disso, avalie seu ecossistema, incluindo integrações com frameworks de IA populares como LangChain e LlamaIndex, e a flexibilidade de seus algoritmos ANN e capacidades de filtragem suportados.

Banco de Dados Vetorial use cases

1

Construindo Busca Semântica para Bases de Conhecimento

Uma equipe de desenvolvimento de software precisa construir uma função de busca inteligente para sua extensa documentação técnica. Em vez de depender da correspondência de palavras-chave, que muitas vezes falha em encontrar artigos relevantes, eles usam um banco de dados vetorial. Cada documento é convertido em um embedding vetorial por um modelo de IA. Quando um desenvolvedor pesquisa por uma consulta como "como corrigir bugs de autenticação", o sistema converte a consulta em um vetor e usa a busca ANN do banco de dados para encontrar os vetores de documentos semanticamente mais similares. Isso fornece resultados altamente relevantes, mesmo que as palavras-chave exatas não estejam presentes, reduzindo significativamente o tempo de solução de problemas.

2

Potencializando Recomendações de Produtos em E-commerce

Um varejista de moda online quer melhorar seu recurso 'Você também pode gostar'. Eles usam um modelo de IA multimodal para gerar embeddings vetoriais para cada imagem de produto e sua descrição. Esses vetores são armazenados em um banco de dados vetorial. Quando um cliente visualiza um produto, o sistema consulta o banco de dados para encontrar produtos com os vetores mais similares. Isso permite recomendações baseadas no estilo visual, padrões de cores e descrições textuais (por exemplo, 'vestido de verão'), criando uma experiência de compra mais envolvente e personalizada que pode aumentar as taxas de conversão.

3

Criando Memória de Longo Prazo para Chatbots de IA

Uma empresa implementa um chatbot de suporte ao cliente com IA. Para garantir que as conversas sejam consistentes e personalizadas, eles usam um banco de dados vetorial como a memória de longo prazo do chatbot. Informações chave de cada interação do usuário (por exemplo, preferências do usuário, problemas passados) são resumidas, convertidas em um vetor e armazenadas. Antes de responder a uma nova consulta, o chatbot pesquisa no banco de dados vetorial por interações passadas relevantes. Este processo, conhecido como Geração Aumentada por Recuperação (RAG), permite que o chatbot se lembre do contexto, evite fazer perguntas repetitivas e forneça um suporte mais útil e ciente do contexto.

4

Implementando Busca Visual para Ativos de Mídia

Uma grande agência de marketing gerencia uma biblioteca de ativos digitais com milhões de imagens e vídeos. Marcar manualmente cada ativo é impraticável. Ao usar um banco de dados vetorial, eles podem implementar um poderoso recurso de busca visual. Um modelo de IA processa cada imagem e gera um vetor que representa seu conteúdo visual. Um designer pode então carregar uma imagem (por exemplo, uma foto de um pôr do sol sobre uma cidade) para encontrar todos os ativos visualmente similares na biblioteca. Eles podem refinar ainda mais a busca com filtros de metadados, como 'orientação horizontal' ou 'contém pessoas', agilizando o fluxo de trabalho criativo e o processo de descoberta de ativos.

5

Detecção de Anomalias em Transações Financeiras

Uma empresa de fintech visa detectar transações fraudulentas em tempo real. Eles modelam cada transação como um vetor de alta dimensão contendo características como valor, hora, localização e tipo de comerciante. Esses vetores são transmitidos para um banco de dados vetorial. O sistema identifica anomalias procurando por vetores que estão distantes de quaisquer clusters estabelecidos de padrões de transações normais. Quando um novo vetor de transação é considerado um outlier, ele é sinalizado para revisão imediata por um analista de fraudes. Esta abordagem baseada em similaridade pode descobrir novos padrões de fraude que sistemas baseados em regras poderiam perder.

6

Acelerando a Descoberta de Fármacos com Busca Molecular

Na pesquisa farmacêutica, os cientistas precisam identificar moléculas com propriedades estruturais ou funcionais semelhantes. Eles representam vastas bibliotecas de compostos químicos como embeddings vetoriais (por exemplo, impressões digitais moleculares). Um pesquisador pode então pegar uma molécula alvo, convertê-la para sua representação vetorial e consultar um banco de dados vetorial para encontrar os k compostos mais similares entre milhões de candidatos. Essa busca por similaridade acelera drasticamente o processo de triagem inicial para novos candidatos a fármacos, ajudando os pesquisadores a concentrar seus esforços nas moléculas mais promissoras e reduzindo o tempo de desenvolvimento.

Banco de Dados Vetorial FAQ

O que é um banco de dados vetorial?

Um banco de dados vetorial é um tipo de banco de dados projetado especificamente para armazenar e consultar vetores de alta dimensão, também conhecidos como embeddings. Em vez de procurar por correspondências exatas como um banco de dados tradicional, ele se destaca em encontrar os itens mais similares com base na distância matemática entre seus vetores. Essa capacidade é fundamental para aplicações de IA como busca semântica, sistemas de recomendação e para habilitar a memória de longo prazo para grandes modelos de linguagem (LLMs) através da Geração Aumentada por Recuperação (RAG).

Como um banco de dados vetorial difere de um banco de dados relacional tradicional (por exemplo, SQL)?

A principal diferença reside no tipo de dados e no método de consulta. Um banco de dados relacional tradicional armazena dados estruturados (como texto, números, datas) em tabelas e usa SQL para encontrar correspondências exatas com base em valores específicos. Em contraste, um banco de dados vetorial armazena dados não estruturados representados como vetores numéricos e usa algoritmos de Vizinho Mais Próximo Aproximado (ANN) para encontrar dados que são semanticamente 'similares' ou 'próximos' a um vetor de consulta. Bancos de dados SQL são para consultas estruturadas e integridade de dados, enquanto bancos de dados vetoriais são para busca de similaridade em dados complexos.

Quais são os recursos essenciais a serem procurados ao escolher um banco de dados vetorial?

Ao selecionar um banco de dados vetorial, considere estes fatores críticos:

  • Desempenho: Avalie a latência da consulta (a rapidez com que retorna os resultados) e a velocidade de indexação (a rapidez com que pode adicionar novos dados).
  • Escalabilidade: Avalie sua capacidade de lidar com o volume de dados esperado (bilhões de vetores) e a carga de consultas sem degradação do desempenho.
  • Modelo de Implantação: Escolha entre um serviço em nuvem totalmente gerenciado para facilidade de uso, uma opção auto-hospedada para controle máximo ou um modelo sem servidor para escalonamento flexível.
  • Filtragem e Busca Híbrida: Verifique se há recursos robustos de filtragem de metadados para combinar a busca por similaridade com consultas estruturadas.
  • Ecossistema e Integrações: Garanta que ele se integre bem com sua pilha de tecnologia existente, incluindo frameworks de IA como LangChain ou LlamaIndex e plataformas de nuvem.
Quem usa bancos de dados vetoriais?

Bancos de dados vetoriais são usados principalmente por engenheiros de IA/ML, cientistas de dados e desenvolvedores de software que estão construindo aplicações com recursos alimentados por IA. Por exemplo, uma equipe que desenvolve um chatbot de IA generativa usaria um banco de dados vetorial para sua memória (RAG). A equipe de ciência de dados de uma empresa de comércio eletrônico usaria um para construir um motor de recomendação. Uma empresa de software o usaria para alimentar um recurso de busca semântica na documentação de ajuda de seu produto. Essencialmente, qualquer pessoa que trabalhe com embeddings de modelos de IA para habilitar funcionalidades baseadas em similaridade é um usuário em potencial.

O que é um 'embedding' no contexto de um banco de dados vetorial?

Um 'embedding' é uma representação numérica de dados complexos, como uma palavra, uma frase, uma imagem ou um clipe de áudio, na forma de um vetor de alta dimensão (uma lista de números). Esses embeddings são gerados por modelos de IA (como grandes modelos de linguagem ou modelos de visão computacional) e são projetados para capturar o significado semântico ou as características dos dados originais. A ideia principal é que itens semelhantes terão embeddings próximos uns dos outros no espaço vetorial. O trabalho principal de um banco de dados vetorial é armazenar esses embeddings e encontrar os mais próximos muito rapidamente.