ToolMage
Entrar

Best 2 Busca Vetorial AI tools for Dados

Popular Busca Vetorial AI tools in Dados include Milvus e Ducky, helping you work more efficiently.

Milvus
Freemium

Milvus

Milvus é um banco de dados vetorial de código aberto e alto desempenho, construído para aplicações de IA. Ele permite que os desenvolvedores gerenciem e pesquisem bilhões de vetores de alta dimensão com latência mínima. Ideal para construir sistemas escaláveis como geração aumentada por recuperação (RAG), motores de recomendação e busca semântica, o Milvus oferece opções de implantação flexíveis, desde prototipagem local até clusters distribuídos em larga escala.

Aprendizado de Máquina
Visits 536.9KFavorites 122Likes 143
Ducky
Freemium

Ducky

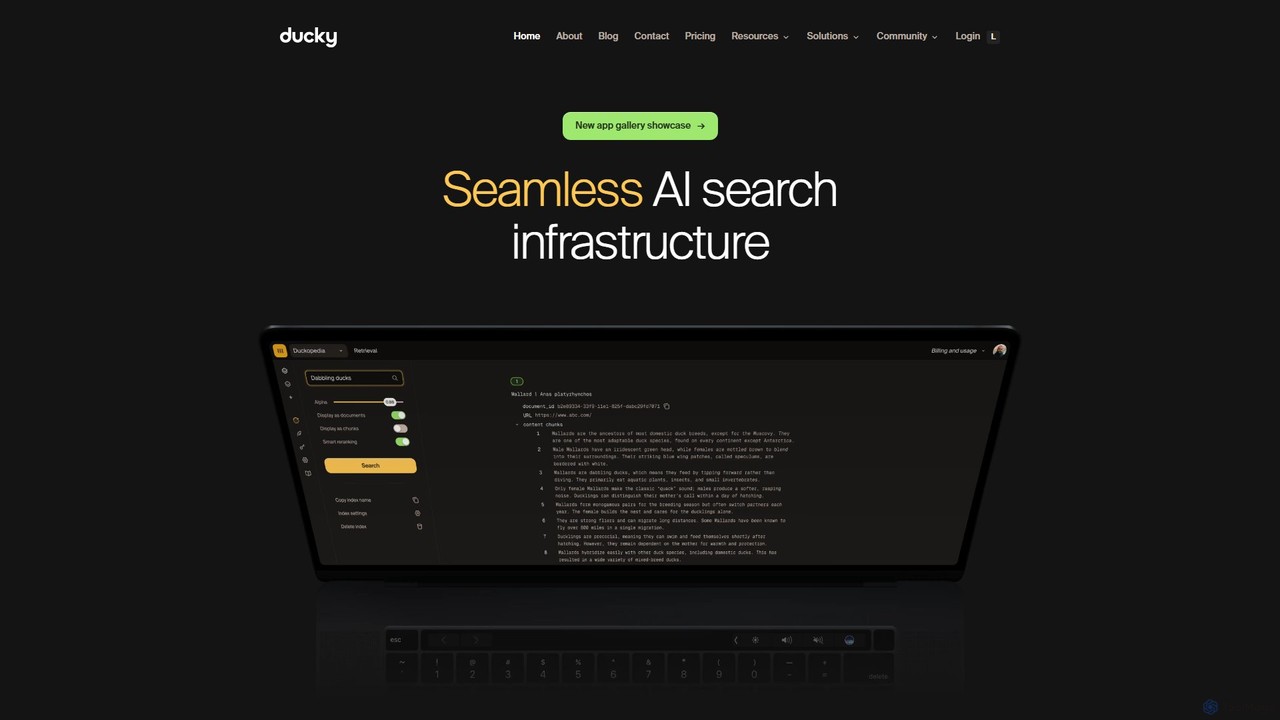
Ducky é uma infraestrutura de busca de IA totalmente gerenciada, projetada para desenvolvedores. Simplifica a implementação da Geração Aumentada por Recuperação (RAG) ao lidar com tarefas complexas como divisão de dados, embedding e reclassificação. Com um SDK Python simples, o Ducky permite que os desenvolvedores construam rapidamente capacidades de busca semântica rápidas, precisas e escaláveis em suas aplicações, fornecendo respostas conscientes do contexto e sem alucinações de LLMs.

Geração Aumentada por Recuperação
Visits 8.8KFavorites 108Likes 113

About Busca Vetorial

As ferramentas de Busca Vetorial são uma classe especializada de sistemas de recuperação de dados que encontram informações com base na similaridade semântica, e não apenas em correspondências exatas de palavras-chave. Elas funcionam convertendo dados como texto, imagens ou áudio em representações numéricas chamadas vetores e, em seguida, procurando os vetores mais próximos em um espaço de alta dimensão. Isso permite que as aplicações entendam o contexto e o significado, impulsionando experiências de busca mais intuitivas, motores de recomendação e bases de conhecimento orientadas por IA. Diferente da busca tradicional, a busca vetorial se destaca no tratamento de consultas complexas e dados não estruturados.

Recursos Principais

  • Busca por Similaridade Semântica: Identifica itens conceitualmente relacionados, mesmo que não compartilhem palavras-chave.
  • Indexação de Alta Dimensão: Emprega algoritmos especializados (como HNSW) para recuperação rápida de bilhões de vetores.
  • Capacidades Multimodais: Suporta a busca em diferentes tipos de dados, como usar uma imagem para encontrar texto relevante.
  • Escalabilidade em Tempo Real: Projetado para lidar com conjuntos de dados massivos e altas cargas de consulta com baixa latência.
  • Busca Híbrida: Combina a similaridade vetorial com a filtragem tradicional de metadados ou palavras-chave para resultados mais precisos.

Casos de Uso

A Busca Vetorial é crucial para desenvolvedores e cientistas de dados que constroem aplicações de IA modernas. Ela forma a espinha dorsal dos sistemas de Geração Aumentada por Recuperação (RAG) para chatbots de IA, motores de recomendação visual em e-commerce e plataformas para detecção de conteúdo duplicado. Também é aplicada em segurança para detecção de anomalias e em pesquisa científica para correspondência de padrões em conjuntos de dados complexos.

Como Escolher

Ao selecionar uma ferramenta de Busca Vetorial, considere sua escalabilidade e desempenho sob a carga esperada. Avalie os algoritmos de indexação suportados e seus trade-offs entre velocidade e precisão. Analise suas capacidades de integração com modelos de embedding e a infraestrutura de dados existente. Além disso, compare as opções de implantação (gerenciada na nuvem, auto-hospedada) e os modelos de preços e a sobrecarga técnica associados.

Busca Vetorial use cases

1

Alimentando Bases de Conhecimento de Chatbots de IA (RAG)

Um desenvolvedor de IA tem a tarefa de construir um chatbot de suporte ao cliente que possa responder a perguntas complexas com base em uma grande biblioteca de documentos técnicos. Em vez de ajustar um grande modelo de linguagem, ele usa um sistema de busca vetorial. Primeiro, todos os documentos são divididos em partes e convertidos em embeddings vetoriais. Quando um usuário faz uma pergunta, a pergunta também é convertida em um vetor. O sistema então realiza uma busca vetorial para encontrar as partes de documento semanticamente mais similares. Essas partes relevantes são fornecidas como contexto para um modelo de linguagem, que então gera uma resposta precisa e baseada em fontes. Essa abordagem, conhecida como Geração Aumentada por Recuperação (RAG), melhora significativamente a precisão das respostas e reduz alucinações.

2

Recomendação Visual de Produtos para E-commerce

Uma plataforma de e-commerce deseja melhorar seu recurso de 'produtos similares'. Métodos tradicionais baseados em tags e categorias muitas vezes não conseguem capturar nuances visuais. Ao implementar um motor de busca vetorial, eles convertem cada imagem de produto em um embedding vetorial. Quando um cliente visualiza um produto, o vetor de sua imagem é usado para consultar o banco de dados em busca dos vizinhos mais próximos. O resultado é uma lista de produtos visualmente similares em estilo, cor e padrão, mesmo que suas descrições de metadados sejam completamente diferentes. Isso leva a uma experiência de usuário mais envolvente, maior descoberta de produtos e taxas de conversão mais altas, pois os clientes podem encontrar facilmente alternativas que correspondem às suas preferências estéticas.

3

Deduplicação e Descoberta de Conteúdo

Uma grande empresa de mídia gerencia milhões de artigos e imagens. Eles enfrentam dois desafios: impedir o upload de conteúdo duplicado e ajudar os usuários a descobrir artigos relacionados. Eles usam um banco de dados de busca vetorial para armazenar os embeddings de todo o seu conteúdo. Quando um novo artigo é enviado, seu conteúdo é convertido em um vetor e verificado no banco de dados. Se um vetor muito próximo já existir, o artigo é sinalizado como uma duplicata em potencial, economizando tempo editorial. Para os leitores, quando terminam um artigo, seu vetor é usado para encontrar outros artigos com conteúdo semântico semelhante, fornecendo sugestões de 'leia a seguir' mais relevantes do que simples links baseados em categorias.

4

Detecção de Anomalias em Cibersegurança

Um analista de cibersegurança precisa monitorar o tráfego de rede em busca de atividades incomuns que possam indicar uma ameaça. Ele usa um sistema de busca vetorial para modelar o comportamento normal da rede. Cada evento de rede (como uma tentativa de login ou transferência de dados) é convertido em um vetor com base em seus atributos. Com o tempo, esses vetores formam clusters que representam operações normais. O sistema converte continuamente novos eventos em vetores и busca por seus vizinhos mais próximos. Se o vetor de um novo evento estiver longe de qualquer cluster existente (ou seja, não tiver vizinhos próximos), ele é sinalizado como uma anomalia para investigação imediata. Isso permite a detecção de ameaças novas e de dia zero que sistemas baseados em assinaturas não detectariam.

5

Mecanismos de Busca Reversa de Imagens

Um jornalista precisa verificar a autenticidade de uma foto que circula nas redes sociais. Ele usa uma ferramenta de busca reversa de imagens alimentada por busca vetorial. O jornalista carrega a imagem, que é instantaneamente convertida em um embedding vetorial pela ferramenta. Este vetor é então usado para pesquisar em um banco de dados massivo e pré-indexado de imagens de toda a web. A busca retorna imagens visualmente similares em milissegundos, permitindo que o jornalista identifique a fonte original, o contexto e a data da foto. Este processo ajuda a combater a desinformação, desmascarando rapidamente imagens falsas ou fora de contexto, uma tarefa que seria impossível com a busca baseada em palavras-chave.

6

Acelerando a Descoberta de Fármacos e a Genômica

Um bioinformata está procurando compostos químicos com propriedades semelhantes a uma molécula recém-descoberta. Representar moléculas como embeddings vetoriais com base em suas propriedades estruturais e químicas permite buscas de similaridade em escala massiva. O pesquisador insere o vetor da nova molécula em um banco de dados de busca vetorial contendo milhões de compostos conhecidos. O sistema retorna uma lista classificada das moléculas mais similares, reduzindo drasticamente os candidatos para testes de laboratório. Este mesmo princípio se aplica à genômica, onde a busca vetorial pode identificar sequências de genes com padrões funcionais semelhantes, acelerando a pesquisa sobre doenças e tratamentos.

Busca Vetorial FAQ

O que é Busca Vetorial?

A Busca Vetorial é um método para recuperar informações com base no significado semântico e no contexto, em vez de correspondências exatas de palavras-chave. Ela funciona convertendo dados não estruturados — como texto, imagens ou áudio — em representações numéricas chamadas 'embeddings vetoriais'. Esses vetores são então armazenados em um banco de dados especializado. Quando uma consulta é feita, ela também é convertida em um vetor, e o sistema encontra os vetores no banco de dados que estão mais próximos do vetor da consulta em um espaço de alta dimensão. Isso permite encontrar itens conceitualmente semelhantes, mesmo que usem palavras ou visuais diferentes.

Como a Busca Vetorial difere da busca por palavra-chave tradicional?

A principal diferença reside em como eles interpretam as consultas e os dados. A busca por palavra-chave tradicional baseia-se em correspondências exatas ou parciais de strings de texto. Ela encontra documentos que contêm as palavras específicas que você digitou. A Busca Vetorial, por outro lado, entende o significado semântico ou o conceito por trás da consulta. Ela encontra dados que são contextual e conceitualmente semelhantes, mesmo que não contenham as palavras-chave exatas. Por exemplo, uma busca por palavra-chave por 'carro' não encontrará um documento sobre um 'automóvel', mas uma busca vetorial encontrará, porque entende que são conceitos semanticamente relacionados.

Como escolher uma ferramenta ou banco de dados de Busca Vetorial?

A escolha da ferramenta de busca vetorial certa depende de suas necessidades específicas. Considere os seguintes fatores:

  • Escalabilidade: Quantos vetores você precisa armazenar e quantas consultas por segundo você espera? Escolha uma solução que possa escalar com o seu crescimento.
  • Desempenho: Avalie a latência (velocidade da consulta) e o recall (precisão) do sistema. Alguns sistemas oferecem parâmetros ajustáveis para equilibrar velocidade e precisão.
  • Modelo de Implantação: Você prefere um serviço em nuvem totalmente gerenciado (mais fácil de configurar) ou uma solução auto-hospedada (mais controle e potencialmente menor custo)?
  • Integrações: Verifique a compatibilidade com seus pipelines de dados existentes, linguagens de programação e os modelos de embedding que planeja usar.
  • Recursos: Procure por recursos avançados como filtragem de metadados (busca híbrida), indexação em tempo real e capacidades de gerenciamento de dados.
O que é um 'embedding' no contexto da Busca Vetorial?

Um 'embedding' (ou incorporação) é o vetor numérico que representa um dado na busca vetorial. É uma lista de números (frequentemente centenas ou milhares) que captura a essência semântica do dado original (como uma palavra, frase, imagem ou clipe de áudio). Esses embeddings são criados por modelos de aprendizado profundo (como BERT para texto ou CLIP para imagens) que foram treinados em vastas quantidades de dados. A propriedade chave dos embeddings é que itens semanticamente semelhantes terão vetores próximos uns dos outros no espaço vetorial de alta dimensão, o que torna a busca vetorial possível.

Quem deve usar as ferramentas de Busca Vetorial?

As ferramentas de Busca Vetorial são principalmente para desenvolvedores, cientistas de dados e engenheiros de aprendizado de máquina que estão construindo aplicações que exigem a compreensão de dados não estruturados. Os principais usuários incluem:

  • Desenvolvedores de Aplicações de IA: Aqueles que constroem chatbots, sistemas de perguntas e respostas ou outras aplicações usando Geração Aumentada por Recuperação (RAG).
  • Plataformas de E-commerce: Equipes que procuram implementar busca visual avançada ou recomendações semânticas de produtos.
  • Plataformas de Conteúdo: Empresas que precisam gerenciar grandes bibliotecas de mídia, recomendar conteúdo relacionado ou detectar duplicatas.
  • Empresas de Cibersegurança: Analistas e engenheiros que desenvolvem sistemas para detecção de anomalias ou inteligência de ameaças.
  • Instituições de Pesquisa: Cientistas em campos como bioinformática ou ciência dos materiais que precisam encontrar padrões em dados complexos e de alta dimensão.