
ToolMage
Entrar

Best 1 Inferência em Lote AI tools for Modelos de Linguagem Grandes

Popular Inferência em Lote AI tools in Modelos de Linguagem Grandes include Bsub, helping you work more efficiently.

Bsub
Paid

Bsub

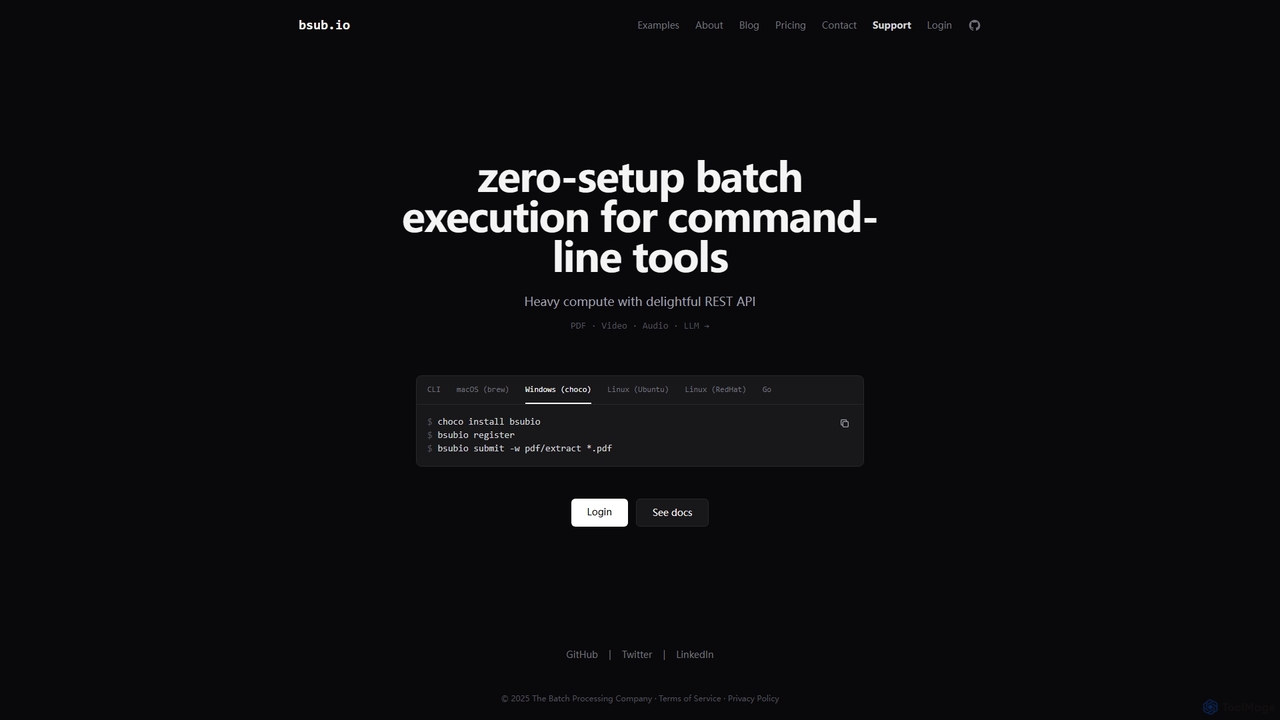
Bsub é uma plataforma de execução em lote sem configuração, projetada para desenvolvedores executarem ferramentas de linha de comando em escala. Ela simplifica tarefas computacionais pesadas como extração de PDF, transcodificação de vídeo, transcrição de áudio e inferência em lote de modelos de linguagem grandes (LLM) através de uma API REST simples, eliminando a gestão de infraestrutura e preocupações com escalabilidade.

Transcrição
Visits 8.6KFavorites 124Likes 138

About Inferência em Lote

A Inferência em Lote é um método para aplicar modelos de linguagem grandes (LLMs) pré-treinados a um grande volume de dados de entrada simultaneamente, em vez de processar solicitações individuais em tempo real. Essa abordagem otimiza os recursos computacionais agrupando múltiplas entradas em um único lote, melhorando significativamente o rendimento e a eficiência de custos para tarefas não interativas. É ideal para cenários onde respostas imediatas não são críticas, mas o processamento eficiente de vastos conjuntos de dados é primordial.

Principais Recursos

  • Processamento de Alto Rendimento: Processa eficientemente grandes conjuntos de dados agrupando múltiplas entradas, maximizando a utilização da GPU.
  • Otimização de Custos: Reduz o custo por token da inferência de LLM minimizando a sobrecarga e aproveitando as economias de escala.
  • Escalabilidade: Projetado para lidar com volumes de dados variáveis, de milhares a milhões de entradas, adaptando-se à demanda.
  • Operação Assíncrona: Executa tarefas em segundo plano, permitindo que os usuários enviem trabalhos e recuperem resultados posteriormente sem interação em tempo real.
  • Tratamento Robusto de Erros: Inclui mecanismos para gerenciar falhas dentro de um lote, garantindo a integridade dos dados e um processamento confiável.

Cenários Aplicáveis

As ferramentas de inferência em lote são cruciais para cientistas de dados, analistas e desenvolvedores que trabalham com grandes conjuntos de dados textuais. Elas são amplamente utilizadas em pipelines de processamento de dados, fluxos de trabalho de geração de conteúdo e projetos de enriquecimento de dados em larga escala, onde a eficiência e o custo são considerações chave. Este método permite uma análise e transformação abrangente dos dados sem as restrições da latência em tempo real.

Como Escolher

Ao selecionar uma solução de inferência em lote, considere suas capacidades de integração com sua infraestrutura de dados existente, como armazenamento em nuvem ou data warehouses. Avalie o modelo de precificação, que pode variar por token, tamanho do lote ou tempo de computação, para alinhar com seu orçamento. Avalie sua escalabilidade para garantir que possa crescer com seu volume de dados e verifique os recursos robustos de monitoramento e tratamento de erros essenciais para operações em larga escala.

Inferência em Lote use cases

1

Automatização da Geração de Descrições de Produtos

Empresas de e-commerce com extensos catálogos de produtos podem usar a inferência em lote para gerar automaticamente descrições únicas e otimizadas para SEO para milhares de produtos. Ao alimentar especificações e palavras-chave de produtos em um LLM, as empresas podem criar rapidamente conteúdo envolvente, economizando inúmeras horas em comparação com a escrita manual e garantindo a consistência em suas listagens.

2

Análise de Sentimento em Larga Escala de Feedback de Clientes

Equipes de experiência do cliente ou pesquisadores de mercado podem processar anos de avaliações de clientes, comentários em mídias sociais e tickets de suporte em lotes. Os LLMs podem extrair o sentimento, identificar temas comuns e categorizar o feedback em escala, fornecendo insights profundos sobre a satisfação do cliente e o desempenho do produto sem as restrições de tempo real.

3

Tradução de Arquivos de Documentos Extensos

Organizações globais ou escritórios de advocacia frequentemente precisam traduzir vastos arquivos de documentos, relatórios ou contratos. As ferramentas de inferência em lote permitem a tradução eficiente desses grandes corpora de texto para vários idiomas, garantindo conformidade e acessibilidade em diferentes regiões sem a necessidade de tradução imediata e interativa.

4

Enriquecimento de Dados e Extração de Entidades de Texto Não Estruturado

Analistas de dados e pesquisadores podem enriquecer grandes conjuntos de dados extraindo entidades específicas (por exemplo, nomes, organizações, locais) ou categorizando texto não estruturado de artigos de notícias, trabalhos de pesquisa ou documentos legais. O processamento em lote permite a transformação sistemática de texto bruto em dados estruturados e acionáveis para análise posterior.

5

Moderação de Conteúdo Offline para Conteúdo Gerado pelo Usuário

Plataformas com grandes volumes de conteúdo gerado pelo usuário podem utilizar a inferência em lote para moderação de conteúdo proativa e offline. Os LLMs podem analisar grandes lotes de texto, imagens ou vídeos para identificar e sinalizar conteúdo inadequado ou prejudicial antes que ele ganhe visibilidade generalizada, complementando os esforços de moderação em tempo real.

6

Resumo de Artigos de Notícias Históricos ou Trabalhos de Pesquisa

Pesquisadores, jornalistas ou analistas de inteligência podem usar a inferência em lote para gerar resumos concisos de vastas coleções de artigos de notícias históricos, trabalhos científicos ou relatórios internos. Isso permite uma rápida assimilação de informações, identificação de tendências e extração de conhecimento de extensos arquivos textuais.

Inferência em Lote FAQ

O que é Inferência em Lote no contexto de LLMs?

Inferência em Lote é uma técnica onde um modelo de linguagem grande processa múltiplas solicitações de entrada simultaneamente como um único lote, em vez de uma por uma. Este método é principalmente usado para tarefas não interativas onde alto rendimento e eficiência de custos são priorizados em relação à baixa latência, tornando-o ideal para processamento de dados em larga escala e geração de conteúdo.

Como a Inferência em Lote difere da Inferência em Tempo Real?

A Inferência em Lote processa uma coleção de entradas juntas, otimizando o rendimento e o custo, com resultados entregues após a conclusão de todo o lote. A inferência em tempo real, por outro lado, processa solicitações individuais imediatamente, priorizando baixa latência para aplicações interativas como chatbots ou tradução ao vivo. A inferência em lote é assíncrona, enquanto a em tempo real é síncrona.

Quais são os principais benefícios de usar a Inferência em Lote para tarefas de LLM?

Os principais benefícios incluem uma redução significativa de custos devido à otimização do uso de recursos (por exemplo, ciclos de GPU), maior rendimento permitindo o processamento mais rápido de grandes conjuntos de dados e eficiência aprimorada ao minimizar a sobrecarga por solicitação. É particularmente vantajoso para tarefas que não exigem respostas imediatas, como análise de dados ou geração de conteúdo para grandes catálogos.

Que tipos de tarefas são mais adequados para Inferência em Lote com LLMs?

A inferência em lote é mais adequada para tarefas que envolvem grandes volumes de dados onde a interação imediata não é necessária. Exemplos incluem a geração de descrições de produtos para um site de e-commerce inteiro, a realização de análise de sentimento em avaliações históricas de clientes, a tradução de vastos arquivos de documentos ou a extração de entidades de grandes corpora de texto para enriquecimento de dados.

Quais fatores devo considerar ao implementar a Inferência em Lote para LLMs?

Fatores chave incluem o tamanho e a frequência dos seus lotes de dados, os recursos computacionais disponíveis (por exemplo, capacidade de GPU), a complexidade da integração com seus pipelines de dados existentes e o nível desejado de tolerância a falhas e monitoramento. Otimizar o tamanho do lote é crucial para equilibrar o rendimento e o uso da memória, enquanto o tratamento robusto de erros garante o processamento confiável de grandes trabalhos.