ToolMage
Entrar

AI TOOL COMPARISON

Apify vs UseScraper

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

Apify Visão geral

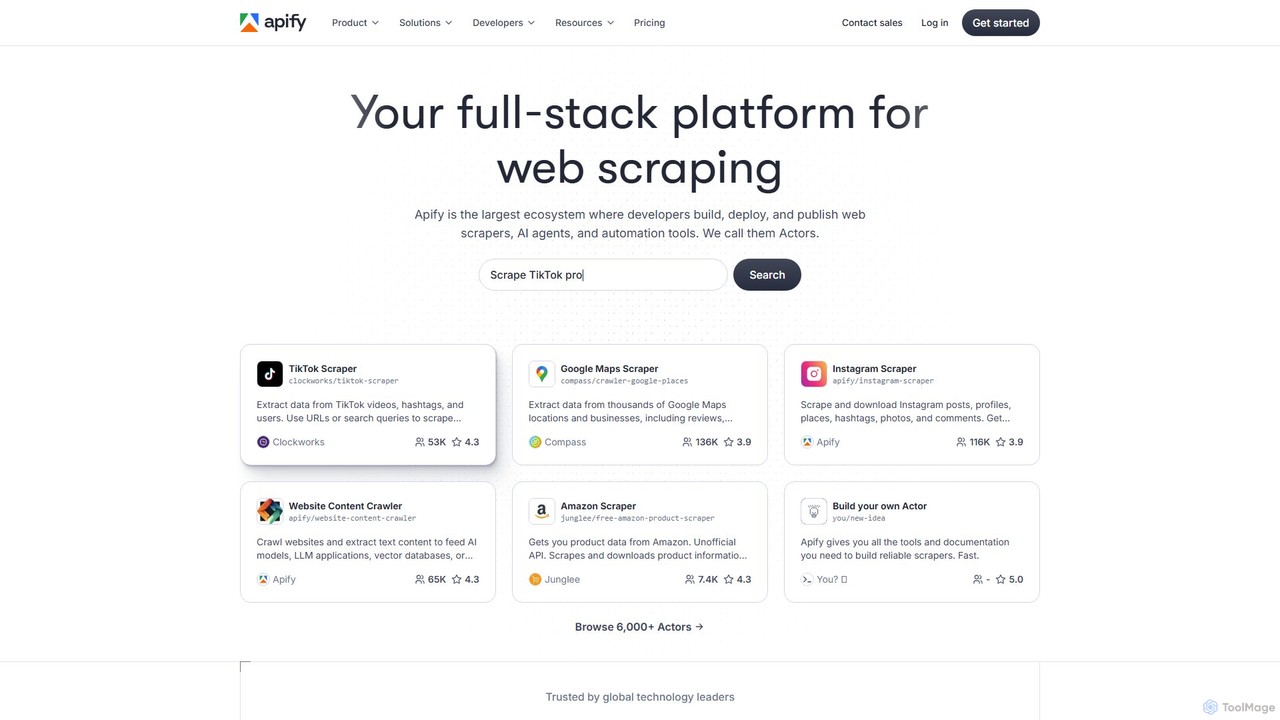
Apify é uma plataforma full-stack de web scraping e automação que permite aos desenvolvedores construir, implantar e publicar ferramentas de extração de dados, conhecidas como 'Actors'. Oferece um vasto mercado de scrapers pré-construídos para sites populares como Google Maps, Instagram e TikTok, juntamente com uma infraestrutura de nuvem robusta para criar soluções personalizadas. Com suporte para Python e JavaScript, bibliotecas de código aberto e integrações perfeitas, a Apify simplifica a coleta de dados da web em qualquer escala.

Preview

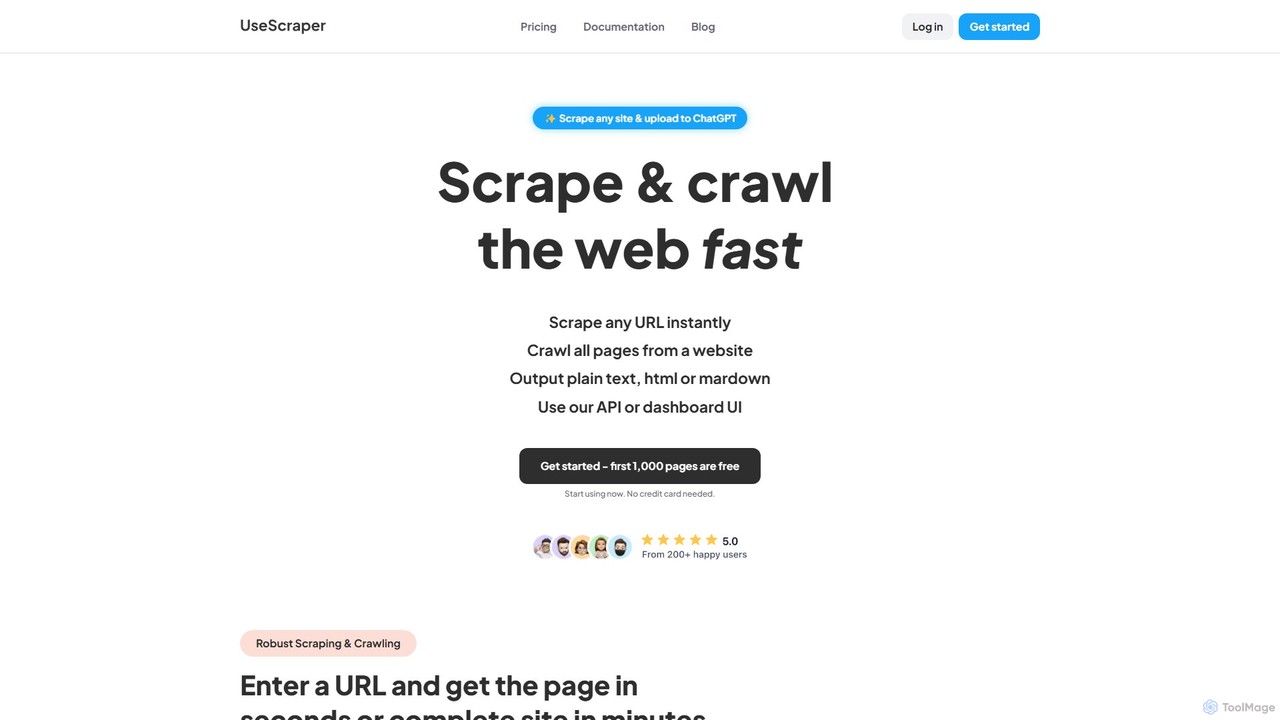
UseScraper Visão geral

UseScraper é uma poderosa API de crawler e scraper da web projetada para desenvolvedores e aplicações de IA. Extrai dados de qualquer site de forma eficiente, com renderização completa de JavaScript, infraestrutura de autoescalonamento e formatos de saída limpos como Markdown, ideal para alimentar dados em LLMs como o ChatGPT.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Apify VS UseScraper — Dados principais
Dados principaisApifyUseScraper
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusColeta de DadosExtração de Dados
Público e funçõesNão verificadoNão verificado
CategoriasColeta de Dados · Extração de Dados · Web Scraping · AutomaçãoExtração de Dados · API · Automação
Added16 de ago. de 20255 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Apify

A Apify é uma plataforma de nuvem abrangente projetada para web scraping, extração de dados e automação de processos. Ela fornece um ecossistema completo onde desenvolvedores e empresas podem construir, implantar, gerenciar e publicar web scrapers e ferramentas de automação, que são chamados de 'Actors'. A Apify atende a uma ampla gama de usuários, desde desenvolvedores individuais que precisam extrair dados para um pequeno projeto até grandes empresas que exigem pipelines de dados confiáveis e escaláveis para inteligência de negócios e aplicações de IA.

O núcleo da plataforma é a Apify Store, um mercado com mais de 6.000 Actors pré-construídos para extrair dados de sites populares como Google, Instagram, TikTok e Amazon. Isso permite que os usuários obtenham dados estruturados instantaneamente, sem escrever nenhum código. Para necessidades mais específicas, a Apify fornece um ambiente de desenvolvimento poderoso com todas as ferramentas necessárias para construir Actors personalizados do zero, usando linguagens de programação e bibliotecas populares.

Como usar Apify

Usar a Apify envolve um fluxo de trabalho direto que pode ser adaptado ao seu nível de habilidade técnica:

  1. Escolha seu método: Você pode selecionar um 'Actor' pronto na Apify Store para uma tarefa específica (por exemplo, 'Google Maps Scraper') ou decidir construir seu próprio scraper personalizado.
  2. Configure o Actor: Se estiver usando um Actor pré-construído, você simplesmente fornece as entradas necessárias, como URLs, palavras-chave de pesquisa ou dados de localização, por meio de uma interface amigável.
  3. Construa um Actor Personalizado (Opcional): Para necessidades personalizadas, os desenvolvedores podem usar o SDK da Apify com Python ou JavaScript (Node.js). A plataforma suporta bibliotecas populares como Crawlee, Playwright, Puppeteer e Scrapy. Você pode escrever seu código localmente e implantá-lo na nuvem da Apify.
  4. Execute e Monitore: Execute seu Actor na infraestrutura de nuvem da Apify. A plataforma lida com proxies, escalonamento e recursos de computação automaticamente. Você pode monitorar o progresso de seus trabalhos de scraping em tempo real através do painel.
  5. Acesse e Exporte Dados: Uma vez que a execução esteja completa, os dados extraídos são armazenados e podem ser visualizados em vários formatos como JSON, CSV ou Excel. Você pode baixar os dados diretamente ou acessá-los via API da Apify.
  6. Integre e Automatize: Agende seus Actors para serem executados em intervalos regulares para monitoramento contínuo de dados. Integre o fluxo de dados com outras aplicações e serviços como Zapier, Google Sheets, Pinecone, LangChain ou seu próprio banco de dados.

Recursos principais do Apify

  • Apify Store: Um vasto mercado com mais de 6.000 web scrapers e ferramentas de automação (Actors) pré-construídos para uso imediato.
  • Plataforma de Desenvolvedor: Um ambiente full-stack para construir, testar e implantar scrapers personalizados com uma infraestrutura de nuvem robusta, suportando Python e JavaScript.
  • Bibliotecas de Código Aberto: Integração profunda com bibliotecas de código aberto poderosas como Crawlee (da própria Apify), Playwright, Puppeteer, Selenium e Scrapy.
  • Proxies Integrados: Acesso a um grande pool de proxies de datacenter e residenciais para gerenciar a rotação de IP, contornar bloqueios e garantir a extração de dados bem-sucedida.
  • Infraestrutura de Nuvem Escalável: Escala recursos automaticamente com base na demanda. Os usuários não precisam gerenciar servidores, armazenamento ou computação.
  • Agendamento e Monitoramento: Ferramentas integradas para agendar trabalhos de scraping para execução periódica e monitorar seu status, desempenho e consumo de recursos.
  • Integração de Dados e API: Uma API poderosa para executar Actors e acessar dados programaticamente, além de integrações perfeitas com ferramentas como Zapier, Airbyte, LangChain e LlamaIndex.
  • Soluções de Dados para IA: Actors especializados como o 'Website Content Crawler' são projetados para extrair e limpar conteúdo de texto para alimentar modelos de IA, bancos de dados vetoriais e pipelines RAG.

Casos de uso para Apify

A Apify é versátil e pode ser usada para uma ampla gama de tarefas orientadas a dados:

  • Geração de Leads: Extração de informações de contato e detalhes de negócios do Google Maps, LinkedIn ou diretórios do setor.
  • Análise de Mercado e Concorrência: Extração de preços de produtos, avaliações e descrições de sites de e-commerce como a Amazon para monitorar tendências de mercado.
  • Inteligência de Mídias Sociais: Coleta de dados de plataformas como TikTok, Instagram e Twitter para análise de sentimento, rastreamento de influenciadores e monitoramento de campanhas.
  • IA e Machine Learning: Rastreamento de sites para coletar grandes conjuntos de dados de texto e imagens para treinar modelos de IA e alimentar sistemas RAG (Retrieval-Augmented Generation).
  • Monitoramento de Marca: Rastreamento de menções a uma marca, produto ou serviço em sites de notícias, blogs e fóruns.
  • Agregação de Dados Financeiros e Imobiliários: Coleta de dados do mercado de ações, listagens de imóveis e informações de preços de várias fontes.

Vantagens do Apify

A Apify se destaca com várias vantagens principais:

  • Solução Tudo-em-Um: Combina um mercado de ferramentas prontas para uso com uma poderosa plataforma de desenvolvimento e infraestrutura de nuvem gerenciada.
  • Eficiência e Velocidade: Actors pré-construídos economizam centenas de horas de desenvolvimento, permitindo que os usuários obtenham dados em minutos.
  • Centrado no Desenvolvedor: Suporta as linguagens e ferramentas que os desenvolvedores já conhecem e amam, com suporte de documentação extensa, modelos de código e uma comunidade forte.
  • Confiabilidade e Escalabilidade: Construído para desempenho em escala, oferecendo confiabilidade de nível empresarial com 99,95% de tempo de atividade e conformidade com SOC2.
  • Oportunidade de Monetização para Desenvolvedores: Os desenvolvedores podem publicar seus Actors na Apify Store e obter uma renda recorrente, enquanto a Apify cuida do faturamento, infraestrutura и marketing.

Preços e planos

A Apify opera em um modelo de preços freemium, baseado no uso, tornando-a acessível para projetos de todos os tamanhos.

  • Plano Gratuito: Inclui uma quantidade generosa de créditos de plataforma mensais gratuitos (US$ 5/mês), o que é suficiente para pequenos projetos, testes e aprendizado. Novos criadores também recebem um bônus de crédito significativo para começar.
  • Plano Pessoal (US$ 49/mês): Projetado para indivíduos e freelancers, oferecendo um pool maior de créditos de plataforma e acesso a mais recursos.
  • Plano de Equipe (US$ 499/mês): Destinado a pequenas e médias empresas, este plano inclui ainda mais créditos, recursos de colaboração, maior retenção de dados e suporte prioritário.
  • Plano Empresarial (Preço Personalizado): Adaptado para grandes organizações com necessidades específicas, oferecendo valores de crédito personalizados, recursos de segurança premium (SOC2), suporte dedicado e acordos de nível de serviço (SLAs) personalizados.

Todos os planos operam com base no pagamento conforme o uso para utilização além dos créditos incluídos, cobrindo unidades de computação, uso de proxy e armazenamento de dados.

UseScraper

UseScraper é um serviço robusto e escalável de web scraping e crawling fornecido através de uma API simples, mas poderosa. Foi projetado desde o início para velocidade e confiabilidade, permitindo que os usuários extraiam dados de qualquer página da web em segundos ou rastreiem sites inteiros em minutos. Esta ferramenta é particularmente valiosa para desenvolvedores, cientistas de dados e empresas que precisam coletar dados da web para pesquisa de mercado, geração de leads, monitoramento de preços ou para treinar modelos de IA.

A plataforma foi projetada para lidar com as complexidades da web moderna. Utiliza um navegador Chrome real para renderização completa de JavaScript, garantindo que o conteúdo em aplicações dinâmicas de página única (SPAs) seja capturado com precisão. Essa capacidade o torna superior a muitos scrapers tradicionais que apenas buscam HTML estático. A saída pode ser entregue em vários formatos, incluindo HTML bruto, texto simples e, mais notavelmente, Markdown limpo e bem estruturado, que é o formato ideal para processamento por sistemas de IA e Modelos de Linguagem Grandes (LLMs).

Como usar UseScraper

Usar o UseScraper é simples para desenvolvedores de todos os níveis de habilidade. O processo envolve alguns passos simples:

  1. Inscreva-se: Crie uma conta gratuita para começar. Nenhum cartão de crédito é necessário, e você recebe 1.000 raspagens de página gratuitas e $25 em créditos ao se inscrever.
  2. Escolha sua Ferramenta: Decida se você precisa raspar uma única URL ou rastrear um site inteiro. O UseScraper oferece APIs dedicadas para ambas as tarefas (API de Scraper e API de Crawler).
  3. Faça uma Requisição à API: Use sua linguagem de programação preferida (Python, JavaScript, C#, etc.) para fazer uma requisição ao endpoint da API do UseScraper. Você só precisa fornecer a(s) URL(s) de destino.
  4. Configure Opções: Você pode personalizar sua requisição com opções avançadas, como excluir URLs ou elementos CSS específicos, configurar webhooks para notificações e escolher o formato de saída desejado (markdown, text ou html).
  5. Receba os Dados: O conteúdo raspado é retornado na resposta da API. Para trabalhos de rastreamento maiores, os resultados são armazenados em um data store dedicado, que pode ser acessado via API. Você também pode definir a expiração automática dos dados para gerenciar o armazenamento.

Recursos principais do UseScraper

  • APIs de Scraper e Crawler: APIs dedicadas para raspar páginas únicas instantaneamente ou rastrear milhares de páginas de um site.
  • Renderização Completa de JavaScript: Usa um navegador Chrome real para renderizar JavaScript, garantindo a extração precisa de dados de sites dinâmicos e SPAs.
  • Saída de Markdown Pronta para IA: Fornece saída de Markdown limpa e estruturada, perfeita para uso em aplicações de IA, sistemas RAG e para alimentar conhecimento em LLMs como o ChatGPT. Texto simples e HTML também estão disponíveis.
  • Infraestrutura de Alta Velocidade e Escalável: Construído em uma infraestrutura de autoescalonamento que permite scraping e crawling paralelos super-rápidos de milhares de páginas por minuto.
  • Controle Avançado de Rastreamento: Os recursos incluem rastreamento de múltiplos sites em um único trabalho, exclusão de URLs específicas com padrões glob e remoção de conteúdo repetitivo (como cabeçalhos/rodapés) usando seletores CSS.
  • Rotação Automática de Proxy: (Em breve) Rotação automática de proxies para contornar medidas anti-scraping e evitar limitação de taxa, garantindo altas taxas de sucesso.
  • Notificações por Webhook: Receba atualizações em tempo real sobre o status e a conclusão de seus trabalhos de rastreamento através de webhooks.
  • Data Store Integrado: Os dados raspados são salvos em um data store acessível via API, com opções para definir a expiração automática dos dados.

Casos de uso para UseScraper

O UseScraper é versátil e pode ser aplicado a uma ampla gama de tarefas de extração de dados:

  • Treinamento de Modelos de IA: Raspe grandes quantidades de conteúdo da web para criar conjuntos de dados para treinar modelos de aprendizado de máquina ou para construir uma base de conhecimento para Geração Aumentada por Recuperação (RAG) com LLMs.
  • Análise de Mercado e Concorrência: Agregue informações de produtos, preços, avaliações e notícias de sites concorrentes para informar a estratégia de negócios.
  • Geração de Leads: Extraia detalhes de contato e informações comerciais de diretórios online e redes profissionais.
  • Agregação de Conteúdo: Alimente portais de notícias, quadros de empregos ou sites de listagem de imóveis, coletando dados automaticamente de várias fontes.
  • SEO e Marketing: Monitore classificações de mecanismos de busca, rastreie menções à marca e analise perfis de backlinks rastreando SERPs e sites.

Vantagens do UseScraper

O UseScraper se destaca por seu foco em desempenho, compatibilidade com a web moderna e experiência do desenvolvedor. Suas principais vantagens incluem a capacidade de lidar com sites pesados em JavaScript sem esforço, o fornecimento de saída de Markdown limpa e adaptada para IA, e sua arquitetura escalável e de alta velocidade. O modelo de preços flexível, incluindo um generoso nível gratuito, o torna acessível para projetos de todos os tamanhos, desde pequenos scripts até operações de dados empresariais em larga escala.

Preços e planos

O UseScraper oferece uma estrutura de preços transparente e escalável:

  • Plano Pay as you go: $0/mês. Você paga apenas pelo que usa a uma taxa de $1 por 1.000 páginas da web. Este plano inclui 10 trabalhos concorrentes, APIs de Scraper e Crawler, renderização de JavaScript e é perfeito para projetos menores. As primeiras 1.000 páginas são gratuitas.
  • Plano Pro: $99/mês, mais custos de uso de $1 por 1.000 páginas da web. Este plano é projetado para operações em larga escala e inclui tudo no plano gratuito, mais trabalhos concorrentes ilimitados, rastreamento de páginas ilimitadas por site, proxies avançados (em breve) e suporte prioritário.

Novos usuários recebem $25 em créditos gratuitos ao se inscrever, fornecendo um ponto de partida substancial para testes e desenvolvimento.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
Extração de DadosAutomação
Só Apify
Coleta de DadosWeb Scraping
Só UseScraper
API

Etiquetas

Em comum
Dados de IAAPIautomaçãoExtração de dadosFerramentas de desenvolvedorGeração Aumentada por Recuperaçãorastreador da webWeb scraping
Só Apify
mineração de dadosJavaScriptGeração de leadsPython
Só UseScraper
ChatGPTColeta de dadosRenderização JavaScriptMarkdown

Público e funções

Em comum
Sem dados verificados
Só Apify
Sem dados verificados
Só UseScraper
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Apify monthly traffic:

Latest traffic · 2026-05

Visitas mensais
4.4M
Duração média
4:48
Páginas por visita
7.65
Taxa de rejeição
36.29%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 1.9M
  • 2026-01: 2.5M
  • 2026-02: 2.5M
  • 2026-03: 3.8M
  • 2026-04: 4.1M
  • 2026-05: 4.4M

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States40.31%1.8M
🇮🇳India31.99%1.4M
🇧🇷Brazil10.35%457.4K
🇬🇧United Kingdom8.77%387.5K
🇩🇪Germany8.58%379.1K

Fontes de tráfego

Source typePercentageEstimated visits
Direto84.73%3.7M
Referência11.9%525.9K
E-mail3.37%148.9K

Palavras-chave

apifyepornerfacebookthisvidxvideos

UseScraper

Não verificado

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Apify

Avaliação
Não verificado
Comentários
0
Favoritos
156
Curtidas
173

UseScraper

Avaliação
Não verificado
Comentários
0
Favoritos
188
Curtidas
166

Apify vs UseScraper · FAQ da comparação

What do Apify and UseScraper have in common?
Both tools are listed under Extração de Dados、Automação. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Apify and UseScraper free?
Listed pricing models: Apify — Freemium; UseScraper — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Apify and UseScraper?
The primary listed category is Coleta de Dados for Apify, and Extração de Dados for UseScraper. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas