ToolMage
Entrar

AI TOOL COMPARISON

Ask On Data vs Flyte

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

Ask On Data Visão geral

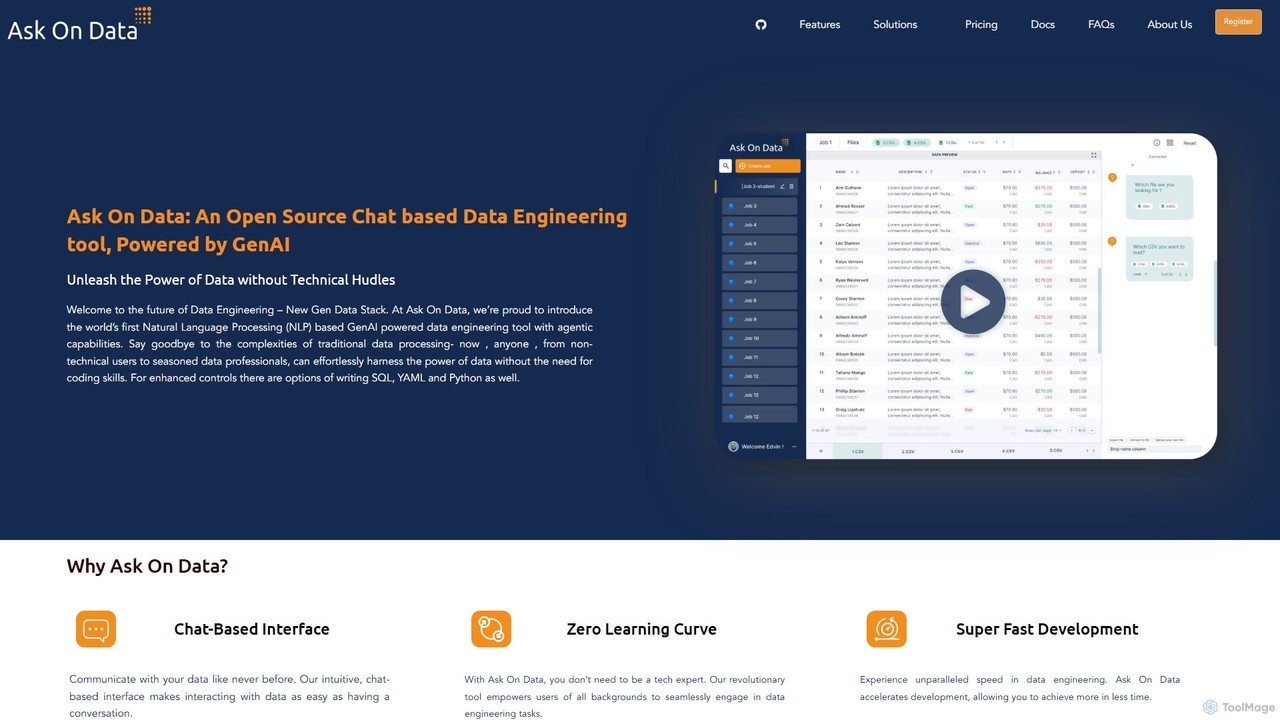
Ask On Data é uma ferramenta de engenharia de dados de código aberto, alimentada por GenAI, que permite construir e gerenciar pipelines de dados usando uma interface de chat simples. Ao traduzir comandos em linguagem natural para operações de dados complexas, elimina a necessidade de codificação, tornando a engenharia de dados acessível a todos. Suporta várias fontes de dados, oferece pré-visualizações em tempo real e fornece opções hospedadas na nuvem e auto-hospedadas.

Preview

Flyte Visão geral

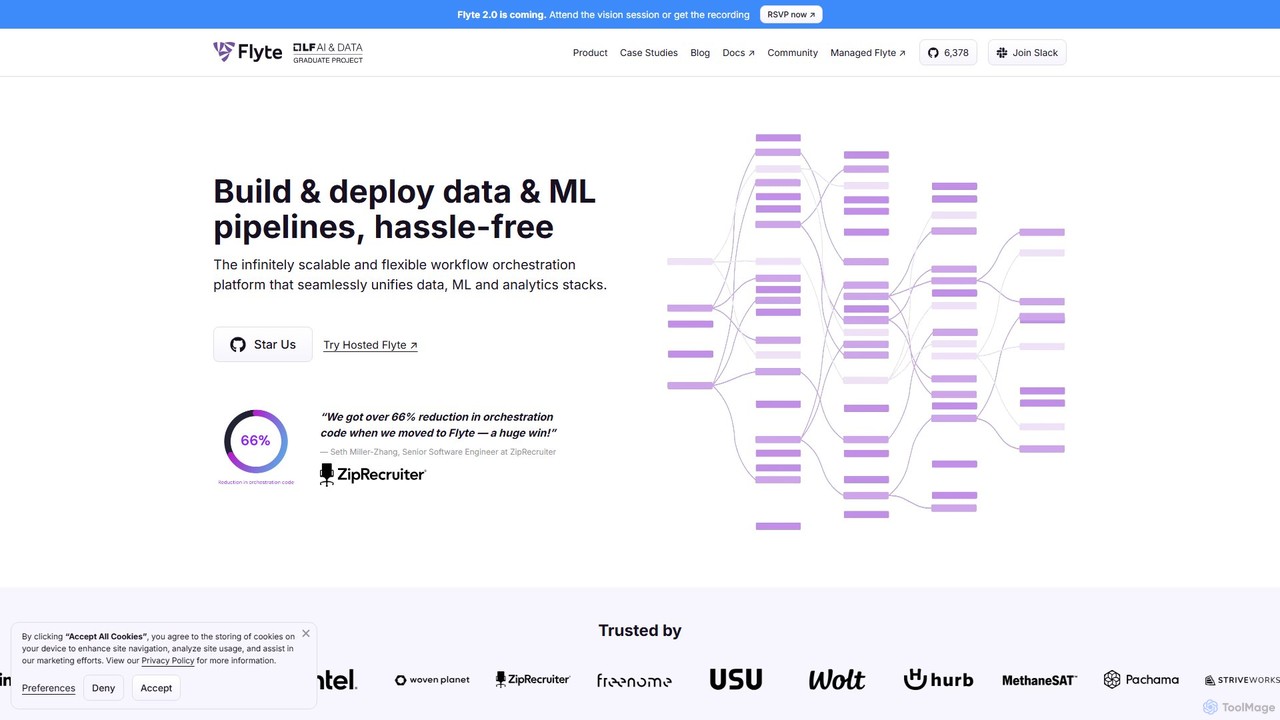
Flyte é uma plataforma de orquestração de fluxos de trabalho de código aberto e nativa da nuvem, projetada para construir, implantar e gerenciar pipelines de dados, aprendizado de máquina e análise de nível de produção. Enfatiza a escalabilidade, reprodutibilidade e facilidade de uso, permitindo que as equipes passem do desenvolvimento local para a produção em larga escala sem problemas. Com um SDK Python-first e suporte para múltiplos idiomas, o Flyte capacita cientistas de dados e engenheiros a criar fluxos de trabalho complexos, versionados e de fácil manutenção.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Ask On Data VS Flyte — Dados principais
Dados principaisAsk On DataFlyte
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusETLMLOps
Público e funçõesNão verificadoNão verificado
CategoriasETL · Banco de Dados · Processamento de Dados · AutomaçãoMLOps · Orquestração · Automação
Added3 de ago. de 20253 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Ask On Data

Ask On Data é uma ferramenta revolucionária de engenharia de dados de código aberto que utiliza a IA Generativa para simplificar e acelerar a criação de pipelines de dados. Ela introduz uma interface baseada em chat, permitindo que os usuários interajam com seus dados e construam fluxos de trabalho complexos usando inglês simples. Essa abordagem remove efetivamente as barreiras técnicas, democratizando a engenharia de dados para uma ampla gama de usuários, desde analistas de negócios e cientistas de dados até engenheiros de dados experientes. A plataforma foi projetada para ser a pilha de dados da próxima geração, tornando o processamento de dados intuitivo, rápido e econômico.

Em sua essência, o Ask On Data visa resolver os gargalos comuns nos processos tradicionais de ETL (Extração, Transformação, Carga), como altos custos, curvas de aprendizado íngremes e dependência de engenheiros especializados. Ao fornecer um assistente de IA para tarefas de dados, ele reduz significativamente o tempo de desenvolvimento — em até 92% em comparação com ferramentas convencionais — e capacita as equipes a se tornarem mais autossuficientes em suas necessidades de preparação de dados.

Como usar Ask On Data

Usar o Ask On Data é tão simples quanto ter uma conversa. O fluxo de trabalho foi projetado para ser intuitivo e não requer conhecimento prévio de codificação:

  1. Conecte sua Fonte de Dados: Comece conectando-se aos seus dados de uma ampla variedade de fontes, incluindo arquivos planos (CSV, Excel), APIs, bancos de dados (como MySQL, PostgreSQL, Firebird), data lakes e data warehouses (como Amazon Redshift, Snowflake).
  2. Converse para Transformar: Use a interface de chat para emitir comandos em linguagem natural. Por exemplo, você pode digitar instruções como "Junte a tabela A com a tabela B na coluna user_id", "Remova linhas duplicadas" ou "Calcule o total de vendas para cada região".
  3. Pré-visualize em Tempo Real: À medida que você emite cada comando, o Ask On Data fornece uma pré-visualização instantânea dos dados transformados. Isso permite que você valide cada etapa do seu pipeline и garanta que as operações estão sendo executadas como esperado.
  4. Valide e Refine: Para usuários avançados que precisam de mais controle, a plataforma oferece a capacidade de visualizar, editar e até mesmo escrever código diretamente em SQL ou Python. Você também pode inspecionar o arquivo de configuração YAML subjacente para entender e ajustar todo o fluxo de trabalho.
  5. Agende e Automatize: Uma vez que seu pipeline de dados esteja completo, você pode agendá-lo para ser executado em frequências específicas (por exemplo, diariamente, de hora em hora). Você pode configurar detalhes do trabalho, como cargas completas, cargas incrementais ou operações de truncar e carregar.
  6. Desfaça e Revise: A plataforma mantém um histórico abrangente de todas as ações realizadas. Se você cometer um erro, pode usar facilmente a funcionalidade de desfazer para reverter as alterações.

Recursos principais do Ask On Data

  • Interface de Chat Alimentada por GenAI: Construa e gerencie pipelines de dados simplesmente digitando instruções em inglês simples, eliminando a necessidade de codificação.
  • Domínio de Pipelines de Dados: Crie, gerencie e otimize pipelines de dados de ponta a ponta para integração, limpeza, tratamento e transformação de dados.
  • Amplo Suporte a Fontes de Dados: Conecte-se a várias fontes de dados, incluindo arquivos, APIs, bancos de dados, data lakes e data warehouses.
  • Pré-visualização de Dados em Tempo Real: Veja instantaneamente os resultados de suas transformações, permitindo validação e iteração rápidas.
  • Controle de Código e Transparência: Para controle aprimorado, os usuários podem escrever SQL e Python ou editar o arquivo YAML do pipeline, tornando-o adequado para lidar com casos extremos.
  • Agendamento e Orquestração de Trabalhos: Automatize seus fluxos de trabalho de dados agendando trabalhos para serem executados em frequências especificadas com opções de carregamento detalhadas.
  • Histórico de Ações e Desfazer: Rastreie facilmente as alterações e reverta quaisquer erros com um histórico de ações abrangente e um simples botão de desfazer.
  • Implantação Flexível: Oferecido como um serviço em nuvem totalmente gerenciado ou como uma versão de código aberto gratuita e auto-hospedada.

Casos de uso para Ask On Data

O Ask On Data é versátil e beneficia um amplo espectro de usuários e cenários:

  • Cientistas de Dados e Engenheiros de ML: Prepare e pré-processe conjuntos de dados para modelos de aprendizado de máquina de forma independente, sem esperar pelas equipes de engenharia de dados.
  • Usuários de BI e Analistas de Dados: Acesse, limpe e transforme diretamente os dados para relatórios e dashboards, permitindo uma verdadeira análise de autoatendimento.
  • Engenheiros de Dados: Acelere drasticamente o desenvolvimento de pipelines complexos de ETL/ELT, liberando tempo para se concentrar em tarefas mais estratégicas.
  • Usuários de Negócios: Usuários não técnicos podem interagir com dados e realizar tarefas básicas de preparação de dados sem nenhum conhecimento de codificação.
  • Migração de Dados: Migre dados eficientemente entre diferentes sistemas, como mover de bancos de dados locais como MySQL ou Firebird para data warehouses na nuvem como Snowflake ou Redshift.

Vantagens do Ask On Data

O Ask On Data se destaca com várias vantagens principais:

  • Curva de Aprendizado Zero: A interface de chat intuitiva o torna acessível a qualquer pessoa, independentemente de sua formação técnica.
  • Velocidade Incomparável: Acelere o desenvolvimento de pipelines de dados de dias ou semanas para apenas minutos, alcançando economias significativas de tempo e custo.
  • Custo-benefício: Oferece mais de 80% de economia de custos em comparação com ferramentas de ETL licenciadas tradicionais, com um generoso plano gratuito e de código aberto.
  • Democratização dos Dados: Capacita todos os usuários dentro de uma organização a trabalhar com dados, quebrando silos e gargalos.
  • Flexibilidade e Controle: Equilibra a simplicidade sem código com o controle opcional baseado em código para máxima flexibilidade.

Preços e planos

O Ask On Data oferece vários planos para atender a diferentes necessidades:

  • Código Aberto: Uma versão totalmente gratuita e auto-hospedada que inclui suporte para todos os bancos de dados, recursos de agendamento e suporte da comunidade. Os usuários são responsáveis por patches e atualizações manuais.
  • Gratuito (Nuvem Gerenciada): Um plano gratuito hospedado na nuvem, ideal para uso em pequena escala. Suporta arquivos Excel e CSV (limite de até 5MB) e inclui atualizações automáticas, mas não possui agendamento de trabalhos.
  • Empresarial: Um plano premium de nuvem gerenciada para empresas. Inclui suporte para todas as fontes de dados, agendamento, suporte de nível empresarial, atualizações automáticas, backups e monitoramento. O preço é personalizado; as partes interessadas devem entrar em contato com o suporte.

Flyte

Flyte é uma plataforma de orquestração de fluxos de trabalho de nível de produção, de código aberto e nativa da nuvem, especificamente projetada para pipelines complexos de dados, aprendizado de máquina e análise. Como um projeto graduado da Cloud Native Computing Foundation (CNCF), o Flyte fornece uma espinha dorsal robusta e confiável para MLOps, preenchendo a lacuna entre o desenvolvimento local e ambientes de produção em larga escala. Ele permite que cientistas de dados e engenheiros de ML se concentrem em sua lógica, enquanto a plataforma lida com escalabilidade, reprodutibilidade, tolerância a falhas e gerenciamento de infraestrutura.

Como usar Flyte

Usar o Flyte envolve uma abordagem estruturada e baseada em código para definir e gerenciar fluxos de trabalho:

  1. Definir Tarefas (Tasks): Uma tarefa é a unidade fundamental de execução. Usando o SDK Python, você define uma tarefa com o decorador `@task`. Dentro da tarefa, você especifica suas entradas, saídas, requisitos de recursos (por exemplo, CPU, memória, GPU) e imagem de contêiner.
  2. Construir Fluxos de Trabalho (Workflows): Um fluxo de trabalho, definido com o decorador `@workflow`, encadeia tarefas para formar um Grafo Acíclico Dirigido (DAG). Você define o fluxo de dados entre as tarefas, criando um pipeline completo.
  3. Iteração Local: O Flyte fornece ferramentas como `pyflyte run` para executar e depurar seus fluxos de trabalho em sua máquina local. Isso permite uma iteração rápida e um ciclo de feedback apertado antes da implantação.
  4. Registrar para Produção: Quando seu fluxo de trabalho estiver pronto, você o registra em um cluster Flyte usando `pyflyte register`. Esta ação versiona todo o seu fluxo de trabalho, incluindo seu código e dependências, garantindo a reprodutibilidade.
  5. Lançar e Monitorar: Você pode acionar execuções de fluxo de trabalho através da UI do Flyte, um trabalho cron agendado ou a API. A UI fornece uma visão abrangente para monitorar execuções, inspecionar logs, visualizar saídas com FlyteDecks e analisar a linhagem de dados.
  6. Escalar com Recursos Avançados: Para processamento em larga escala, você pode aproveitar recursos como `map_task` para executar uma tarefa em paralelo sobre uma lista de entradas, ou usar fluxos de trabalho dinâmicos para ajustar a estrutura do pipeline em tempo de execução.

Recursos principais do Flyte

  • Reprodutibilidade e Versionamento: Cada tarefa e fluxo de trabalho é versionado e imutável. O Flyte rastreia automaticamente a linhagem de dados, permitindo que você rastreie qualquer saída até o código e os dados exatos que a produziram.
  • Escalabilidade e Desempenho: Construído sobre o Kubernetes, o Flyte é inerentemente escalável. Ele suporta alocação dinâmica de recursos, aceleração de GPU, instâncias spot/preemptivas para economia de custos e paralelismo massivo através de map tasks.
  • Experiência Centrada no Desenvolvedor: Apresenta um SDK Python-first que é intuitivo para cientistas de dados. Ele abstrai as complexidades da infraestrutura com recursos como `ImageSpec`, que constrói imagens de contêiner sem exigir conhecimento de Dockerfile.
  • Agnóstico de Linguagem: Embora o SDK principal seja Python, o Flyte suporta a escrita de tarefas em qualquer linguagem (Java, Scala, R, etc.) executando-as em seus próprios contêineres.
  • Manuseio Robusto de Dados: Fornece interfaces fortemente tipadas para capturar erros de dados em tempo de compilação. Os tipos `FlyteFile`, `FlyteDirectory` e `StructuredDataset` simplificam a E/S de dados entre tarefas e o armazenamento em nuvem.
  • Lógica de Orquestração Avançada: Suporta fluxos de trabalho dinâmicos, ramificação condicional, checkpointing intra-tarefa para tarefas de longa duração e cache para evitar a recomputação de etapas caras.
  • Pronto para Empresas: Oferece multilocação para isolamento de equipes, gerenciamento de segredos para acesso seguro a credenciais e notificações via Slack, PagerDuty ou e-mail.

Casos de uso para Flyte

O Flyte é versátil e usado em várias indústrias para pipelines de missão crítica:

  • Processamento de Dados em Larga Escala (ETL): Construção e agendamento de pipelines ETL robustos para processar terabytes de dados para análise e data warehousing.
  • Treinamento de Modelos de Aprendizado de Máquina: Orquestração de pipelines de ML de ponta a ponta, desde o pré-processamento de dados e engenharia de recursos até o treinamento de modelos distribuídos, otimização de hiperparâmetros e avaliação.
  • LLM e IA Generativa: Ajuste fino de Modelos de Linguagem Grandes (LLMs), construção de sistemas de Geração Aumentada por Recuperação (RAG) e gerenciamento de grafos de inferência complexos.
  • Bioinformática e Genômica: Execução de fluxos de trabalho de bioinformática computacionalmente intensivos, como alinhamento e análise de sequências de DNA, em escala.
  • Análise Geoespacial: Processamento de conjuntos de dados massivos de imagens de satélite para criar produtos de dados como mosaicos e modelos digitais de elevação, como demonstrado por seu uso com Xarray e GDAL.

Vantagens do Flyte

O Flyte oferece vantagens significativas sobre outros orquestradores:

  • Nível de Produção desde o Primeiro Dia: Seu foco em tipagem, versionamento e imutabilidade garante que os fluxos de trabalho sejam confiáveis e reprodutíveis.
  • Unifica Stacks de Dados e ML: Fornece uma única plataforma para engenheiros de dados, cientistas de ML e profissionais de análise, quebrando silos e promovendo a colaboração.
  • Reduz a Sobrecarga de Infraestrutura: Automatiza muitos dos aspectos desafiadores do MLOps, como conteinerização, gerenciamento de recursos и escalonamento.
  • Custo-Eficiente: O núcleo de código aberto é gratuito, enquanto recursos como cache, recuperação de falhas e suporte a instâncias spot reduzem significativamente os custos computacionais.
  • Ecossistema Vibrante: Como um projeto da CNCF, possui uma comunidade forte e se integra perfeitamente com uma ampla gama de ferramentas como Spark, Ray, Pandera, Great Expectations e muito mais.

Preços e planos

O Flyte é um projeto de código aberto licenciado sob a Apache 2.0, tornando-o completamente gratuito para baixar, usar e hospedar em sua própria infraestrutura. Para organizações que preferem uma solução de nível empresarial totalmente gerenciada, a Union.ai (a empresa que criou originalmente o Flyte) oferece uma plataforma em nuvem hospedada. Esta oferta comercial lida com toda a configuração, manutenção e escalonamento da infraestrutura, e inclui suporte empresarial e recursos adicionais.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
Automação
Só Ask On Data
ETLBanco de DadosProcessamento de Dados
Só Flyte
MLOpsOrquestração

Etiquetas

Em comum
Engenharia de DadosPipeline de dadosCódigo Aberto
Só Ask On Data
Apache Sparkautomação de dadosbanco de dadosmigração de dadosTransformação de dadosETLIA Generativalow-codeprocessamento de linguagem naturalNo-code
Só Flyte
Kubernetesaprendizado de máquinaMLOpsPythonReprodutibilidadeescalabilidadeOrquestração de fluxo de trabalho

Público e funções

Em comum
Sem dados verificados
Só Ask On Data
Sem dados verificados
Só Flyte
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Ask On Data monthly traffic:

Latest traffic · 2026-05

Visitas mensais
1.9K
Duração média
0:00
Páginas por visita
1.04
Taxa de rejeição
36.34%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 606
  • 2026-01: 1.7K
  • 2026-02: 731
  • 2026-03: 2K
  • 2026-04: 1.4K
  • 2026-05: 1.9K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States44.3%859
🇿🇦South Africa18.54%359
🇮🇳India18.18%353
🇹🇷Turkey13.82%268
🇲🇽Mexico5.16%100

Palavras-chave

askdataask on dataaskondataconvert firebird to postegressqlpostgresql import from firebird

Flyte monthly traffic:

Latest traffic · 2026-05

Visitas mensais
26.6K
Duração média
0:12
Páginas por visita
1.8
Taxa de rejeição
38.08%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 37.5K
  • 2026-01: 29.4K
  • 2026-02: 32.2K
  • 2026-03: 30K
  • 2026-04: 31K
  • 2026-05: 26.6K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States46.74%12.4K
🇮🇳India15.16%4K
🇻🇳Vietnam14.31%3.8K
🇨🇦Canada13.45%3.6K
🇩🇪Germany10.34%2.7K

Fontes de tráfego

Source typePercentageEstimated visits
Direto54.58%14.5K
Referência32.11%8.5K
E-mail13.31%3.5K

Palavras-chave

flyteflyte lyftgraphvizgraphviz onlinelyft flyte

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Ask On Data

Avaliação
Não verificado
Comentários
0
Favoritos
188
Curtidas
172

Flyte

Avaliação
Não verificado
Comentários
0
Favoritos
185
Curtidas
181

Ask On Data vs Flyte · FAQ da comparação

What do Ask On Data and Flyte have in common?
Both tools are listed under Automação. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Ask On Data and Flyte free?
Listed pricing models: Ask On Data — Freemium; Flyte — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Ask On Data and Flyte?
The primary listed category is ETL for Ask On Data, and MLOps for Flyte. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas