ToolMage
Entrar

AI TOOL COMPARISON

Datafold vs nao

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

Datafold Visão geral

O Datafold é uma plataforma alimentada por IA para equipes de engenharia de dados que automatiza testes de qualidade de dados, monitoramento e migrações. Ele usa a comparação de dados (data diffing) para comparar conjuntos de dados, permitindo a detecção proativa de problemas em CI/CD e garantindo 100% de paridade durante migrações complexas, acelerando os cronogramas em até 6x.

Preview

nao Visão geral

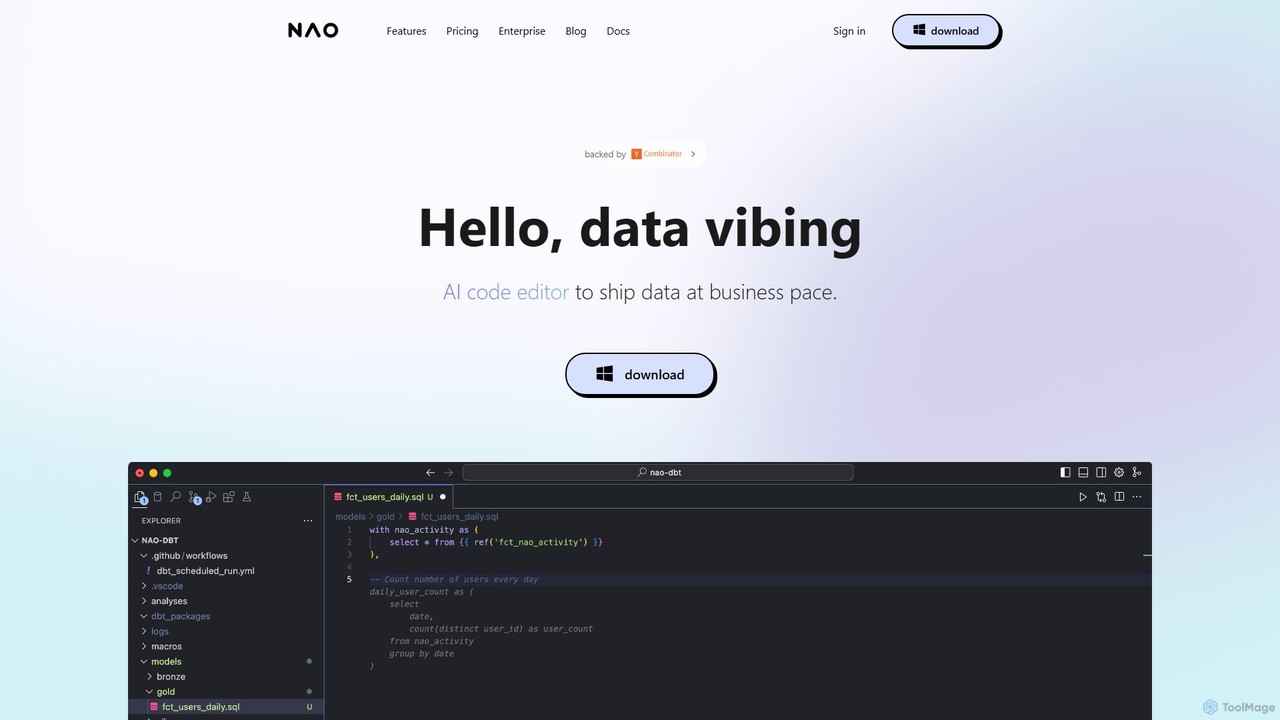
nao é um editor de código alimentado por IA projetado para equipes de dados. Ele otimiza a criação de pipelines de dados em SQL e Python, fluxos de trabalho dbt e análises, conectando-se nativamente ao seu data warehouse. Seu agente inteligente fornece sugestões de código cientes dos dados, verificações de qualidade e pré-visualizações de diferenças instantâneas para ajudá-lo a entregar dados de forma mais rápida e segura.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Datafold VS nao — Dados principais
Dados principaisDatafoldnao
Pricing modelPaidFreemium
Product typeWebApp
Primary focusAnáliseAnálise
Público e funçõesNão verificadoNão verificado
CategoriasAnálise · Banco de Dados · AutomaçãoAnálise · Banco de Dados · Assistente de Código
Added11 de ago. de 20255 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Datafold

O Datafold é uma plataforma unificada para qualidade de dados proativa, projetada especificamente para capacitar equipes de engenharia de dados. Ele aborda os aspectos mais críticos e desafiadores dos fluxos de trabalho de dados modernos: garantir a integridade absoluta dos dados e otimizar a modernização da infraestrutura de dados. Ao aproveitar o poder da IA, Modelos de Linguagem Grandes (LLMs) avançados e sua tecnologia proprietária de "comparação de dados" (data diffing), o Datafold automatiza as tarefas mais propensas a erros e demoradas. Isso permite que as equipes construam produtos de dados altamente confiáveis em um ritmo muito mais rápido.

A plataforma é fundada no princípio de que a qualidade dos dados deve ser uma parte proativa e integral do ciclo de vida do desenvolvimento, não uma reflexão tardia reativa. Ela fornece as ferramentas necessárias para que as empresas superem as limitações dos sistemas legados e construam com confiança uma pilha de dados pronta para IA com velocidade e precisão inigualáveis.

Como usar o Datafold

O Datafold se integra perfeitamente aos fluxos de trabalho de engenharia de dados existentes, fornecendo uma abordagem estruturada e automatizada para várias tarefas.

Para Migrações de Dados:

  1. Planejar: Utilize a linhagem detalhada em nível de coluna para mapear todas as dependências de dados e avaliar com precisão a complexidade da migração. Isso cria um plano detalhado, tornando os cronogramas do projeto previsíveis e transparentes.
  2. Traduzir: O Agente de Migração do Datafold (DMA), impulsionado por IA, converte automaticamente qualquer dialeto SQL ou lógica de transformação baseada em GUI para a sintaxe do sistema de destino (por exemplo, migrando de Oracle PL/SQL para Snowflake SQL). Ele emprega um loop de feedback inteligente para refinar iterativamente o código até que a paridade funcional perfeita seja alcançada.
  3. Validar: É aqui que a capacidade central de "comparação de dados" do Datafold se destaca. Ele realiza uma comparação em nível de valor de cada registro entre os sistemas legado e novo, verificando automaticamente 100% de precisão dos dados sem a necessidade de amostragem manual ou scripts tediosos.
  4. Entregar: Após a validação bem-sucedida, o Datafold gera relatórios abrangentes e evidências de comparação de dados auditáveis. Isso fornece prova concreta da paridade dos dados, o que acelera a aprovação das partes interessadas e permite o descomissionamento confiante do sistema legado.

Para Testes de Qualidade de Dados em CI/CD:

  1. Integração: Conecte o Datafold ao seu sistema de controle de versão, como GitHub ou GitLab.
  2. Teste Automatizado: Quando um desenvolvedor abre um pull request contendo alterações no código de transformação de dados (por exemplo, um modelo dbt), o Datafold é acionado automaticamente para executar uma comparação de dados entre os ambientes de desenvolvimento и produção.
  3. Revisar e Implantar: Os resultados são postados como um comentário claro e conciso dentro do pull request. Isso permite que os revisores vejam o impacto exato das alterações do código nos dados em nível de valor, impedindo que problemas de qualidade de dados cheguem à produção.

Recursos principais do Datafold

  • Migração de Dados Alimentada por IA (Agente de Migração do Datafold - DMA): Automatiza todo o ciclo de vida da migração, desde a tradução de código SQL entre dialetos díspares até a validação completa de ponta a ponta. Ele lida de forma inteligente com casos de borda complexos, como diferenças no tratamento de tipos de dados, funções não determinísticas e codificação de caracteres, para entregar uma migração até 6x mais rápida.
  • Comparação de Dados (Data Diffing): Um poderoso motor de validação que realiza comparações eficientes em nível de valor de conjuntos de dados inteiros, mesmo aqueles com bilhões de linhas. Ele identifica com precisão quaisquer adições, exclusões ou modificações para garantir 100% de paridade de dados.
  • Teste Proativo de CI/CD: Integra-se diretamente ao fluxo de trabalho de desenvolvimento (teste shift-left) para testar o código de transformação de dados antes da implantação. Inclui análise de impacto para visualizar como as alterações afetam tabelas downstream, painéis de BI e pipelines de ETL reverso.
  • Monitoramento e Observabilidade de Dados: Fornece detecção de anomalias alimentada por ML para monitorar a saúde dos dados em produção. Os usuários podem definir monitores como código (YAML) ou via UI para métricas, alterações de esquema e comparações agendadas entre bancos de dados, com alertas em tempo real via Slack, PagerDuty e e-mail.
  • Linhagem em Nível de Coluna: Oferece um mapa abrangente de dependências de dados que se estende além do data warehouse para ferramentas de BI (Tableau, Looker, Power BI) e outras aplicações. Isso é crucial para análise de impacto, análise de causa raiz e conformidade.
  • Teste de Replicação de Dados: Valida continuamente os dados entre os sistemas de origem e de destino em pipelines de replicação contínuos, garantindo que os dados de missão crítica permaneçam sincronizados e precisos o tempo todo.

Casos de uso para o Datafold

  • Modernização da Pilha de Dados: Acelere drasticamente as migrações de sistemas legados (por exemplo, Oracle, Teradata, SQL Server) para plataformas de dados em nuvem modernas (por exemplo, Snowflake, BigQuery, Databricks). Por exemplo, a Faire migrou mais de 5.000 tabelas do Redshift para o Snowflake seis meses antes do previsto usando o Datafold.
  • Desenvolvimento e Teste de dbt: Potencialize os fluxos de trabalho do dbt testando automaticamente cada pull request, garantindo que as alterações nos modelos dbt não introduzam regressões na qualidade dos dados.
  • Garantia da Precisão do Painel de BI: Use a linhagem em nível de coluna para rastrear os dados desde a origem até os painéis de BI, garantindo que os relatórios de negócios sejam construídos sobre uma base de dados confiável e precisa.
  • Validação de Pipelines de Replicação: Para organizações que usam ferramentas de ingestão de dados como Fivetran ou Airbyte, o Datafold pode agendar comparações de dados regulares para certificar que os dados no data warehouse de destino espelham perfeitamente a origem.

Vantagens do Datafold

  • Velocidade Sem Precedentes: Comprime os cronogramas de migração de anos para semanas, automatizando as partes mais trabalhosas do processo.
  • Precisão Garantida: Vai além da simples contagem de linhas para uma validação exaustiva em nível de valor, eliminando o risco de perda ou corrupção de dados.
  • Aumento da Velocidade do Desenvolvedor: Captura bugs de dados no início do pipeline de CI/CD, capacitando os engenheiros a entregar código mais rápido e com maior confiança.
  • Proativo, Não Reativo: Implementa uma filosofia "shift-left" para a qualidade dos dados, prevenindo problemas antes que possam impactar os sistemas de produção e as operações de negócios.
  • Confiança e Colaboração Aprimoradas: Fornece prova auditável e inegável da qualidade dos dados, o que constrói confiança com as partes interessadas do negócio e otimiza as aprovações de projetos.
  • Implantação Segura e Flexível: Oferece múltiplos modelos de implantação (SaaS, VPC de locatário único, auto-hospedado) e está em conformidade com os principais padrões como SOC2 Tipo II, GDPR e HIPAA.

Preços e planos

O Datafold oferece preços personalizados, adaptados aos requisitos exclusivos de cada equipe. O modelo de preços baseia-se principalmente no número de usuários e no volume de tabelas sendo monitoradas e testadas. Embora a plataforma seja normalmente vendida como uma solução abrangente, recursos específicos, como conversão e validação de migração única ou linhagem de nível de coluna independente, podem ser adquiridos separadamente. Para obter uma cotação de preço precisa, os clientes em potencial devem entrar em contato com a equipe de vendas do Datafold solicitando uma demonstração em seu site oficial.

nao

nao é um revolucionário editor de código de IA construído desde o início para profissionais de dados. Ele visa acelerar todo o fluxo de trabalho de dados, desde a escrita de código até a implantação de pipelines, integrando-se profundamente ao seu ecossistema de dados. Projetado para analistas de dados, engenheiros de análise, cientistas de dados e engenheiros de dados, o nao atua como um parceiro inteligente, entendendo o contexto de seus dados para ajudá-lo a escrever código que não é apenas sintaticamente correto, mas também semanticamente sólido e seguro para seu ambiente de produção.

Diferente de assistentes de código de IA genéricos, o nao se conecta diretamente ao seu data warehouse (suportando plataformas como Databricks, DuckDB e mais). Essa integração nativa permite que sua IA seja 'ciente dos dados', fornecendo sugestões baseadas em seu esquema real, estruturas de tabela e nomes de coluna. Isso elimina a adivinhação e reduz significativamente os erros. O núcleo do nao é seu poderoso agente de IA, que vai além da simples conclusão de código para se tornar um guardião da qualidade de seus dados.

Como usar nao

Começar a usar o nao é um processo direto, projetado para se integrar perfeitamente ao seu fluxo de trabalho existente:

  1. Baixe e Instale: Comece baixando o IDE nao gratuitamente no site oficial. É um aplicativo autônomo que roda em sua máquina local.
  2. Conecte seu Data Warehouse: O primeiro passo crucial é conectar o nao à sua fonte de dados. Essa conexão segura permite que a IA acesse os metadados do seu esquema (não seus dados reais, que permanecem locais) para fornecer assistência sensível ao contexto.
  3. Comece a Codificar: Abra uma planilha SQL ou um script Python. Conforme você digita, a IA do nao fornece autocompletar inteligente para consultas SQL e modelos dbt, ciente de suas tabelas e colunas específicas.
  4. Aproveite o Agente de IA: Use a guia de IA dedicada para interagir com o agente. Você pode pedir para gerar consultas complexas, criar modelos dbt, escrever documentação ou adicionar testes. O agente entende o contexto do seu projeto, incluindo modelos dbt e linhagem em nível de coluna.
  5. Pré-visualize e Compare: Antes de confirmar qualquer alteração, use o recurso 'Pré-visualização de Diferenças Instantânea'. Isso mostra o impacto direto que seu novo código terá nos dados, ajudando a identificar problemas potenciais e a evitar quebrar painéis ou relatórios downstream.
  6. Execute Verificações e Implante: O agente pode executar verificações de qualidade de dados e seus testes existentes para validar seu código. Uma vez confiante, você pode entregar seus pipelines de dados mais rápido e com maior confiança.

Recursos principais do nao

  • Editor de Código Alimentado por IA: Otimizado para SQL e Python com autocompletar inteligente, geração de código e capacidades de análise conversacional.
  • Integração Nativa com Data Warehouse: Conecta-se diretamente às suas fontes de dados como Databricks e DuckDB para sugestões de IA cientes do esquema.
  • Agente de IA Avançado: Um agente multifacetado que auxilia com verificações de qualidade de dados, diferenças de dados instantâneas, execução de testes e compreensão da linhagem em nível de coluna.
  • Integração Profunda com dbt: Pré-visualize modelos dbt diretamente no IDE, obtenha autocompletar para colunas de modelo e visualize o gráfico de linhagem para entender as dependências.
  • Pré-visualização de Diferenças Instantânea: Veja o impacto de suas alterações de código nos dados em tempo real, prevenindo consequências não intencionais.
  • Análise e Gráficos Conversacionais: Interaja com seus dados usando linguagem natural para gerar insights e visualizações diretamente no editor.
  • Segurança de Nível Empresarial: Seus dados e código permanecem locais. Nada é compartilhado com um LLM sem permissão explícita, e os planos empresariais oferecem opções para LLMs auto-hospedados para manter tudo dentro de sua infraestrutura.
  • Ambiente de Desenvolvimento Unificado: Combina as ferramentas que você ama — editor SQL, ferramenta de transformação (dbt) e linhagem de BI — em um único IDE coeso.

Casos de uso para nao

O nao é versátil e pode ser aplicado a inúmeras tarefas relacionadas a dados:

  • Desenvolvimento Acelerado de Pipelines de Dados: Construa e itere rapidamente em pipelines de SQL e Python com código gerado por IA e feedback instantâneo.
  • Gerenciamento Robusto de Fluxos de Trabalho dbt: Crie, teste e documente modelos dbt de forma mais eficiente. Entenda o impacto das alterações com linhagem em nível de coluna e pré-visualizações de modelo.
  • Análise de Dados Complexa: Realize análises sofisticadas como distribuição, retenção, conversão e análise de causa raiz usando prompts conversacionais e ferramentas de consulta poderosas.
  • Garantia de Qualidade de Dados: Identifique e corrija proativamente problemas de qualidade de dados antes que afetem a produção, usando as verificações automatizadas e as diferenças de dados do agente.
  • Refatoração Segura de Código: Refatore com confiança consultas SQL complexas ou modelos dbt, usando a pré-visualização de diferenças instantânea para garantir que a saída permaneça consistente.

Vantagens do nao

O nao oferece vantagens significativas sobre editores de código tradicionais e outros assistentes de IA:

  • Inteligência Ciente dos Dados: Ao contrário de ferramentas como o Cursor, as sugestões do nao não são genéricas; elas são adaptadas ao seu esquema de dados específico, resultando em código que funciona corretamente na primeira vez.
  • Segurança e Confiabilidade Aprimoradas: O foco em verificações de qualidade de dados, diferenças e análise de impacto da linhagem ajuda a prevenir quebras de dados, protegendo seus painéis de BI e relatórios analíticos.
  • Produtividade Aumentada: Ao unificar várias ferramentas em um IDE e automatizar tarefas repetitivas, o nao permite que as equipes de dados entreguem projetos significativamente mais rápido.
  • Segurança Incomprometida: Com uma forte ênfase na privacidade de dados, o nao garante que seus dados sensíveis e código proprietário estejam seguros, oferecendo controles de nível empresarial para máxima proteção.

Preços e planos

O nao oferece uma estrutura de preços flexível para atender a diferentes necessidades:

  • Plano Starter: Gratuito. Este plano inclui um teste de 15 dias dos recursos Pro, conexão básica com o data warehouse, autocompletar SQL e pré-visualizações e linhagem dbt.
  • Plano Pro: $30 por usuário/mês. Inclui tudo no plano Starter, mais a guia de IA completa em seus dados, o agente de IA completo para fluxos de trabalho de dados, diferença de dados instantânea e suporte direto.
  • Plano Enterprise: Preços personalizados. Este plano inclui todos os recursos Pro, mais segurança de dados de nível empresarial, a opção de LLMs hospedados pela empresa, um espaço de trabalho empresarial e uma equipe de suporte dedicada.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
AnáliseBanco de Dados
Só Datafold
Automação
Só nao
Assistente de Código

Etiquetas

Em comum
banco de dadosqualidade de dadosdbtSQL
Só Datafold
automaçãoCI/CDEngenharia de Dadosmigração de dadosObservabilidade de dadosTeste de dadosValidação de dados
Só nao
Assistente de IAEngenharia de AnalyticsEditor de códigoanálise de dadosPipeline de dadosFerramentas de desenvolvedorPython

Público e funções

Em comum
Sem dados verificados
Só Datafold
Sem dados verificados
Só nao
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Datafold monthly traffic:

Latest traffic · 2026-05

Visitas mensais
21K
Duração média
1:16
Páginas por visita
2.13
Taxa de rejeição
39.96%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 33.5K
  • 2026-01: 24.6K
  • 2026-02: 19.6K
  • 2026-03: 26.3K
  • 2026-04: 20.8K
  • 2026-05: 21K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.41%11.4K
🇻🇳Vietnam13.86%2.9K
🇮🇳India12.19%2.6K
🇹🇭Thailand10.7%2.2K
🇵🇰Pakistan8.84%1.9K

Fontes de tráfego

Source typePercentageEstimated visits
Direto94.33%19.8K
Referência5.67%1.2K

Palavras-chave

data-diffdatafolddbt pythonnutrafol revenueopen source data warehouse

nao monthly traffic:

Latest traffic · 2026-05

Visitas mensais
19.1K
Duração média
0:22
Páginas por visita
1.73
Taxa de rejeição
40.34%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 4K
  • 2026-01: 17.9K
  • 2026-02: 24.2K
  • 2026-03: 22.6K
  • 2026-04: 17.3K
  • 2026-05: 19.1K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.42%10.4K
🇮🇳India18.31%3.5K
🇫🇷France10.18%1.9K
🇩🇪Germany9.04%1.7K
🇧🇷Brazil8.05%1.5K

Fontes de tráfego

Source typePercentageEstimated visits
Direto57.37%11K
Referência42.63%8.1K

Palavras-chave

naonao datanao idenao labnao labs

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Datafold

Avaliação
Não verificado
Comentários
0
Favoritos
183
Curtidas
182

nao

Avaliação
Não verificado
Comentários
0
Favoritos
169
Curtidas
148

Datafold vs nao · FAQ da comparação

What do Datafold and nao have in common?
Both tools are listed under Análise、Banco de Dados. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Datafold and nao free?
Listed pricing models: Datafold — Paid; nao — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Datafold and nao?
The primary listed category is Análise for Datafold, and Análise for nao. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas