ToolMage
Entrar

AI TOOL COMPARISON

dstack vs UbiOps

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

dstack Visão geral

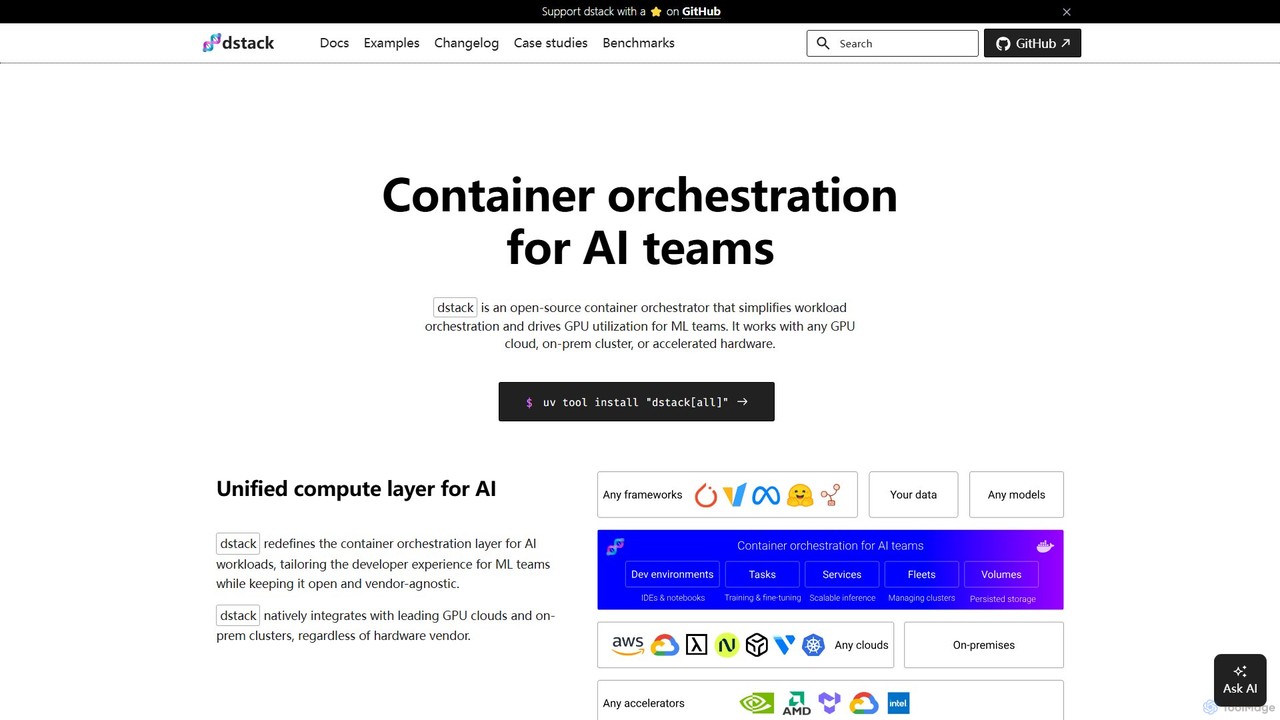
dstack é um orquestrador de contêineres de código aberto projetado para equipes de IA e ML. Ele simplifica a orquestração de cargas de trabalho e maximiza a utilização de GPUs em qualquer provedor de nuvem, cluster local ou hardware acelerado. Ele fornece uma camada de computação unificada, otimizando o desenvolvimento, treinamento e implantação de modelos.

Preview

UbiOps Visão geral

UbiOps é uma poderosa plataforma de MLOps para serviço, orquestração e treinamento de modelos de IA. Permite que cientistas de dados e equipes de IA implementem, gerenciem e escalem seus modelos de forma transparente em qualquer infraestrutura — local, híbrida ou multinuvem — sem a necessidade de conhecimento profundo em engenharia. A plataforma lida com a conteinerização, criação de API e escalonamento automático, acelerando o caminho do desenvolvimento para a produção para várias aplicações de IA, incluindo IA Generativa e Visão Computacional.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

dstack VS UbiOps — Dados principais
Dados principaisdstackUbiOps
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusOrquestraçãoPlataforma como Serviço (PaaS)
Público e funçõesNão verificadoNão verificado
CategoriasOrquestração · MLOps · Gestão de InfraestruturaPlataforma como Serviço (PaaS) · Implantação de Modelo · MLOps
Added8 de ago. de 20253 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

dstack

dstack é um poderoso orquestrador de contêineres de código aberto, projetado especificamente para enfrentar os desafios enfrentados pelas equipes de Inteligência Artificial e Machine Learning. Seu objetivo principal é simplificar o complexo processo de orquestração de cargas de trabalho e melhorar significativamente a utilização de recursos caros de GPU. Como uma plataforma agnóstica de fornecedor, o dstack oferece uma camada de computação unificada que se integra perfeitamente com qualquer nuvem de GPU (como AWS, GCP, Azure, OCI), clusters locais e uma vasta gama de hardware acelerado, incluindo NVIDIA, AMD, TPUs e mais. Essa flexibilidade garante que as equipes não fiquem presas a um único provedor e possam aproveitar o melhor hardware para suas necessidades, onde quer que esteja localizado.

A plataforma foi projetada com a experiência do desenvolvedor em seu núcleo, abstraindo as complexidades da infraestrutura subjacente. Isso permite que engenheiros de ML e pesquisadores se concentrem na construção, treinamento e implantação de modelos, em vez de gerenciar servidores, dependências e escalonamento. O dstack é confiável por equipes de ML de classe mundial em empresas como Electronic Arts e Mobius Labs por sua capacidade de escalar desde a prototipagem rápida até grandes trabalhos de treinamento distribuído em múltiplos nós.

Como usar dstack

Começar a usar o dstack é um processo direto, projetado para adoção rápida:

  1. Configurar o Servidor: Você pode começar instalando o servidor dstack em sua máquina local usando um comando simples como uv tool install "dstack[all]" e executando-o com dstack server. Alternativamente, você pode implantá-lo em qualquer lugar usando a imagem Docker oficial ou se inscrever no dstack Sky, a versão gerenciada na nuvem, para evitar o auto-hospedagem.
  2. Definir Configurações: Os fluxos de trabalho no dstack são definidos usando arquivos YAML simples dentro do seu repositório de projeto. Essas configurações descrevem o ambiente, os recursos e os comandos para suas tarefas. Os principais tipos de configuração incluem:
    • Ambientes de Desenvolvimento (Dev Environments): Para desenvolvimento interativo, permitindo que você conecte seu IDE local (como o VS Code) a uma poderosa máquina GPU remota.
    • Tarefas (Tasks): Para agendar trabalhos em lote, como pré-treinamento ou ajuste fino de modelos. Ideal para cargas de trabalho que são executadas até a conclusão.
    • Serviços (Services): Para implantar modelos como endpoints seguros, com autoescalonamento e compatíveis com OpenAI.
    • Frotas (Fleets): Para gerenciar grupos de instâncias na nuvem ou locais como um único pool de recursos.
  3. Aplicar Configurações: Quando seu arquivo YAML estiver pronto, você o aplica usando a interface de linha de comando: dstack apply. O dstack então cuida do resto: provisionando a infraestrutura necessária, agendando o trabalho, gerenciando o autoescalonamento, tratando o encaminhamento de portas e transmitindo os logs de volta para o seu terminal. Para execução desacoplada, você pode usar a flag -d.

Recursos principais do dstack

  • Camada de Computação Unificada: Fornece um único plano de controle agnóstico de fornecedor para todos os seus recursos de computação de IA, seja na nuvem ou localmente.
  • Amplo Suporte a Aceleradores: Suporta nativamente uma ampla gama de hardware, incluindo GPUs NVIDIA, GPUs AMD, TPUs do Google Cloud, Intel Gaudi e aceleradores Tenstorrent.
  • Fluxos de Trabalho Centrados no Desenvolvedor: Oferece configurações especializadas como Ambientes de Desenvolvimento para codificação interativa, Tarefas para processamento em lote e Serviços para fácil implantação de modelos.
  • Gerenciamento Eficiente de Recursos: Possui um agendador integrado para maximizar a utilização de GPUs. Inclui políticas para encerrar automaticamente instâncias subutilizadas, economizando custos.
  • Integração Perfeita: Funciona sem problemas com as principais nuvens de GPU (AWS, GCP, Azure, OCI) e pode ser executado sobre clusters Kubernetes existentes. As frotas SSH permitem a conexão de servidores bare-metal.
  • Serviços de Autoescalonamento: Implante facilmente modelos como serviços prontos para produção com recursos como autoescalonamento, HTTPS e endpoints de API compatíveis com OpenAI.
  • Persistência de Dados: Suporta volumes de rede e de instância para persistir dados, modelos e caches entre as execuções, garantindo que o estado não seja perdido.
  • Configuração Avançada: Permite controle refinado com recursos como políticas de nova tentativa para problemas de capacidade, gerenciamento de variáveis de ambiente e suporte a imagens Docker personalizadas.

Casos de uso para dstack

O dstack é versátil e suporta uma ampla gama de fluxos de trabalho de ML:

  • Treinamento e Ajuste Fino de Modelos: Execute trabalhos de treinamento de nó único ou distribuído para grandes modelos de linguagem (LLMs) usando frameworks populares como TRL, Axolotl e DeepSpeed.
  • Inferência e Serviço de Modelos: Implante modelos otimizados para inferência usando frameworks de serviço de alto desempenho como vLLM, SGLang, TGI e NVIDIA NIM.
  • Desenvolvimento Interativo de IA: Engenheiros de ML podem iniciar poderosos ambientes de desenvolvimento com suporte de GPU em segundos, conectando seu IDE local para experimentar e depurar código interativamente.
  • Gerenciamento de Clusters de Alto Desempenho: Configure e execute testes (por exemplo, testes NCCL) em clusters especializados de múltiplos nós, como GCP A3 Mega ou instâncias habilitadas para AWS EFA.
  • Otimização de Custos entre Nuvens: Compare e utilize sem esforço as instâncias de GPU mais econômicas entre diferentes provedores de nuvem para qualquer tarefa.

Vantagens do dstack

A principal vantagem do dstack é sua capacidade de simplificar drasticamente a infraestrutura de IA. Ele capacita as equipes de ML, permitindo que se concentrem em suas pesquisas e modelos em vez da infraestrutura. Os principais benefícios incluem aumento da produtividade, economia significativa de custos através de uma melhor utilização de GPUs e acesso a instâncias spot, e a prevenção de aprisionamento tecnológico (vendor lock-in). Sua natureza de código aberto promove a transparência e o desenvolvimento impulsionado pela comunidade, enquanto o design centrado no desenvolvedor torna incrivelmente fácil definir uma configuração e executá-la sem se preocupar com a disponibilidade de GPUs ou configurações complexas.

Preços e planos

O dstack oferece uma estrutura de preços flexível para atender a diferentes necessidades:

  • dstack (Código Aberto): A plataforma principal é de código aberto e de uso gratuito. Você pode auto-hospedá-la em sua própria infraestrutura sem taxas de licença.
  • dstack Sky: Um serviço de nuvem gerenciado que cuida da hospedagem do servidor dstack para você. Ele também fornece acesso a um mercado das GPUs mais baratas. Oferece um nível gratuito para começar.
  • dstack Enterprise: Uma versão auto-hospedada projetada para organizações maiores, que inclui recursos de nível empresarial como Single Sign-On (SSO), controles avançados de governança e suporte empresarial dedicado. Um teste pode ser solicitado para esta versão.

Este modelo torna o dstack acessível a pesquisadores individuais, startups e grandes empresas.

UbiOps

UbiOps é uma plataforma de software abrangente projetada para simplificar e acelerar a implantação, gerenciamento e escalonamento de modelos de IA e machine learning. Ela capacita as organizações a executar sua 'IA Privada' em seus próprios termos, seja em infraestrutura local, em uma configuração híbrida ou em múltiplos provedores de nuvem. Ao abstrair a complexidade de engenharia subjacente de tecnologias como o Kubernetes, a UbiOps permite que as equipes de IA se concentrem na construção e iteração de seus modelos, reduzindo significativamente o tempo de lançamento no mercado e garantindo conformidade e governança robustas. É uma solução testada em batalha, usada em setores críticos como saúde e setor público, fornecendo uma espinha dorsal confiável и escalável para IA de nível de produção.

Como usar UbiOps

Começar a usar a UbiOps é um processo estruturado, projetado para usuários novos e avançados:

  1. Cadastre-se: Crie uma conta gratuita da UbiOps em seu site para acessar a plataforma.
  2. Escolha sua Interface: Interaja com a plataforma de uma maneira que se adapte ao seu fluxo de trabalho. Você pode usar a WebApp amigável para gerenciamento visual, a Biblioteca Cliente Python para integração programática em seus scripts, a poderosa Interface de Linha de Comando (CLI) para operações baseadas em terminal, ou a API REST para integrações personalizadas.
  3. Defina um Ambiente: Crie um 'Ambiente' reutilizável especificando as bibliotecas, pacotes e dependências necessários para o seu código (por exemplo, versão do Python, PyTorch, TensorFlow). A UbiOps construirá uma imagem de contêiner para você, garantindo consistência.
  4. Implante seu Modelo: Empacote seu modelo de IA ou script de processamento de dados em uma 'Implantação'. A UbiOps automaticamente conteineriza o código e o expõe como um microsserviço seguro e escalável com seu próprio endpoint de API. Você pode gerenciar várias versões de cada implantação.
  5. Construa Pipelines: Para fluxos de trabalho complexos, use o recurso 'Pipelines'. Isso permite que você encadeie várias implantações, orquestrando o fluxo de dados entre diferentes modelos ou etapas de processamento para construir um fluxo de dados completo.
  6. Treine Modelos: Utilize o recurso 'Treinamento' para executar e gerenciar trabalhos de treinamento de modelos. Defina um 'Experimento' com o hardware desejado (incluindo GPUs) e execute várias 'Execuções de Treinamento' em paralelo para testar eficientemente diferentes parâmetros e encontrar o melhor modelo.
  7. Execute e Escale: Envie solicitações para suas APIs de implantação ou pipeline para processar dados. A UbiOps lida com o enfileiramento de solicitações, balanceamento de carga e escalonamento automático com base na demanda, garantindo que sua aplicação esteja sempre responsiva.

Recursos principais do UbiOps

  • Serviço e Orquestração de Modelos Unificados: Implante modelos como microsserviços versionados e escaláveis com geração automática de API. Construa fluxos de trabalho complexos de várias etapas (Pipelines) para conectar modelos e tarefas de processamento de dados de forma transparente.
  • Suporte Flexível à Infraestrutura: Execute cargas de trabalho de IA em qualquer lugar — servidores locais, nuvem privada, nuvens públicas (AWS, Azure, GCP) ou uma combinação híbrida. Suporta Kubernetes, Máquinas Virtuais e até mesmo infraestrutura bare metal.
  • Treinamento de Modelo Integrado: Um ambiente dedicado para executar, gerenciar e rastrear experimentos de treinamento de modelos. Escale trabalhos de treinamento em hardware poderoso, incluindo vários tipos de GPU, e gerencie artefatos com facilidade.
  • Gerenciamento de Ambiente: Defina e reutilize ambientes de contêiner com bibliotecas e dependências específicas, garantindo consistência perfeita entre desenvolvimento, teste e produção.
  • Governança e Segurança Avançadas: Recursos para gerenciamento de versões, agendamento de trabalhos, monitoramento detalhado e protocolos de segurança robustos para garantir conformidade e controle total sobre seus ativos de IA.
  • Múltiplos Métodos de Interação: A funcionalidade completa da plataforma é acessível através de uma WebApp, Biblioteca Cliente Python, API REST e CLI, atendendo a diferentes preferências de usuário e permitindo uma automação poderosa.

Casos de uso para UbiOps

A UbiOps é versátil e pode ser aplicada a uma ampla gama de aplicações de IA:

  • Implantação de IA Generativa: Implante e sirva grandes modelos de linguagem (LLMs) e outros modelos generativos para aplicações como chatbots, criação de conteúdo e geração de código.
  • Visão Computacional: Execute modelos de análise de imagem e vídeo para detecção de objetos, classificação de imagens e reconhecimento facial em ambientes de produção.
  • Análise Preditiva: Implante modelos clássicos de machine learning para previsão, detecção de fraudes e previsão de churn de clientes.
  • Pipelines de Processamento de Dados: Crie fluxos de trabalho automatizados para limpeza, transformação e engenharia de recursos de dados como um precursor para a inferência do modelo.
  • MLOps de Nuvem Híbrida: Ideal para organizações que precisam processar dados sensíveis localmente enquanto aproveitam a escalabilidade da nuvem pública para tarefas menos sensíveis.

Vantagens do UbiOps

A UbiOps oferece vantagens significativas para as equipes de IA:

  • Tempo de Lançamento Acelerado: Reduz drasticamente o tempo e o esforço de engenharia necessários para mover modelos de IA de um laptop para um serviço escalável e de nível de produção.
  • Agnóstico à Infraestrutura: Evita o aprisionamento a fornecedores, fornecendo a liberdade de executar IA em qualquer hardware ou provedor de nuvem, dando a você controle total.
  • MLOps Simplificado: Abstrai o gerenciamento complexo de infraestrutura (como o Kubernetes), permitindo que os cientistas de dados sejam mais autossuficientes e se concentrem no desenvolvimento de modelos.
  • Escalabilidade e Confiabilidade: Construído para lidar com cargas de trabalho de produção com escalonamento automático, tratamento de solicitações e alta disponibilidade, garantindo um desempenho robusto.
  • Segurança e Conformidade Aprimoradas: Perfeito para iniciativas de 'IA Privada', garantindo que os dados permaneçam sob seu controle e atendam a requisitos regulatórios rigorosos.

Preços e planos

A UbiOps oferece uma estrutura de preços flexível para atender a diferentes necessidades, desde desenvolvedores individuais até grandes empresas. Embora os preços específicos devam ser verificados no site oficial, os planos geralmente seguem esta estrutura:

  • Plano Gratuito: Um generoso nível gratuito para indivíduos e pequenos projetos, permitindo que os usuários explorem os recursos principais da plataforma com certos limites de uso.
  • Plano Profissional: Um plano pago para profissionais e pequenas equipes que precisam de mais recursos de computação, maiores volumes de solicitação e recursos adicionais.
  • Plano de Negócios: Projetado para empresas em crescimento, oferecendo mais capacidade, recursos avançados e suporte dedicado.
  • Plano Empresarial: Um plano personalizado para grandes organizações com requisitos específicos para implantação em nuvem local/privada, segurança avançada, integrações personalizadas e suporte premium. As partes interessadas são incentivadas a agendar uma chamada para um orçamento personalizado.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
MLOps
Só dstack
OrquestraçãoGestão de Infraestrutura
Só UbiOps
Plataforma como Serviço (PaaS)Implantação de Modelo

Etiquetas

Em comum
Kubernetesaprendizado de máquinaMLOpsImplantação de modelo
Só dstack
Desenvolvimento de IAcomputação em nuvemOrquestração de contêineresGerenciamento de GPUInfraestrutura como CódigoCódigo Aberto
Só UbiOps
Orquestração de IAciência de dadosnuvem híbridaServiço de modeloPaaSIA privada

Público e funções

Em comum
Sem dados verificados
Só dstack
Sem dados verificados
Só UbiOps
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

dstack monthly traffic:

Latest traffic · 2026-05

Visitas mensais
13.1K
Duração média
0:02
Páginas por visita
1.21
Taxa de rejeição
53.77%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 4.8K
  • 2026-01: 16.2K
  • 2026-02: 19.7K
  • 2026-03: 11.8K
  • 2026-04: 9.4K
  • 2026-05: 13.1K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇫🇷France64.99%8.5K
🇺🇸United States15.02%2K
🇷🇺Russia7.76%1K
🇮🇳India7.35%962
🇩🇪Germany4.88%639

Fontes de tráfego

Source typePercentageEstimated visits
Direto61.06%8K
E-mail20.74%2.7K
Referência18.2%2.4K

Palavras-chave

dstackdstack serverdstack sky free creditssglang routertrl sft コマンドで複数ノードで実行する方法

UbiOps monthly traffic:

Latest traffic · 2026-05

Visitas mensais
13.8K
Duração média
13:51
Páginas por visita
25.97
Taxa de rejeição
20.37%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 9.4K
  • 2026-01: 18.2K
  • 2026-02: 13.6K
  • 2026-03: 18K
  • 2026-04: 21.3K
  • 2026-05: 13.8K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇱Netherlands83.82%11.6K
🇺🇸United States9.39%1.3K
🇮🇳India4.08%563
🇩🇪Germany1.48%204
🇬🇧United Kingdom1.23%170

Fontes de tráfego

Source typePercentageEstimated visits
Direto80.99%11.2K
E-mail17.45%2.4K
Referência1.56%215

Palavras-chave

machine learning operations (mlops) what does it mean in documentationmondomonger deepfakeonnx cpu vs gpuubiopsubi platform api docs

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

dstack

Avaliação
Não verificado
Comentários
0
Favoritos
215
Curtidas
208

UbiOps

Avaliação
Não verificado
Comentários
0
Favoritos
182
Curtidas
197

dstack vs UbiOps · FAQ da comparação

What do dstack and UbiOps have in common?
Both tools are listed under MLOps. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are dstack and UbiOps free?
Listed pricing models: dstack — Freemium; UbiOps — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between dstack and UbiOps?
The primary listed category is Orquestração for dstack, and Plataforma como Serviço (PaaS) for UbiOps. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas