ToolMage
Entrar

AI TOOL COMPARISON

Elementary Data vs Lilac

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

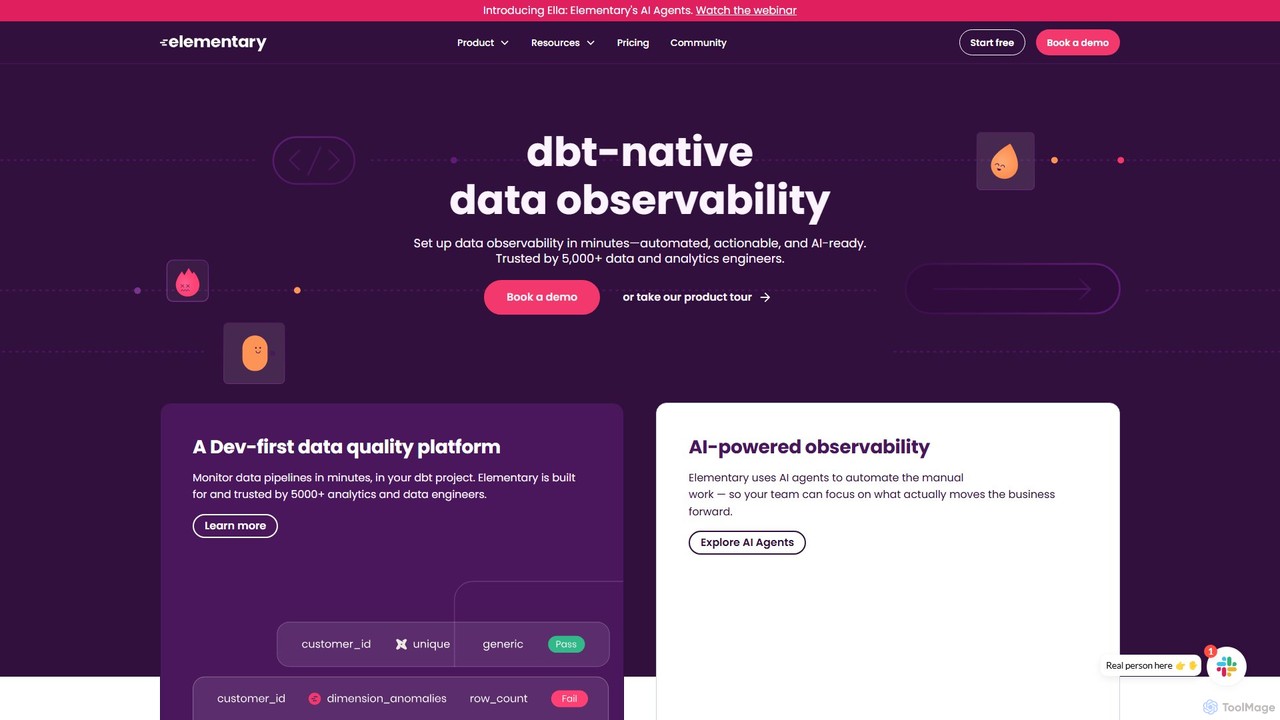
Elementary Data Visão geral

O Elementary Data é uma plataforma de observabilidade de dados nativa do dbt, projetada para engenheiros de dados e de análise. Ele usa agentes de IA para automatizar o monitoramento da qualidade dos dados, detectar anomalias e fornecer linhagem de ponta a ponta. A plataforma ajuda as equipes a reduzir o ruído de alertas, resolver incidentes mais rapidamente e construir confiança em seus dados para aplicações de IA e análise.

Preview

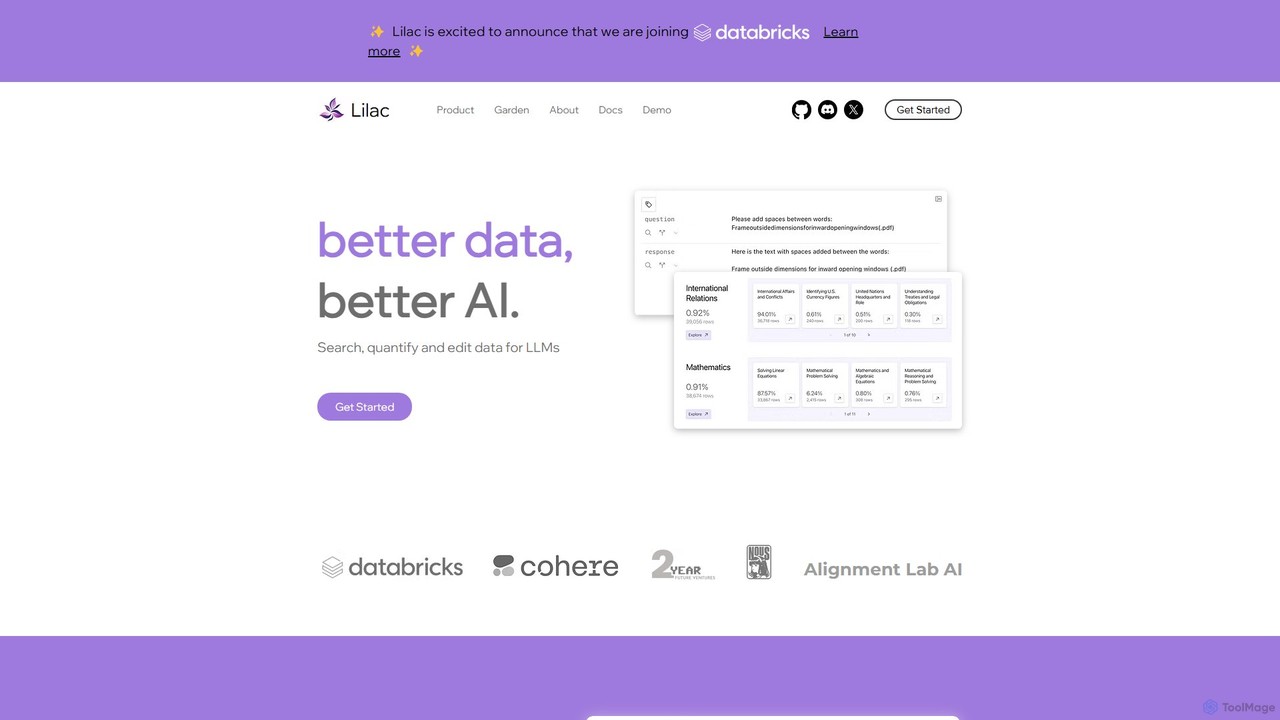
Lilac Visão geral

Lilac é uma ferramenta de código aberto para cientistas de dados e engenheiros de ML explorarem, limparem e melhorarem conjuntos de dados para modelos de linguagem grandes (LLMs). Oferece busca semântica poderosa, clusterização de dados e análise de qualidade para construir uma IA melhor.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Elementary Data VS Lilac — Dados principais
Dados principaisElementary DataLilac
Pricing modelFreemiumFree
Product typeWebWeb
Primary focusObservabilidadeTreinamento de Modelo
Público e funçõesNão verificadoNão verificado
CategoriasObservabilidade · Gestão de Dados · AnáliseTreinamento de Modelo · Análise de Dados · Gestão de Dados
Added12 de ago. de 20256 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Elementary Data

O Elementary Data é uma plataforma de observabilidade de dados nativa do dbt, focada no desenvolvedor e confiada por milhares de engenheiros de dados e de análise. Foi projetada para operacionalizar a qualidade dos dados em todo o ciclo de vida dos dados, da detecção à resolução. Ao aproveitar agentes de IA, o Elementary automatiza tarefas manuais, permitindo que as equipes de dados se concentrem em atividades de alto impacto que impulsionam o valor do negócio. A plataforma aborda o desafio crítico da qualidade dos dados, que muitas vezes é o principal bloqueador para a implementação bem-sucedida de IA e a adoção de produtos de dados, garantindo que entradas ruins não levem a modelos quebrados ou decisões não confiáveis.

Como usar o Elementary Data

Começar a usar o Elementary Data é projetado para ser rápido e contínuo, especialmente para equipes que já usam o dbt. O processo normalmente envolve:

  1. Instalação: Instale o pacote dbt de código aberto do Elementary como um SDK em seu projeto dbt existente. Isso pode ser feito em minutos.
  2. Configuração: Configure seus ambientes e conecte suas fontes de dados. O Elementary requer apenas acesso de leitura a metadados e resultados de testes, não aos seus dados brutos, garantindo segurança e conformidade (certificado SOC-2 Tipo II).
  3. Monitoramento: Uma vez configurado, o Elementary começa a monitorar automaticamente seus pipelines de dados. Ele captura falhas de teste do dbt, detecta anomalias na atualização e no volume dos dados e coleta métricas de desempenho.
  4. Alerta e Triagem: Use a Plataforma Cloud do Elementary para gerenciar alertas. Você pode personalizar regras de roteamento para notificar as pessoas ou equipes certas via Slack ou outros canais. A plataforma fornece contexto, incluindo linhagem e proprietários, para ajudar a triar e resolver problemas mais rapidamente.
  5. Exploração e Governança: Utilize o catálogo de dados nativo para explorar esquemas, visualizar a linhagem em nível de coluna e entender a saúde dos dados. Agentes de IA podem auxiliar na descoberta de cobertura de testes e na triagem automatizada.

Recursos principais do Elementary Data

  • Agentes de IA (Ella): Automatize o trabalho manual, como triagem de incidentes, descoberta de cobertura de testes, otimização de desempenho e governança de dados para aumentar a eficiência.
  • Testes de Qualidade de Dados: Gerencie testes do dbt, testes nativos do Elementary e testes SQL personalizados a partir de uma única plataforma unificada.
  • Detecção Automatizada de Anomalias: Monitore proativamente os dados em busca de anomalias de atualização, volume e esquema sem configuração manual.
  • Linhagem de Dados de Ponta a Ponta: Visualize a linhagem em nível de coluna para entender as dependências de dados, rastrear problemas até sua origem e avaliar o impacto das mudanças.
  • Gerenciamento de Incidentes e Alertas: Reduza o ruído com alertas simplificados e ricos em contexto. Roteie notificações para os stakeholders certos e gerencie incidentes da detecção à resolução.
  • Pontuações de Saúde dos Dados: Obtenha uma visão geral rápida e de alto nível da qualidade e confiabilidade de seus dados em diferentes dimensões de qualidade.
  • Monitoramento de Desempenho e Custo: Identifique e resolva gargalos em seus pipelines de dados, acompanhe os tempos de execução e monitore as tendências de desempenho para otimizar os custos.
  • Catálogo de Dados Nativo: Uma alternativa enriquecida aos documentos do dbt, fornecendo um local centralizado para descoberta de dados, gerenciamento de metadados e compreensão dos ativos de dados.

Casos de uso para o Elementary Data

O Elementary Data é versátil e suporta várias iniciativas orientadas por dados. Por exemplo, uma empresa como a Flock Safety usou o Elementary para estabelecer um programa prático de governança de dados. Ao focar na qualidade e descoberta de dados, eles construíram confiança entre parceiros de negócios e engenheiros de análise. Isso levou a um aumento no consumo de dados, melhor colaboração e tomada de decisões mais confiável. Outros casos de uso incluem:

  • Prevenção de Alucinações de IA: Garantir entradas de dados de alta qualidade para modelos de IA e aprendizado de máquina para evitar saídas errôneas e construir sistemas confiáveis.
  • Redução da Fadiga de Alertas: Equipes de dados em empresas como a Hippo usam o Elementary para filtrar o ruído e receber alertas apenas para falhas reais de produção, eliminando o 'pesadelo' de notificações constantes e irrelevantes.
  • Melhoria da Confiança dos Stakeholders: Fornecer aos stakeholders uma visão diária clara da saúde dos dados, dando-lhes confiança na qualidade dos dados que usam para decisões.
  • Estabelecimento de Confiança nos Dados: Usar os recursos de teste, marcação e metadados do Elementary para criar um 'padrão ouro' de confiança nos ativos de dados.

Vantagens do Elementary Data

A principal vantagem do Elementary é sua integração profunda e nativa com o ecossistema dbt, tornando-o uma escolha natural para equipes de dados modernas. Sua abordagem focada no desenvolvedor garante que ele se encaixe perfeitamente nos fluxos de trabalho existentes. O uso de agentes de IA para automação reduz significativamente o esforço manual e melhora a eficiência da equipe. Além disso, sua cobertura abrangente de todo o ciclo de vida da qualidade dos dados — desde testes e monitoramento até a resolução de incidentes e governança — o torna uma solução completa. A plataforma é segura por design, nunca acessando dados brutos, e oferece tanto uma versão de código aberto poderosa quanto planos de nuvem escaláveis para empresas.

Preços e planos

O Elementary oferece um modelo de preços flexível baseado em assentos de usuário, com uma opção de código aberto gratuita e planos de nuvem pagos. Um teste gratuito de 30 dias do plano Essentials está disponível.

  • Código Aberto (OSS): Uma versão comunitária gratuita e auto-hospedada que milhares de equipes usam em produção.
  • Plano Starter: $650/mês. Inclui até 2 usuários, detecção e triagem de problemas de dados, detecção automatizada de anomalias, linhagem em nível de coluna e monitoramento de desempenho.
  • Plano Essentials: $1600/mês. Inclui tudo no Starter para até 8 usuários, além de recursos de colaboração, todos os agentes de IA, gerenciamento de incidentes, linhagem de ponta a ponta e suporte dedicado no Slack.
  • Plano Enterprise: Preço personalizado. Inclui tudo no Essentials com assentos flexíveis, segurança de nível empresarial (RBAC, SCIM), opções avançadas de implantação, SLAs de suporte premium e integrações com ferramentas como Jira e PagerDuty.

Lilac

Lilac é uma poderosa plataforma de código aberto projetada para revolucionar a forma como desenvolvedores e cientistas de dados interagem com dados para o desenvolvimento de modelos de IA. Construída com base no princípio "Melhores dados, melhor IA", a Lilac fornece um conjunto abrangente de ferramentas para pesquisar, quantificar e editar conjuntos de dados, especialmente aqueles usados para treinar e ajustar Modelos de Linguagem Grandes (LLMs). Ela aborda a necessidade crítica de dados de alta qualidade, tornando o processo de exploração, limpeza e curadoria de dados mais eficiente, intuitivo e escalável.

A plataforma é confiável por organizações líderes como a Alignment Lab AI e a NousResearch, capacitando as equipes a irem além de simples pesquisas por palavras-chave e a obterem uma compreensão profunda e conceitual de seus dados. Com seu motor de computação ultrarrápido, a Lilac pode processar conjuntos de dados massivos com uma velocidade notável, como agrupar um milhão de pontos de dados em apenas 20 minutos ou incorporar dados a uma taxa de meio bilhão de tokens por minuto. Esse desempenho a torna um componente crítico em qualquer pipeline sério de avaliação da qualidade dos dados.

Como usar Lilac

Começar a usar a Lilac é simples, especialmente para aqueles familiarizados com o ecossistema Python. O método principal de uso envolve uma instalação local e uma interface de usuário baseada na web para exploração.

  1. Instalação: Comece instalando a biblioteca Lilac usando o pip, o instalador de pacotes do Python. Abra seu terminal ou prompt de comando e execute o comando: pip install lilac.
  2. Iniciar a Lilac: Após a instalação, você pode iniciar o servidor Lilac a partir do seu terminal. Isso geralmente é feito executando um comando como lilac start [path_to_your_project_dir]. Este comando processará seus conjuntos de dados e iniciará um servidor web local.
  3. Carregar Dados: Aponte a Lilac para o seu conjunto de dados. Ela pode lidar com vários formatos e fontes de dados, permitindo que você importe dados de arquivos locais (CSV, JSON, etc.) ou diretamente de hubs como o Hugging Face.
  4. Explorar e Analisar: Assim que o servidor estiver em execução, abra a URL fornecida em seu navegador para acessar a UI da Lilac. Aqui, você pode usar seus recursos poderosos para explorar seus dados. Realize pesquisas semânticas, visualize clusters de dados e analise sinais como PII ou idioma.
  5. Curar e Editar: Use a interface para marcar, filtrar e até mesmo editar pontos de dados diretamente. Você pode criar novos rótulos, remover duplicatas ou limpar entradas ruidosas.
  6. Exportar e Utilizar: Após a curadoria do seu conjunto de dados, você pode exportar a versão melhorada ou os insights gerados (por exemplo, uma lista de IDs a serem removidos) para uso em seu pipeline de treinamento de modelo.

Recursos principais do Lilac

  • Busca Semântica e por Palavra-chave: Vá além da correspondência de texto básica. A Lilac permite que você pesquise seu conjunto de dados usando consultas em linguagem natural para encontrar entradas conceitualmente semelhantes, além da pesquisa tradicional por palavra-chave.
  • Clusterização Automática de Dados: A Lilac agrupa automaticamente pontos de dados semelhantes e atribui títulos a esses clusters, fornecendo uma visão geral instantânea de alto nível dos tópicos e temas presentes em seus dados.
  • Busca por Conceito Difuso: Pesquise por conceitos abstratos ou sutis que são difíceis de definir com palavras-chave específicas, permitindo uma segmentação e exploração de dados mais sofisticadas.
  • Sinais de Qualidade de Dados Integrados: A plataforma vem com sinais pré-construídos para detectar automaticamente Informações de Identificação Pessoal (PII), quase-duplicatas, complexidade do texto e o idioma do texto.
  • Criação de Sinais Personalizados: Os usuários podem estender as capacidades da Lilac definindo e executando seus próprios sinais e transformações personalizadas em seus conjuntos de dados, adaptando a análise às suas necessidades específicas.
  • Edição e Comparação de Dados: Edite campos de dados diretamente na UI e compare diferentes campos ou versões do seu conjunto de dados lado a lado para entender o impacto de suas alterações.
  • Motor de Alto Desempenho: Projetada para velocidade e escala, a Lilac pode lidar com conjuntos de dados com bilhões de tokens, tornando a curadoria de dados em larga escala viável.

Casos de uso para Lilac

A Lilac é uma ferramenta versátil aplicável em todo o ciclo de vida do desenvolvimento de IA:

  • Curadoria de Dados de Pré-treinamento: Analise e limpe conjuntos de dados massivos da web para remover conteúdo de baixa qualidade, duplicatas e PII antes de pré-treinar um modelo de fundação.
  • Melhoria de Conjuntos de Dados de Ajuste Fino: Para tarefas como o ajuste fino de instruções, use a Lilac para analisar a qualidade dos pares de instrução-resposta, identificar vieses e garantir a diversidade nos dados.
  • Avaliação e Depuração de Modelos: Descubra e analise fatias de dados específicas onde seu modelo tem um desempenho ruim. Ao agrupar e examinar casos de falha, você pode entender as fraquezas do modelo e direcioná-las com dados melhores.
  • Exploração e Compreensão de Dados: Obtenha rapidamente uma sensação qualitativa de qualquer novo conjunto de dados de texto. Entenda sua composição, identifique os principais tópicos e detecte problemas potenciais antes que qualquer código seja escrito.
  • Moderação de Conteúdo e Segurança: Use a busca semântica e sinais personalizados para identificar e marcar eficientemente conteúdo tóxico, prejudicial ou sensível dentro de um conjunto de dados.

Vantagens do Lilac

A Lilac oferece vantagens significativas para equipes que trabalham com LLMs:

  • Melhor Desempenho do Modelo: Ao melhorar sistematicamente a qualidade dos dados, a Lilac ajuda você a construir modelos de IA mais precisos, confiáveis e com menos viés.
  • Fluxo de Trabalho de Desenvolvimento Acelerado: Reduz drasticamente o tempo e o esforço manual necessários para a exploração e limpeza de dados, permitindo que as equipes iterem mais rapidamente.
  • Democratização de Insights de Dados: A UI intuitiva torna a análise profunda de conjuntos de dados acessível a todos os membros da equipe, incluindo gerentes de produto e especialistas de domínio, não apenas engenheiros de ML.
  • Código Aberto e Extensível: Ser gratuito e de código aberto promove a transparência, a colaboração da comunidade e permite a personalização completa para atender aos requisitos exclusivos do projeto.
  • Escalabilidade para Dados do Mundo Real: Sua arquitetura eficiente garante que você possa aplicar os mesmos processos rigorosos de qualidade de dados a conjuntos de dados pequenos e massivos em escala de produção.

Preços e planos

A Lilac é um projeto de código aberto, tornando sua biblioteca principal e interface de usuário completamente gratuitas para uso. Você pode instalá-la e executá-la em sua máquina local ou infraestrutura privada sem nenhum custo. O projeto é mantido por sua comunidade e contribuidores. Embora a ferramenta principal seja gratuita, pode haver ofertas futuras de nível empresarial, como o mencionado "Lilac Garden", que poderia fornecer serviços de nuvem gerenciados, suporte dedicado ou recursos avançados para uso comercial. No entanto, para desenvolvedores individuais, pesquisadores e a maioria das equipes, a versão de código aberto oferece funcionalidade completa.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
Gestão de Dados
Só Elementary Data
ObservabilidadeAnálise
Só Lilac
Treinamento de ModeloAnálise de Dados

Etiquetas

Em comum
qualidade de dados
Só Elementary Data
Agente de IAEngenharia de Analyticsdetecção de anomaliasCatálogo de dadosLinhagem de dadosMonitoramento de dadosObservabilidade de dadosdbt
Só Lilac
análise de dadosLimpeza de dadosexploração de dadosConjunto de dadosFerramentas de desenvolvedorModelo de Linguagem de Grande Escalaaprendizado de máquinaCódigo AbertoPesquisa semântica

Público e funções

Em comum
Sem dados verificados
Só Elementary Data
Sem dados verificados
Só Lilac
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Elementary Data monthly traffic:

Latest traffic · 2026-05

Visitas mensais
16K
Duração média
0:21
Páginas por visita
1.54
Taxa de rejeição
47.25%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: Não verificado
  • 2025-09: 18.7K
  • 2026-01: 17K
  • 2026-02: 16.9K
  • 2026-03: 18.3K
  • 2026-04: 12.1K
  • 2026-05: 16K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States48.18%7.7K
🇩🇪Germany25.01%4K
🇧🇷Brazil11.23%1.8K
🇮🇳India8.01%1.3K
🇫🇷France7.57%1.2K

Palavras-chave

dbt test accepted valuesdbt tests relationshipelementary dataelementary performance alertsnowflake summit

Lilac monthly traffic:

Latest traffic · 2026-05

Visitas mensais
16.7K
Duração média
1:00
Páginas por visita
1.12
Taxa de rejeição
80.5%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: 682
  • 2025-09: 504
  • 2026-01: Não verificado
  • 2026-02: 693
  • 2026-03: 0
  • 2026-04: 709
  • 2026-05: 16.7K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States100%16.7K

Palavras-chave

lilac data managementsportwetten ohne lugas

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Elementary Data

Avaliação
Não verificado
Comentários
0
Favoritos
153
Curtidas
162

Lilac

Avaliação
Não verificado
Comentários
0
Favoritos
170
Curtidas
175

Elementary Data vs Lilac · FAQ da comparação

What do Elementary Data and Lilac have in common?
Both tools are listed under Gestão de Dados. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Elementary Data and Lilac free?
Listed pricing models: Elementary Data — Freemium; Lilac — Free. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Elementary Data and Lilac?
The primary listed category is Observabilidade for Elementary Data, and Treinamento de Modelo for Lilac. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas