ToolMage
Entrar

AI TOOL COMPARISON

Neosync vs PostgresML

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

Neosync Visão geral

Neosync é uma plataforma de código aberto para anonimização de dados e geração de dados sintéticos. Ajuda desenvolvedores e cientistas de dados a criar conjuntos de dados seguros, em conformidade com a privacidade e realistas para testes, desenvolvimento e treinamento de modelos de IA, garantindo a integridade referencial entre bancos de dados.

Preview

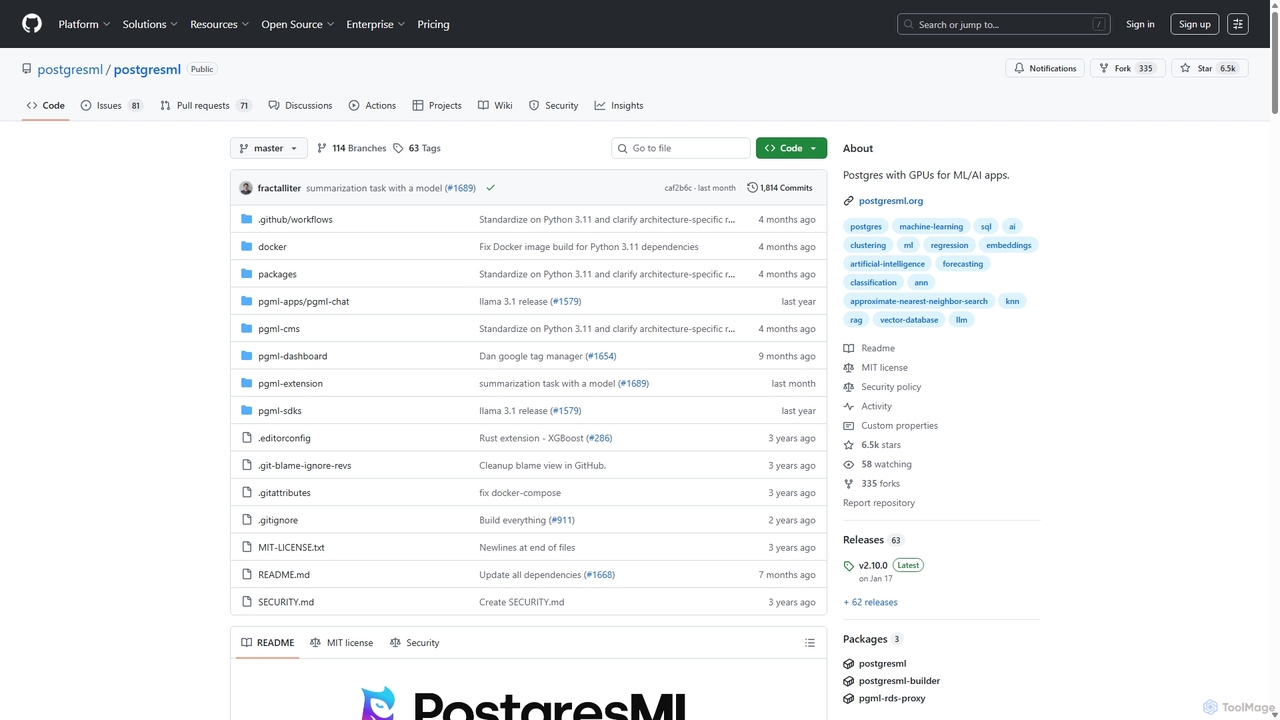
PostgresML Visão geral

PostgresML é uma poderosa extensão de código aberto que integra machine learning e IA diretamente no seu banco de dados PostgreSQL. Ele permite inferência acelerada por GPU, busca vetorial e pipelines RAG completos usando comandos SQL simples, eliminando a movimentação de dados e simplificando a pilha de MLOps para aplicações de IA escaláveis e de alto desempenho.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Neosync VS PostgresML — Dados principais
Dados principaisNeosyncPostgresML
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusGeração de DadosMLOps
Público e funçõesAnalista de Dados · Administrador de Banco de Dados · Cientista de Dados · Engenheiro de DevOps · Engenheiro de Machine Learning · Gerente de Produto · Analista de Segurança · Desenvolvedor de SoftwareDesenvolvedor de Aplicações de IA · Engenheiro de Backend · Analista de Dados · Administrador de Banco de Dados · Cientista de Dados · Engenheiro de Machine Learning · Gerente de Produto · Desenvolvedor de Software
CategoriasGeração de Dados · Banco de Dados · PrivacidadeMLOps · Banco de Dados Vetorial · Banco de Dados
Added2 de out. de 20251 de set. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Neosync

Neosync é uma ferramenta poderosa de código aberto projetada para enfrentar os desafios críticos de privacidade e utilidade de dados enfrentados pelas equipes de desenvolvimento modernas. Ela se especializa em duas áreas principais: anonimização de dados e geração de dados sintéticos. Ao transformar dados de produção sensíveis em versões seguras e desidentificadas, o Neosync permite que os desenvolvedores trabalhem com conjuntos de dados realistas em ambientes locais e de homologação sem arriscar violações de dados ou violar regulamentações de privacidade como GDPR, HIPAA e CCPA.

A plataforma foi construída com os desenvolvedores em mente, oferecendo integração perfeita com os fluxos de trabalho existentes. Pode se conectar a várias fontes de dados, principalmente bancos de dados relacionais como PostgreSQL e MySQL, e permite que os usuários definam regras para transformar dados, preservando sua integridade estrutural e estatística. Isso significa que os relacionamentos entre tabelas (chaves estrangeiras) são mantidos, garantindo que os dados anonimizados ou sintéticos se comportem como os dados reais, o que é crucial para testes precisos e desenvolvimento de aplicativos confiáveis.

Como usar o Neosync

O uso do Neosync normalmente segue um fluxo de trabalho estruturado e centrado no desenvolvedor:

  1. Conectar a uma Fonte de Dados: Comece configurando o Neosync para se conectar ao seu banco de dados de produção ou de origem (por exemplo, PostgreSQL, MySQL). Isso geralmente é feito por meio de um arquivo de configuração ou de uma interface de usuário.
  2. Definir Tarefas de Transformação de Dados: Crie uma tarefa para especificar como os dados devem ser tratados. Você identificará as tabelas e colunas que deseja incluir.
  3. Configurar Regras de Anonimização: Para cada coluna sensível (por exemplo, nomes, e-mails, números de telefone, números de segurança social), você seleciona um 'Transformador'. O Neosync fornece uma biblioteca de transformadores pré-construídos (por exemplo, gerador de string aleatória, mascarador de e-mail, randomizador de endereço) para substituir dados reais por dados realistas, mas falsos.
  4. Gerar Dados Sintéticos: Se precisar criar dados do zero, você pode definir um esquema e usar o Neosync para preenchê-lo com grandes volumes de dados estatisticamente sólidos e com integridade referencial. Isso é ideal para testes de carga ou treinamento de modelos de ML sem dados reais.
  5. Manter a Integridade Referencial: O Neosync lida automaticamente com relacionamentos de chave estrangeira, garantindo que, se você anonimizar um ID de usuário em uma tabela, todos os registros correspondentes em outras tabelas sejam atualizados de forma consistente.
  6. Executar e Sincronizar: Execute a tarefa para processar os dados e sincronize o conjunto de dados seguro resultante para um destino de sua escolha, como um banco de dados de desenvolvedor local, um ambiente de homologação ou um bucket de armazenamento em nuvem.

Recursos principais do Neosync

  • Anonimização de Dados: Um rico conjunto de transformadores de dados para mascarar, substituir ou gerar dados falsos para vários tipos de dados, removendo efetivamente Informações de Identificação Pessoal (PII).
  • Geração de Dados Sintéticos: Capacidade de criar conjuntos de dados sintéticos de grande escala e alta fidelidade que espelham as propriedades estatísticas e o esquema de seus dados de produção.
  • Preservação da Integridade Referencial: Mantém inteligentemente os relacionamentos entre tabelas e bancos de dados, evitando links quebrados e garantindo a consistência dos dados.
  • Subconjunto de Dados: Crie subconjuntos menores, direcionados e totalmente funcionais do seu banco de dados de produção, acelerando os ciclos de desenvolvimento e teste.
  • Código Aberto e Extensível: Como um projeto de código aberto, oferece transparência, suporte da comunidade e a capacidade de criar transformadores personalizados para atender a necessidades específicas.
  • Compatibilidade com Bancos de Dados: Suporta nativamente bancos de dados populares como PostgreSQL e MySQL, com uma lista crescente de integrações.

Casos de uso para o Neosync

O Neosync é inestimável para uma variedade de cenários:

  • Desenvolvimento e Teste Local: Fornece aos desenvolvedores dados seguros e semelhantes à produção em suas máquinas locais, eliminando os riscos de segurança associados ao uso de dados reais de produção.
  • Pipelines de CI/CD: Automatize a criação de dados novos e anonimizados para cada execução de teste em seus pipelines de integração e implantação contínuas.
  • IA e Machine Learning: Treine modelos de ML em grandes conjuntos de dados realistas sem comprometer a privacidade do usuário.
  • Demos de Vendas e Apresentações: Crie demonstrações de produtos atraentes com dados de aparência realista que não contêm informações confidenciais de clientes.
  • Compartilhamento de Dados com Terceiros: Compartilhe dados com segurança com parceiros ou pesquisadores, anonimizando primeiro todas as informações sensíveis.
  • Conformidade Regulatória: Ajuda as organizações a atender aos requisitos de leis de privacidade como GDPR, HIPAA e CCPA, desidentificando os dados usados em ambientes de não produção.

Vantagens do Neosync

O Neosync oferece várias vantagens importantes:

  • Segurança e Privacidade Aprimoradas: Reduz drasticamente o risco de violações de dados, removendo dados sensíveis dos ambientes de desenvolvimento e teste.
  • Aumento da Velocidade do Desenvolvedor: Acelera os ciclos de desenvolvimento, fornecendo acesso instantâneo a dados seguros e realistas, eliminando gargalos relacionados a dados.
  • Dados de Alta Fidelidade: O foco na integridade referencial e na preservação estatística garante que os dados de teste sejam um reflexo fiel dos dados de produção, levando a menos bugs.
  • Custo-Efetivo: O modelo de código aberto o torna uma solução acessível para equipes de todos os tamanhos, com opções de suporte empresarial e serviços gerenciados.
  • Flexibilidade: Pode ser auto-hospedado e personalizado para se adequar a estruturas de dados e requisitos de segurança exclusivos.

Preços e planos

O Neosync opera em um modelo freemium. A plataforma principal é de código aberto e de uso gratuito, permitindo que qualquer pessoa auto-hospede e aproveite suas capacidades de anonimização e síntese de dados. Para organizações que exigem recursos mais avançados, serviços gerenciados ou suporte dedicado, o Neosync normalmente oferece planos empresariais ou em nuvem pagos. Esses planos geralmente incluem recursos como controle de acesso baseado em função, suporte prioritário e infraestrutura gerenciada.

PostgresML

PostgresML é uma extensão de código aberto transformadora que traz capacidades de machine learning e IA diretamente para o banco de dados PostgreSQL. Ao incorporar modelos e algoritmos na camada de dados, ele muda fundamentalmente a forma como as aplicações de IA são construídas. A filosofia central é que é mais eficiente, gerenciável e confiável mover os modelos para os dados, em vez de mover constantemente grandes e dinâmicos conjuntos de dados para os modelos. Essa abordagem elimina pipelines de dados complexos, reduz a latência e aumenta a segurança.

PostgresML transforma seu banco de dados existente em uma plataforma de IA completa. Ele suporta uma ampla gama de funcionalidades, desde modelos de machine learning tradicionais como classificação e regressão até aplicações de deep learning de ponta envolvendo Modelos de Linguagem Grandes (LLMs) e busca vetorial. Ao aproveitar o poder das GPUs, ele acelera os cálculos e a inferência de modelos, tornando a IA em tempo real viável para sistemas de alto throughput.

Como usar o PostgresML

Começar a usar o PostgresML é projetado para ser simples, com opções para ambientes em nuvem e auto-hospedados.

  1. PostgresML Cloud (Recomendado): A maneira mais fácil de começar é se inscrevendo para uma conta gratuita na Nuvem PostgresML. Isso fornece um banco de dados PostgreSQL sem servidor e totalmente gerenciado em segundos, completo com acesso a GPUs e LLMs de última geração, sem qualquer sobrecarga de configuração.
  2. Auto-hospedagem: Para usuários que preferem gerenciar sua própria infraestrutura, o PostgresML pode ser auto-hospedado usando o Docker. Você pode baixar a imagem oficial e executá-la com um comando simples, dando a você controle total sobre seu ambiente. O comando é tipicamente: docker run -it -v postgresml_data:/var/lib/postgresql -p 5433:5432 -p 8000:8000 ghcr.io/postgresml/postgresml:latest.
  3. Executando Consultas: Uma vez configurado, você interage com o PostgresML usando SQL padrão. Você pode treinar modelos (ex: pgml.train()), fazer previsões (ex: pgml.predict()) e executar pipelines de IA complexos. Por exemplo, gerar embeddings de texto é tão simples quanto chamar a função pgml.embed() em uma coluna de texto.
  4. Usando SDKs: Para uma integração de aplicação perfeita, o PostgresML oferece bibliotecas de cliente específicas como Korvus (para Python, JavaScript, Rust e C) e postgresml-django, que integram todo o pipeline RAG em uma única consulta de banco de dados ou operação ORM.

Recursos principais do PostgresML

  • ML/IA no Banco de Dados: Execute operações de machine learning e IA diretamente no PostgreSQL, eliminando a necessidade de sistemas separados e transferências de dados.
  • Aceleração por GPU: Aproveita o poder da GPU para cálculos e inferência de modelos significativamente mais rápidos, crucial para aplicações em tempo real.
  • Modelos de Linguagem Grandes (LLMs): Integra e utiliza LLMs de ponta de hubs como o Hugging Face diretamente em seu banco de dados.
  • Pipeline RAG de ponta a ponta: Fornece funções SQL integradas para todo o fluxo de trabalho de Geração Aumentada por Recuperação (RAG): pgml.chunk para divisão de texto, pgml.embed para gerar embeddings vetoriais, pgml.rank para reclassificar resultados e pgml.transform para geração de texto.
  • Busca Vetorial: Integra-se perfeitamente com o pgvector para busca de similaridade de vetores de alta dimensão eficiente e escalável.
  • Diversos Algoritmos de ML: Inclui mais de 47 algoritmos de classificação e regressão integrados (como XGBoost) para tarefas de machine learning tradicionais.
  • Alto Desempenho e Escalabilidade: Oferece inferência de 8 a 40 vezes mais rápida em comparação com o serviço de modelos baseado em HTTP e é projetado para suportar milhões de transações por segundo com escalonamento horizontal.
  • Tarefas Abrangentes de PNL: Suporta uma ampla gama de tarefas de processamento de linguagem natural, incluindo classificação de texto, sumarização, tradução, resposta a perguntas e geração de texto.

Casos de uso para PostgresML

O PostgresML é ideal para desenvolvedores e cientistas de dados que constroem uma nova geração de aplicações alimentadas por IA.

  • Busca Semântica e Motores de Recomendação: Construa sistemas de busca poderosos que entendem a intenção do usuário usando embeddings vetoriais para encontrar itens semanticamente semelhantes.
  • Chatbots e Sistemas de Q&A com IA: Implemente pipelines RAG sofisticados para construir chatbots que podem responder a perguntas com base em uma base de conhecimento privada armazenada no banco de dados.
  • Detecção de Fraude em Tempo Real: Treine e implante modelos de classificação diretamente no banco de dados para analisar dados de transações em tempo real e sinalizar atividades suspeitas com baixa latência.
  • Análise de Dados e Business Intelligence: Use PNL no banco de dados para resumir avaliações de clientes, classificar tickets de suporte ou extrair insights de dados de texto não estruturados sem nunca movê-los para fora do Postgres.
  • Geração de Conteúdo Personalizado: Aproveite os LLMs para gerar textos de marketing personalizados, descrições de produtos ou respostas de e-mail com base nos dados do usuário armazenados no banco de dados.

Vantagens do PostgresML

A principal vantagem do PostgresML é sua simplicidade arquitetônica e eficiência.

  • Latência Reduzida: Ao colocar modelos e dados no mesmo local, elimina a sobrecarga de rede, levando a um desempenho de consulta mais rápido.
  • Segurança e Privacidade Aprimoradas: Os dados permanecem dentro dos limites seguros do seu banco de dados, simplificando a conformidade e reduzindo o risco de violações de dados.
  • Pilha de MLOps Simplificada: Consolida o armazenamento de dados, o serviço de modelos e o banco de dados vetorial em um único sistema, reduzindo a complexidade da infraestrutura e os custos operacionais.
  • Experiência do Desenvolvedor: Permite que os desenvolvedores usem o SQL familiar para construir e implantar recursos complexos de IA, diminuindo a barreira de entrada e acelerando os ciclos de desenvolvimento.
  • Escalabilidade: Construído sobre a base robusta e escalável do PostgreSQL, pode lidar com cargas de trabalho de nível empresarial.

Preços e planos

O PostgresML opera em um modelo freemium, oferecendo flexibilidade para diferentes necessidades.

  • Auto-hospedagem de Código Aberto: A extensão PostgresML é de código aberto (licença MIT) e pode ser auto-hospedada gratuitamente, dando a você controle total sobre seu ambiente.
  • PostgresML Cloud: Uma plataforma em nuvem gerenciada e sem servidor está disponível. Inclui um generoso nível gratuito que permite aos desenvolvedores começar rapidamente com um banco de dados gratuito, acesso a GPU e LLMs pré-configurados. Planos pagos estão disponíveis para aplicações que exigem mais recursos, GPUs dedicadas e suporte de nível empresarial.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
Banco de Dados
Só Neosync
Geração de DadosPrivacidade
Só PostgresML
MLOpsBanco de Dados Vetorial

Etiquetas

Em comum
banco de dadosCódigo Aberto
Só Neosync
anonimização de dadosmascaramento de dadosFerramentas de desenvolvedorGDPRHIPAADados Pessoais IdentificáveisPrivacidadeSegurançadados sintéticosdados de teste
Só PostgresML
Infraestrutura de IAIncorporaçõesGPUModelo de Linguagem de Grande Escalaaprendizado de máquinaMLOpsNLPPostgreSQLGeração Aumentada por RecuperaçãoSQLBanco de dados vetorial

Público e funções

Em comum
Analista de DadosAdministrador de Banco de DadosCientista de DadosEngenheiro de Machine LearningGerente de ProdutoDesenvolvedor de Software
Só Neosync
Engenheiro de DevOpsAnalista de Segurança
Só PostgresML
Desenvolvedor de Aplicações de IAEngenheiro de Backend

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Neosync

Não verificado

PostgresML

Não verificado

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Neosync

Avaliação
Não verificado
Comentários
0
Favoritos
166
Curtidas
155

PostgresML

Avaliação
Não verificado
Comentários
0
Favoritos
183
Curtidas
167

Neosync vs PostgresML · FAQ da comparação

What do Neosync and PostgresML have in common?
Both tools are listed under Banco de Dados. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Neosync and PostgresML free?
Listed pricing models: Neosync — Freemium; PostgresML — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Neosync and PostgresML?
The primary listed category is Geração de Dados for Neosync, and MLOps for PostgresML. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas