ToolMage
Đăng nhập

Best 1 Xử lý dữ liệu AI tools for Công cụ dành cho nhà phát triển

Popular Xử lý dữ liệu AI tools in Công cụ dành cho nhà phát triển include JSON Formatter, helping you work more efficiently.

JSON Formatter
Free

JSON Formatter

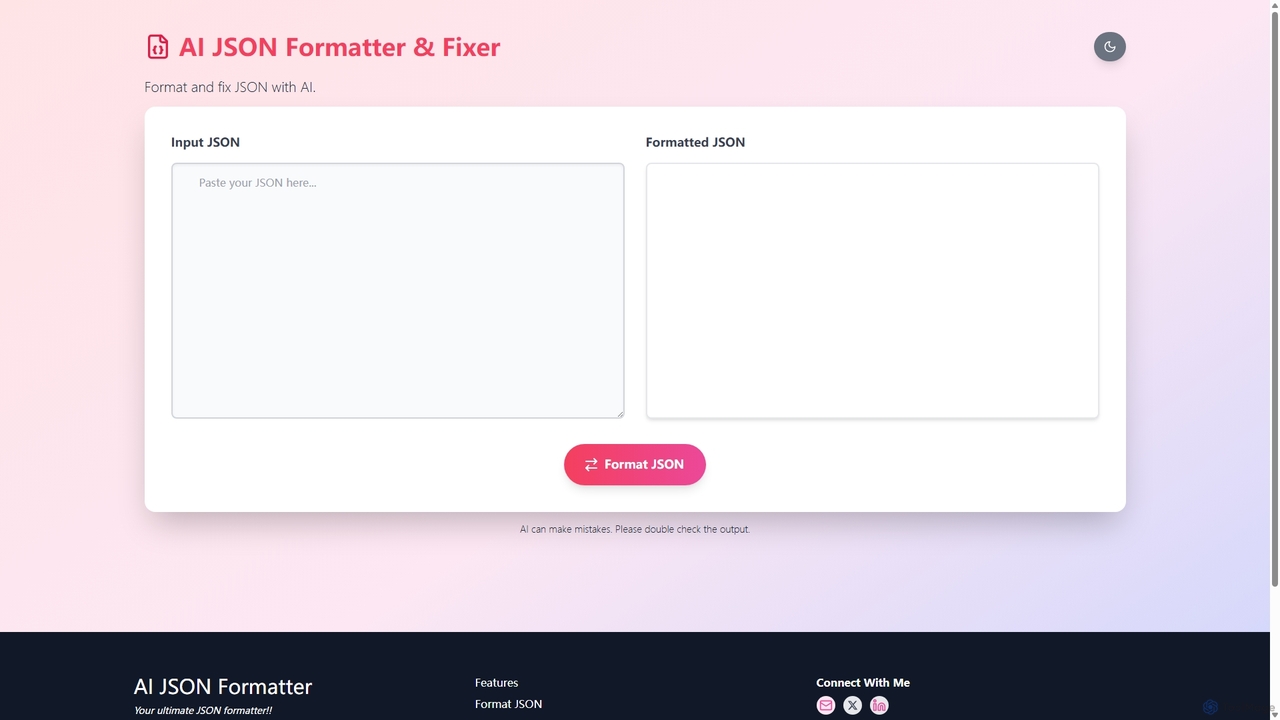
Một công cụ trực tuyến được hỗ trợ bởi AI để định dạng, xác thực và sửa dữ liệu JSON. Nó cung cấp định dạng tức thì, sửa lỗi thông minh và khả năng tải tệp lên, trở thành công cụ thiết yếu cho các nhà phát triển để gỡ lỗi và quản lý JSON hiệu quả.

Trợ lý mã
Visits 9.8KFavorites 165Likes 151

About Xử lý dữ liệu

Công cụ Xử lý dữ liệu AI là một danh mục chuyên biệt gồm các tiện ích dành cho nhà phát triển, được thiết kế để tự động hóa và hợp lý hóa việc xử lý các tập dữ liệu phức tạp. Chúng tận dụng các thuật toán học máy cho các tác vụ như làm sạch, chuyển đổi, kỹ thuật đặc trưng và xác thực dữ liệu, tạo thành một phần quan trọng của vòng đời MLOps. Những công cụ này rất cần thiết để chuẩn bị dữ liệu chất lượng cao cho các mô hình học máy, tăng tốc chu kỳ phát triển và đảm bảo tính toàn vẹn của dữ liệu trong các ứng dụng do AI điều khiển. Bằng cách xác định các mẫu và sự bất thường một cách thông minh, chúng giúp giảm đáng kể công sức thủ công thường cần thiết trong quá trình chuẩn bị dữ liệu.

Tính năng Cốt lõi

  • Làm sạch dữ liệu tự động: Nhận dạng và sửa chữa một cách thông minh các lỗi, sự không nhất quán và các giá trị bị thiếu trong tập dữ liệu.
  • Chuyển đổi dữ liệu thông minh: Chuyển đổi định dạng dữ liệu, chuẩn hóa giá trị và mã hóa các biến phân loại dựa trên ngữ cảnh dữ liệu.
  • Kỹ thuật đặc trưng bằng AI: Tự động tạo và chọn các đặc trưng liên quan từ dữ liệu thô để cải thiện hiệu suất mô hình học máy.
  • Phát hiện bất thường: Sử dụng các mô hình AI để phát hiện các điểm ngoại lai và các mẫu bất thường có thể chỉ ra các vấn đề về chất lượng dữ liệu hoặc các sự kiện quan trọng.
  • Tạo dữ liệu tổng hợp: Tạo ra các tập dữ liệu nhân tạo, có tính đại diện thống kê để thử nghiệm, đào tạo và bảo vệ quyền riêng tư.

Trường hợp sử dụng

Các công cụ này chủ yếu được sử dụng bởi các nhà khoa học dữ liệu, kỹ sư học máy và kỹ sư dữ liệu. Các kịch bản phổ biến bao gồm chuẩn bị dữ liệu huấn luyện cho một mô hình dự đoán mới, xây dựng các đường ống dữ liệu mạnh mẽ và có khả năng thích ứng cho các ứng dụng thời gian thực, hoặc làm sạch dữ liệu văn bản phi cấu trúc quy mô lớn cho các tác vụ xử lý ngôn ngữ tự nhiên (NLP).

Cách chọn

Khi chọn một công cụ Xử lý dữ liệu AI, hãy xem xét khả năng tương thích với nguồn dữ liệu (cơ sở dữ liệu, API, định dạng tệp), khả năng mở rộng để xử lý khối lượng dữ liệu của bạn và khả năng tích hợp với hệ sinh thái MLOps hiện có của bạn (ví dụ: TensorFlow, PyTorch, nền tảng đám mây). Đồng thời, hãy đánh giá mức độ tự động hóa so với nhu cầu xác định quy tắc tùy chỉnh để đảm bảo nó phù hợp với quy trình làm việc và chuyên môn kỹ thuật của nhóm bạn.

Xử lý dữ liệu use cases

1

Chuẩn bị Dữ liệu Huấn luyện cho Mô hình Học máy

Một Kỹ sư Học máy được giao nhiệm vụ xây dựng một mô hình phát hiện gian lận. Dữ liệu giao dịch thô không nhất quán, có các giá trị bị thiếu, định dạng tiền tệ khác nhau và các trường văn bản bị nhiễu. Sử dụng công cụ Xử lý dữ liệu AI, kỹ sư tự động hóa quy trình điền các giá trị bị thiếu dựa trên các mẫu thống kê, chuẩn hóa tất cả các giá trị tiền tệ về một loại tiền tệ duy nhất và làm sạch các mô tả văn bản. Công cụ này cũng đề xuất và tạo ra các đặc trưng mới, chẳng hạn như 'tần suất giao dịch mỗi giờ'. Điều này tạo ra một tập dữ liệu sạch, chất lượng cao trong vài giờ thay vì vài ngày, cải thiện đáng kể độ chính xác của mô hình cuối cùng và giảm hơn 80% công sức tiền xử lý thủ công.

2

Tự động hóa các Đường ống Dữ liệu có khả năng phục hồi

Một Kỹ sư Dữ liệu chịu trách nhiệm duy trì một đường ống ETL/ELT để nhập dữ liệu từ các API của bên thứ ba vào kho dữ liệu. Các API này thường xuyên có sự thay đổi về lược đồ hoặc cung cấp dữ liệu với các định dạng không mong muốn. Thay vì viết các kịch bản dựa trên quy tắc dễ bị lỗi, kỹ sư triển khai một công cụ Xử lý dữ liệu AI. Công cụ này tự động phát hiện các thay đổi về lược đồ, điều chỉnh logic chuyển đổi một cách linh hoạt và sử dụng tính năng phát hiện bất thường để cách ly dữ liệu xấu trước khi nó làm ô nhiễm kho dữ liệu. Điều này tạo ra một đường ống có khả năng phục hồi cao hơn, tự sửa chữa, đòi hỏi ít sự can thiệp thủ công hơn đáng kể và đảm bảo độ tin cậy dữ liệu cao hơn cho các phân tích sau này.

3

Làm sạch Văn bản phi cấu trúc để Phân tích NLP

Một nhà khoa học dữ liệu cần phân tích hàng nghìn bài đánh giá của khách hàng để trích xuất tình cảm và các chủ đề chính. Văn bản thô chứa đầy lỗi chính tả, tiếng lóng và các thẻ HTML không liên quan. Việc làm sạch dữ liệu này theo cách thủ công sẽ cực kỳ tốn thời gian. Bằng cách sử dụng công cụ Xử lý dữ liệu AI, họ áp dụng các mô hình được xây dựng sẵn cho các tác vụ như sửa lỗi chính tả, loại bỏ từ dừng và nhận dạng thực thể có tên. Công cụ này xử lý toàn bộ kho ngữ liệu đánh giá, cho ra văn bản sạch, có cấu trúc, sẵn sàng để đưa vào mô hình phân tích tình cảm. Điều này giúp rút ngắn tiến độ dự án từ vài tuần xuống còn vài ngày và cải thiện độ chính xác của các thông tin chiết xuất từ NLP.

4

Tạo Dữ liệu Tổng hợp để Kiểm thử Tuân thủ Quyền riêng tư

Một nhóm phát triển tại một công ty công nghệ y tế cần kiểm thử phần mềm quản lý bệnh nhân mới của họ. Việc sử dụng dữ liệu bệnh nhân thực không phải là một lựa chọn do các quy định nghiêm ngặt về quyền riêng tư như HIPAA. Nhóm sử dụng một công cụ Xử lý dữ liệu AI có khả năng tạo dữ liệu tổng hợp. Họ cung cấp cho công cụ lược đồ và các thuộc tính thống kê của dữ liệu thực. Sau đó, công cụ này tạo ra một tập dữ liệu hồ sơ bệnh nhân nhân tạo lớn, bắt chước các phân phối và mối quan hệ trong thế giới thực mà không chứa bất kỳ thông tin cá nhân thực tế nào. Điều này cho phép nhóm QA thực hiện kiểm thử quy mô lớn, mạnh mẽ trong khi vẫn tuân thủ đầy đủ các luật về quyền riêng tư.

5

Chuẩn hóa Dữ liệu Sản phẩm Thương mại điện tử không đồng nhất

Một nhà phân tích dữ liệu thương mại điện tử cần hợp nhất danh mục sản phẩm từ nhiều nhà cung cấp. Mỗi nhà cung cấp cung cấp dữ liệu ở các định dạng khác nhau, với quy ước đặt tên không nhất quán (ví dụ: 'Color' so với 'Colour') và cấu trúc thuộc tính đa dạng. Sử dụng công cụ Xử lý dữ liệu AI, nhà phân tích có thể ánh xạ và chuẩn hóa các trường không đồng nhất này một cách thông minh. AI của công cụ nhận dạng các điểm tương đồng về ngữ nghĩa để hợp nhất các thuộc tính một cách chính xác và sử dụng các thuật toán phân cụm để nhóm các sản phẩm tương tự, xác định các sản phẩm có khả năng trùng lặp. Quá trình này tạo ra một danh mục sản phẩm chính thống nhất, sạch sẽ, giúp cải thiện trực tiếp độ chính xác của tìm kiếm trên trang web và nâng cao trải nghiệm duyệt web của khách hàng.

6

Xác thực Luồng dữ liệu Cảm biến IoT thời gian thực

Một nhà phát triển IoT đang xây dựng một hệ thống bảo trì dự đoán cho máy móc công nghiệp, dựa trên một luồng dữ liệu cảm biến liên tục (nhiệt độ, độ rung, áp suất). Dữ liệu này có thể bị nhiễu hoặc chứa các kết quả đọc sai do cảm biến hoạt động sai. Một công cụ Xử lý dữ liệu AI được triển khai trong luồng dữ liệu để thực hiện xác thực thời gian thực. Nó sử dụng các mô hình đã được huấn luyện để xác định các kết quả đọc bất thường nằm ngoài phạm vi hoặc mẫu hoạt động dự kiến. Công cụ có thể tự động gắn cờ, lọc hoặc thậm chí sửa các điểm ngoại lai này trước khi chúng được đưa vào mô hình dự đoán, ngăn chặn các cảnh báo sai và đảm bảo độ tin cậy của các cảnh báo bảo trì.

Xử lý dữ liệu FAQ

Công cụ Xử lý dữ liệu AI là gì?

Công cụ Xử lý dữ liệu AI là phần mềm chuyên dụng dành cho nhà phát triển, sử dụng trí tuệ nhân tạo để tự động hóa và tăng cường các tác vụ chuẩn bị dữ liệu. Không giống như các kịch bản truyền thống hoặc công cụ ETL dựa trên các quy tắc rõ ràng, những công cụ này có thể học các mẫu dữ liệu để làm sạch, chuyển đổi, xác thực và thậm chí tạo ra các đặc trưng từ các tập dữ liệu phức tạp một cách thông minh. Chúng được thiết kế để tăng tốc phần tốn thời gian nhất trong quy trình làm việc của học máy: chuẩn bị dữ liệu chất lượng cao.

Công cụ Xử lý dữ liệu AI khác với công cụ ETL truyền thống như thế nào?

Sự khác biệt chính nằm ở trí thông minh và khả năng thích ứng. Các công cụ ETL (Trích xuất, Chuyển đổi, Tải) truyền thống hoạt động dựa trên các quy tắc cứng nhắc, được xác định trước bởi nhà phát triển. Nếu định dạng dữ liệu thay đổi, các quy tắc sẽ bị hỏng. Các công cụ Xử lý dữ liệu AI linh hoạt hơn. Chúng sử dụng học máy để:

  • Suy luận quy tắc: Tự động đề xuất các phép biến đổi dựa trên nội dung dữ liệu.
  • Thích ứng với sự thay đổi: Xử lý các thay đổi trong lược đồ hoặc mẫu dữ liệu mà không cần can thiệp thủ công.
  • Phát hiện các bất thường tinh vi: Tìm ra các điểm ngoại lai phức tạp mà các hệ thống dựa trên quy tắc đơn giản sẽ bỏ lỡ.
  • Tự động hóa kỹ thuật đặc trưng: Tạo ra các biến dự đoán mới, một nhiệm vụ vượt quá phạm vi của hầu hết các công cụ ETL.
Về cơ bản, chúng chuyển từ phương pháp tiếp cận dựa trên mệnh lệnh sang phương pháp dựa trên học hỏi, giảm thiểu việc bảo trì thủ công.

Ai là người dùng chính của các công cụ Xử lý dữ liệu AI?

Người dùng chính là các chuyên gia kỹ thuật làm việc trực tiếp với dữ liệu để xây dựng các ứng dụng hoặc mô hình. Điều này bao gồm:

  • Nhà khoa học dữ liệu: Để làm sạch dữ liệu và thực hiện kỹ thuật đặc trưng nhằm cải thiện độ chính xác của mô hình.
  • Kỹ sư Học máy: Để tạo ra các đường ống dữ liệu tự động, mạnh mẽ như một phần của thực tiễn MLOps.
  • Kỹ sư dữ liệu: Để xây dựng các quy trình ETL/ELT có khả năng phục hồi và thích ứng, đòi hỏi ít công sức bảo trì hơn.
  • Nhà phát triển phần mềm: Để tạo dữ liệu tổng hợp cho việc kiểm thử hoặc xử lý các xác thực dữ liệu phức tạp trong ứng dụng.
Những công cụ này thường không được thiết kế cho các nhà phân tích kinh doanh không chuyên về kỹ thuật, vì chúng thường đòi hỏi sự hiểu biết nhất định về cấu trúc dữ liệu và quy trình phát triển.

Làm cách nào để chọn công cụ Xử lý dữ liệu AI phù hợp?

Việc chọn công cụ phù hợp phụ thuộc vào nhu cầu cụ thể của bạn. Hãy xem xét các yếu tố chính sau:

  • Nguồn và Định dạng Dữ liệu: Đảm bảo công cụ có các trình kết nối cho cơ sở dữ liệu, API của bạn và hỗ trợ các loại tệp bạn sử dụng (ví dụ: Parquet, JSON, CSV).
  • Khả năng mở rộng: Công cụ có thể xử lý khối lượng và tốc độ dữ liệu của bạn không? Kiểm tra xem nó có hỗ trợ xử lý phân tán (như Spark) không.
  • Tích hợp: Nó phù hợp với hệ sinh thái nhà phát triển hiện tại của bạn đến mức nào? Tìm kiếm các tích hợp với các nền tảng MLOps, dịch vụ đám mây (AWS, GCP, Azure) và kho mã nguồn.
  • Trọng tâm Trường hợp sử dụng: Một số công cụ vượt trội trong việc xử lý văn bản phi cấu trúc, trong khi những công cụ khác lại tốt hơn cho dữ liệu dạng bảng hoặc tạo dữ liệu tổng hợp. Hãy đối chiếu thế mạnh của công cụ với nhiệm vụ chính của bạn.
Hãy bắt đầu bằng cách đánh giá các công cụ dựa trên một nhiệm vụ chuẩn bị dữ liệu cụ thể, mang tính đại diện từ một trong các dự án của bạn.

Công cụ Xử lý dữ liệu AI có thể làm việc với dữ liệu phi cấu trúc như văn bản và hình ảnh không?

Có, nhiều công cụ Xử lý dữ liệu AI tiên tiến được thiết kế đặc biệt để xử lý dữ liệu phi cấu trúc hoặc bán cấu trúc. Đối với văn bản, chúng cung cấp các tính năng như làm sạch dựa trên NLP (sửa lỗi chính tả, loại bỏ từ dừng), nhận dạng thực thể và mô hình hóa chủ đề. Đối với hình ảnh, chúng có thể hỗ trợ các tác vụ như gắn thẻ tự động, thay đổi kích thước hoặc xác định các vấn đề về chất lượng (ví dụ: độ mờ). Khả năng này là một lợi thế đáng kể so với các công cụ dữ liệu truyền thống thường bị giới hạn ở dữ liệu có cấu trúc, dạng bảng. Khi chọn một công cụ, hãy xác minh các khả năng cụ thể của nó đối với loại dữ liệu phi cấu trúc mà bạn làm việc.