Elementary Data
Khả năng quan sát
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Khả năng quan sát
Huấn luyện mô hình
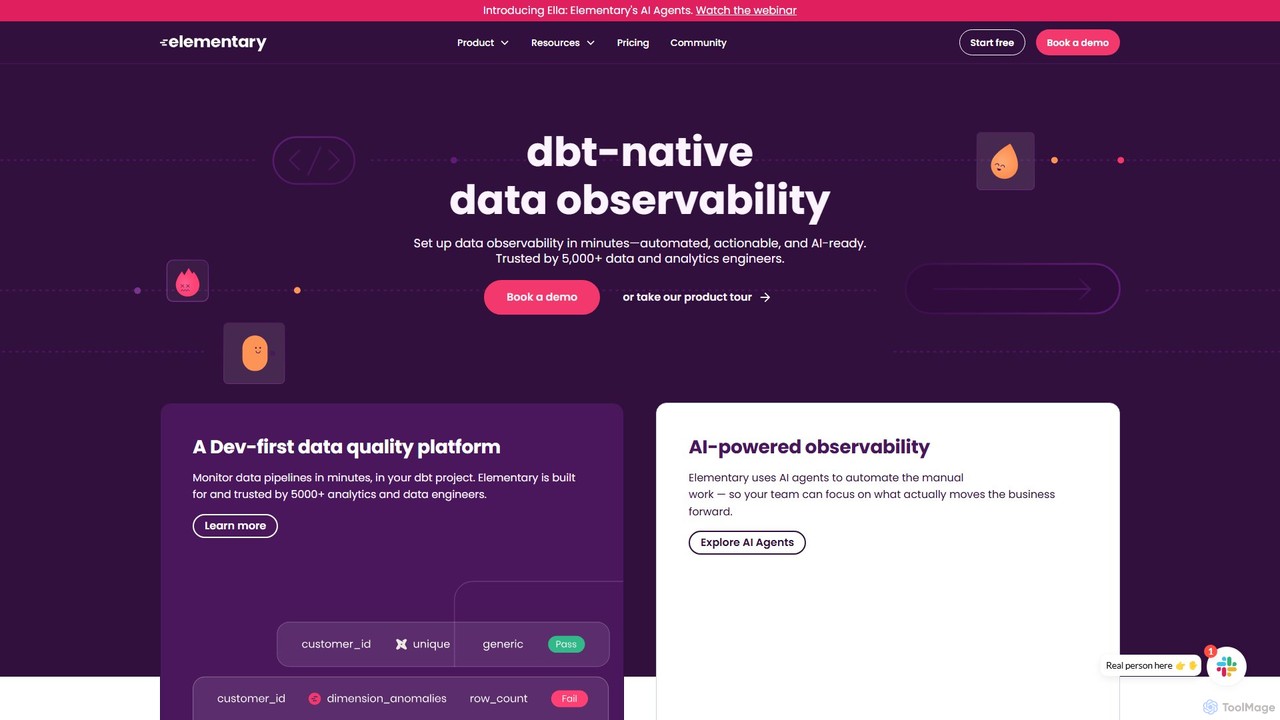
Elementary Data là một nền tảng quan sát dữ liệu gốc dbt được thiết kế cho các kỹ sư dữ liệu và phân tích. Nó sử dụng các tác nhân AI để tự động hóa việc giám sát chất lượng dữ liệu, phát hiện bất thường và cung cấp dòng dõi dữ liệu từ đầu đến cuối. Nền tảng này giúp các nhóm giảm tiếng ồn cảnh báo, giải quyết sự cố nhanh hơn và xây dựng niềm tin vào dữ liệu của họ cho các ứng dụng AI và phân tích.
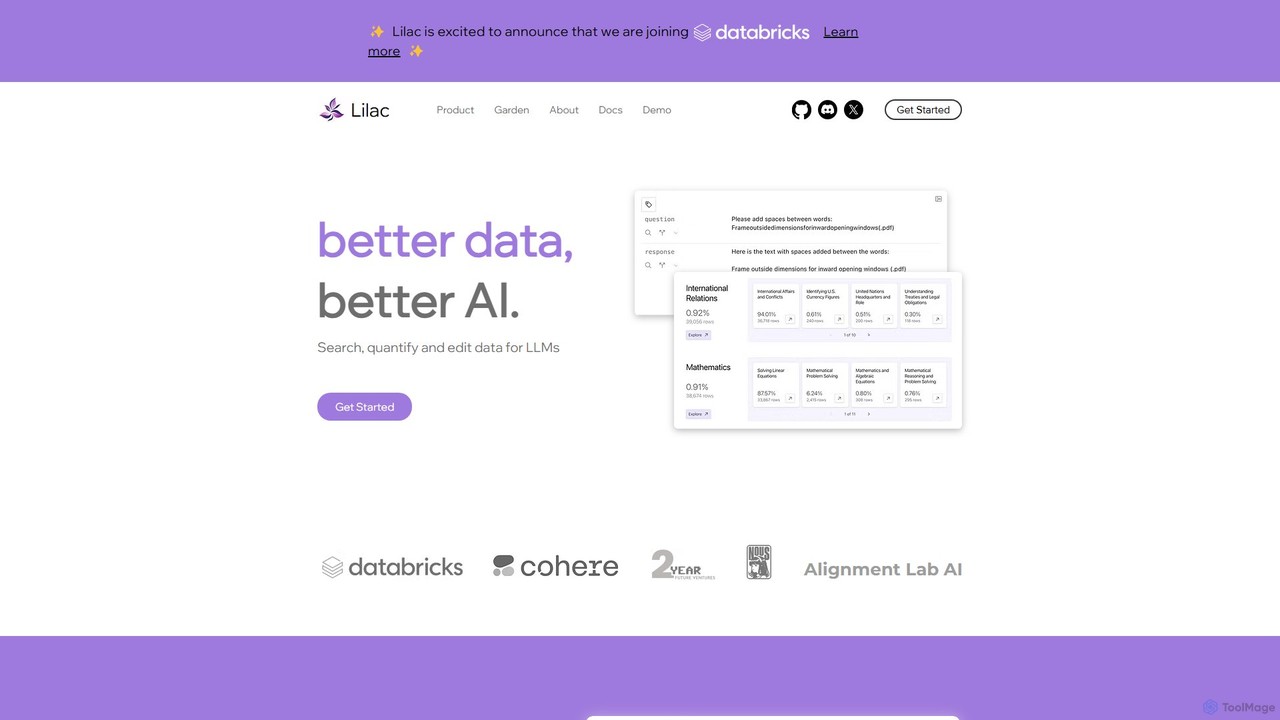
Lilac là một công cụ mã nguồn mở dành cho các nhà khoa học dữ liệu và kỹ sư ML để khám phá, làm sạch và cải thiện bộ dữ liệu cho các mô hình ngôn ngữ lớn (LLM). Nó cung cấp khả năng tìm kiếm ngữ nghĩa mạnh mẽ, phân cụm dữ liệu và phân tích chất lượng để xây dựng AI tốt hơn.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Thông tin chính | Elementary Data | Lilac |
|---|---|---|
| Pricing model | Freemium | Free |
| Product type | Web | Web |
| Primary focus | Khả năng quan sát | Huấn luyện mô hình |
| Đối tượng và vai trò | Chưa xác minh | Chưa xác minh |
| Danh mục | Khả năng quan sát · Quản lý Dữ liệu · Phân tích | Huấn luyện mô hình · Phân tích dữ liệu · Quản lý Dữ liệu |
| Added | 12 thg 8, 2025 | 6 thg 8, 2025 |
| Cập nhật | 19 thg 11, 2026 | 19 thg 11, 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Elementary Data là một nền tảng quan sát dữ liệu gốc dbt, ưu tiên nhà phát triển và được hàng nghìn kỹ sư dữ liệu và phân tích tin cậy. Nó được thiết kế để vận hành hóa chất lượng dữ liệu trong toàn bộ vòng đời dữ liệu, từ phát hiện đến giải quyết. Bằng cách tận dụng các tác nhân AI, Elementary tự động hóa các tác vụ thủ công, cho phép các nhóm dữ liệu tập trung vào các hoạt động có tác động cao thúc đẩy giá trị kinh doanh. Nền tảng này giải quyết thách thức quan trọng về chất lượng dữ liệu, thường là rào cản chính đối với việc triển khai AI thành công và áp dụng sản phẩm dữ liệu, đảm bảo rằng đầu vào xấu không dẫn đến các mô hình bị hỏng hoặc các quyết định không đáng tin cậy.
Bắt đầu với Elementary Data được thiết kế để nhanh chóng và liền mạch, đặc biệt đối với các nhóm đã sử dụng dbt. Quá trình này thường bao gồm:
Elementary Data rất linh hoạt và hỗ trợ các sáng kiến dựa trên dữ liệu khác nhau. Ví dụ, một công ty như Flock Safety đã sử dụng Elementary để thiết lập một chương trình quản trị dữ liệu thực tế. Bằng cách tập trung vào chất lượng và khám phá dữ liệu, họ đã xây dựng được niềm tin giữa các đối tác kinh doanh và các kỹ sư phân tích. Điều này dẫn đến việc tiêu thụ dữ liệu tăng lên, hợp tác tốt hơn và ra quyết định đáng tin cậy hơn. Các trường hợp sử dụng khác bao gồm:
Ưu điểm chính của Elementary là sự tích hợp sâu và gốc với hệ sinh thái dbt, làm cho nó trở thành một lựa chọn tự nhiên cho các nhóm dữ liệu hiện đại. Cách tiếp cận ưu tiên nhà phát triển của nó đảm bảo nó phù hợp liền mạch với các quy trình làm việc hiện có. Việc sử dụng các tác nhân AI để tự động hóa giúp giảm đáng kể công sức thủ công và cải thiện hiệu quả của nhóm. Hơn nữa, phạm vi bao phủ toàn diện của nó đối với toàn bộ vòng đời chất lượng dữ liệu — từ kiểm tra và giám sát đến giải quyết sự cố và quản trị — làm cho nó trở thành một giải pháp tất cả trong một. Nền tảng này được thiết kế an toàn, không bao giờ truy cập dữ liệu thô, và cung cấp cả phiên bản mã nguồn mở mạnh mẽ và các gói đám mây có thể mở rộng cho doanh nghiệp.
Elementary cung cấp một mô hình định giá linh hoạt dựa trên số lượng người dùng, với một tùy chọn mã nguồn mở miễn phí và các gói đám mây trả phí. Có sẵn bản dùng thử miễn phí 30 ngày của gói Essentials.
Lilac là một nền tảng mã nguồn mở mạnh mẽ được thiết kế để cách mạng hóa cách các nhà phát triển và nhà khoa học dữ liệu tương tác với dữ liệu để phát triển mô hình AI. Được xây dựng dựa trên nguyên tắc "Dữ liệu tốt hơn, AI tốt hơn", Lilac cung cấp một bộ công cụ toàn diện để tìm kiếm, định lượng và chỉnh sửa bộ dữ liệu, đặc biệt là những bộ dữ liệu được sử dụng để huấn luyện và tinh chỉnh các Mô hình Ngôn ngữ Lớn (LLM). Nó giải quyết nhu cầu quan trọng về dữ liệu chất lượng cao bằng cách làm cho quá trình khám phá, làm sạch và quản lý dữ liệu trở nên hiệu quả, trực quan và có khả năng mở rộng hơn.
Nền tảng này được các tổ chức hàng đầu như Alignment Lab AI và NousResearch tin cậy, giúp các nhóm vượt ra ngoài các tìm kiếm từ khóa đơn giản và có được sự hiểu biết sâu sắc, mang tính khái niệm về dữ liệu của họ. Với công cụ tính toán cực nhanh, Lilac có thể xử lý các bộ dữ liệu khổng lồ với tốc độ đáng kinh ngạc, chẳng hạn như phân cụm một triệu điểm dữ liệu chỉ trong 20 phút hoặc nhúng dữ liệu với tốc độ nửa tỷ token mỗi phút. Hiệu suất này làm cho nó trở thành một thành phần quan trọng trong bất kỳ quy trình đánh giá chất lượng dữ liệu nghiêm túc nào.
Bắt đầu với Lilac rất đơn giản, đặc biệt đối với những người quen thuộc với hệ sinh thái Python. Phương pháp sử dụng chính bao gồm cài đặt cục bộ và giao diện người dùng dựa trên web để khám phá.
pip install lilac.lilac start [path_to_your_project_dir]. Lệnh này sẽ xử lý các bộ dữ liệu của bạn và khởi chạy một máy chủ web cục bộ.Lilac là một công cụ đa năng có thể áp dụng trong toàn bộ vòng đời phát triển AI:
Lilac mang lại những lợi thế đáng kể cho các nhóm làm việc với LLM:
Lilac là một dự án mã nguồn mở, làm cho thư viện cốt lõi và giao diện người dùng của nó hoàn toàn miễn phí. Bạn có thể cài đặt và chạy nó trên máy cục bộ hoặc cơ sở hạ tầng riêng của mình mà không mất bất kỳ chi phí nào. Dự án được duy trì bởi cộng đồng và những người đóng góp. Mặc dù công cụ cốt lõi là miễn phí, có thể có các dịch vụ cấp doanh nghiệp trong tương lai, chẳng hạn như "Lilac Garden" đã được đề cập, có thể cung cấp các dịch vụ đám mây được quản lý, hỗ trợ chuyên dụng hoặc các tính năng nâng cao cho mục đích thương mại. Tuy nhiên, đối với các nhà phát triển cá nhân, nhà nghiên cứu và hầu hết các nhóm, phiên bản mã nguồn mở cung cấp đầy đủ chức năng.
Phân loại cho thấy phần giao nhau và trọng tâm riêng của từng sản phẩm. Các trường chưa biết được hiển thị rõ và không được điền bằng giả định.
Lưu lượng dùng cùng một thang đo để phản ánh đúng mức độ hiện diện trên thị trường.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 48.18% | 7.7K |
| 🇩🇪Germany | 25.01% | 4K |
| 🇧🇷Brazil | 11.23% | 1.8K |
| 🇮🇳India | 8.01% | 1.3K |
| 🇫🇷France | 7.57% | 1.2K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 100% | 16.7K |
Đánh giá và phản hồi là tín hiệu cộng đồng, không thay thế mức độ phù hợp của sản phẩm.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.