
免费增值
DigitalOcean
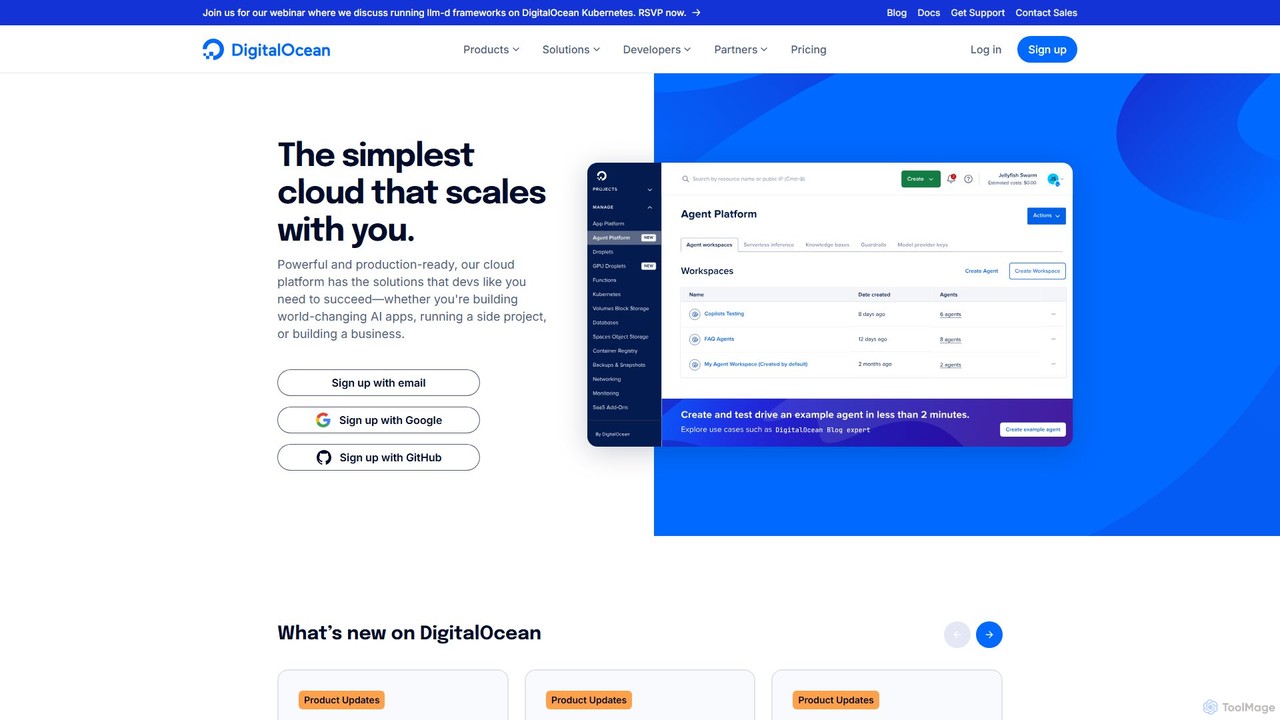
DigitalOcean 是一個專注於開發者的雲端基礎設施平台,可簡化應用程式的建置、部署和擴展。它提供一整套產品,包括虛擬機器(Droplets)、託管 Kubernetes 和 GradientAI 平台,為創建和託管足以改變世界的人工智慧應用(從個人專案到大型企業)提供強大的 GPU 資源和工具。
託管Visits 4.3MFavorites 138Likes 131
基礎設施領域的資料庫熱門 AI 工具包括 DigitalOcean 等,幫助您快速提升效率。
DigitalOcean 是一個專注於開發者的雲端基礎設施平台,可簡化應用程式的建置、部署和擴展。它提供一整套產品,包括虛擬機器(Droplets)、託管 Kubernetes 和 GradientAI 平台,為創建和託管足以改變世界的人工智慧應用(從個人專案到大型企業)提供強大的 GPU 資源和工具。
託管AI資料庫是專門的資料儲存與檢索系統,旨在處理人工智能應用所需的複雜資料類型和查詢模式。這些系統通常整合向量搜尋功能以尋找語義相似的資料,並高效管理文字、圖像和音訊等非結構化資訊。它們對於建構依賴於理解資料上下文的推薦引擎、語義搜尋和生成式AI系統至關重要。與傳統資料庫不同,AI資料庫針對高維資料和即時機器學習任務所必需的低延遲查詢進行了最佳化。
AI資料庫主要由機器學習工程師、資料科學家和AI應用開發者使用。它們在電子商務產業中是建構產品推薦系統的基礎,在SaaS領域用於創建智慧應用內搜尋,在金融領域則用於複雜的詐欺偵測。此外,它們也構成了大型語言模型檢索增強生成(RAG)系統的支柱。
選擇AI資料庫時,應考慮其提供的特定向量索引演算法及其對搜尋速度和準確性的影響。評估其可擴展性,確保它能隨您的資料量和查詢負載增長。考察其與您現有資料管道和機器學習模型的整合難易程度。最後,比較部署選項(雲端託管、自行託管、無伺服器)和定價模式,以符合您的營運需求和預算。
一家SaaS公司的支援團隊需要透過其線上說明中心為客戶提供快速準確的答案。他們使用AI資料庫儲存所有支援文章的向量嵌入。當使用者輸入「如何重設我的帳單資訊?」之類的問題時,系統會將查詢轉換為向量,並利用AI資料庫找到含義最相似的文章,而不僅僅是包含完全相同關鍵詞的文章。這帶來了更相關的搜尋結果,並顯著減少了支援工單的數量。
一家線上時尚零售商希望向購物者推薦視覺上相似的商品。他們為每張產品圖片生成一個捕捉其視覺特徵(顏色、圖案、風格)的向量嵌入,並將其儲存在AI資料庫中。當顧客查看某件連衣裙時,網站會查詢資料庫以找到向量最接近的其他商品。這使他們能夠展示一個「您可能也喜歡」的區塊,其中包含具有相似美學風格的產品,從而提高使用者參與度並增加交叉銷售的機會。
一位開發者正在建構一個AI聊天機器人,需要根據大量私有文件集合來回答問題。為避免幻覺並提供事實性答案,他們實現了一個RAG流程。所有文件被分塊、轉換為向量嵌入並儲存在AI資料庫中。當使用者提問時,系統首先查詢資料庫以檢索最相關的文件區塊。然後將這些文件區塊與原始問題一起傳遞給一個大型語言模型(LLM),使LLM能夠生成一個準確、具有上下文感知且可驗證的答案。
一家金融科技公司每秒處理數千筆交易,需要即時偵測詐欺活動。每筆交易都被轉換成一個代表其各種屬性(金額、地點、時間、商戶)的向量。然後將該向量與儲存在高效能AI資料庫中的「正常」交易向量叢集進行比較。如果一個新的交易向量遠離任何正常叢集,它就會被標記為異常並立即進行審查。AI資料庫的低延遲查詢能力對於即時做出這些決策至關重要。
一個社群媒體平台需要快速識別並移除仇恨言論或暴力圖片等有害內容。他們維護一個AI資料庫,其中包含已知違規內容的向量嵌入。當使用者上傳新圖片或文字貼文時,它會立即被轉換為向量。然後,平台對資料庫執行相似性搜尋。如果新內容的向量與已知的有害內容高度相似,它將被自動標記或移除,從而實現了僅靠人工審核員無法達成的大規模審核。
在生物資訊學中,研究人員分析龐大的化合物資料庫以尋找潛在的新藥。每個分子都可以表示為一個獨特的向量指紋。一個藥物研究團隊使用AI資料庫儲存數百萬種化合物的這些指紋。在尋找針對特定疾病的候選藥物時,他們可以用一種已知有效化合物的指紋來查詢資料庫。資料庫會迅速返回一個結構相似的分子列表,極大地縮小了搜尋範圍,並加速了藥物發現的初始階段。
AI資料庫是專為AI和機器學習工作負載設計的資料儲存系統。與在行和列中儲存結構化資料的傳統資料庫不同,AI資料庫擅長管理和查詢高維資料,例如向量嵌入。它們的主要特點是向量搜尋,該功能允許基於語義相似性而非精確匹配來尋找資料。這使得它們對於語義搜尋、推薦引擎和生成式AI等應用至關重要。
選擇合適的AI資料庫取決於您的具體需求。請考慮以下因素:
核心區別在於它們儲存和檢索資料的方式。傳統SQL資料庫將結構化資料儲存在具有預定義模式的表中,並使用精確查詢來檢索它(例如,`SELECT * FROM users WHERE city = 'New York'`)。向量資料庫是AI資料庫的一種常見類型,它儲存高維向量嵌入,並根據向量空間中的相似性或接近度來檢索資料。它回答的是「找到與這張圖片相似的圖片」之類的問題,而不是「找到ID為123的圖片」。SQL資料庫用於結構化資料和精確查找,而向量資料庫用於非結構化資料和概念搜尋。
AI資料庫的主要特點通常包括:
AI資料庫對於那些建構需要理解資料語義含義的應用程式的開發人員、資料科學家和機器學習工程師來說是必不可少的。如果您的應用程式包含語義搜尋、產品或內容推薦、圖像相似性搜尋、異常偵測或用於LLM的檢索增強生成(RAG)等功能,那麼AI資料庫就是您基礎設施的關鍵組成部分。基本上,任何處理已轉換為向量嵌入的非結構化資料(文字、圖像、音訊)的人都將從使用AI資料庫中受益。