Crawly
網頁抓取
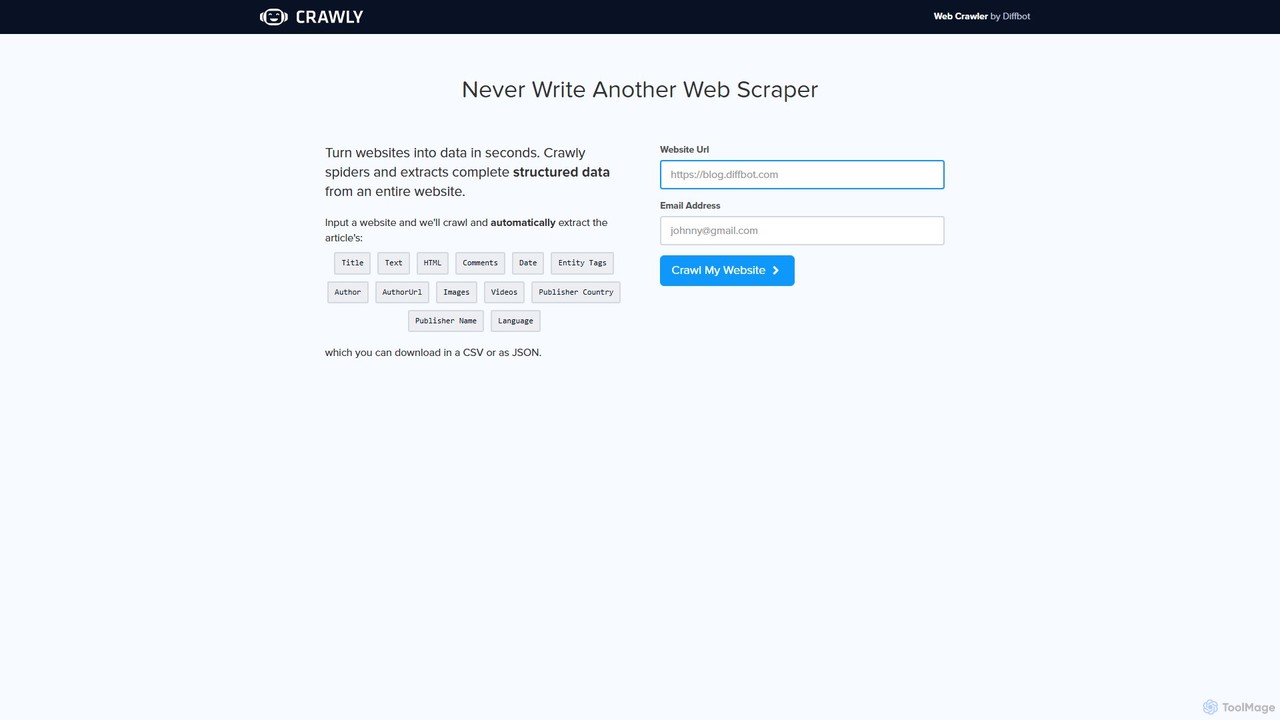
Crawly 是 Diffbot 推出的一款由人工智能驅動的網路爬蟲,可自動從整個網站提取結構化資料。只需輸入一個 URL,Crawly 即可抓取網站以提取文章、產品和討論等關鍵資訊,並將其轉換為乾淨的 JSON 或 CSV 資料,無需任何編碼。
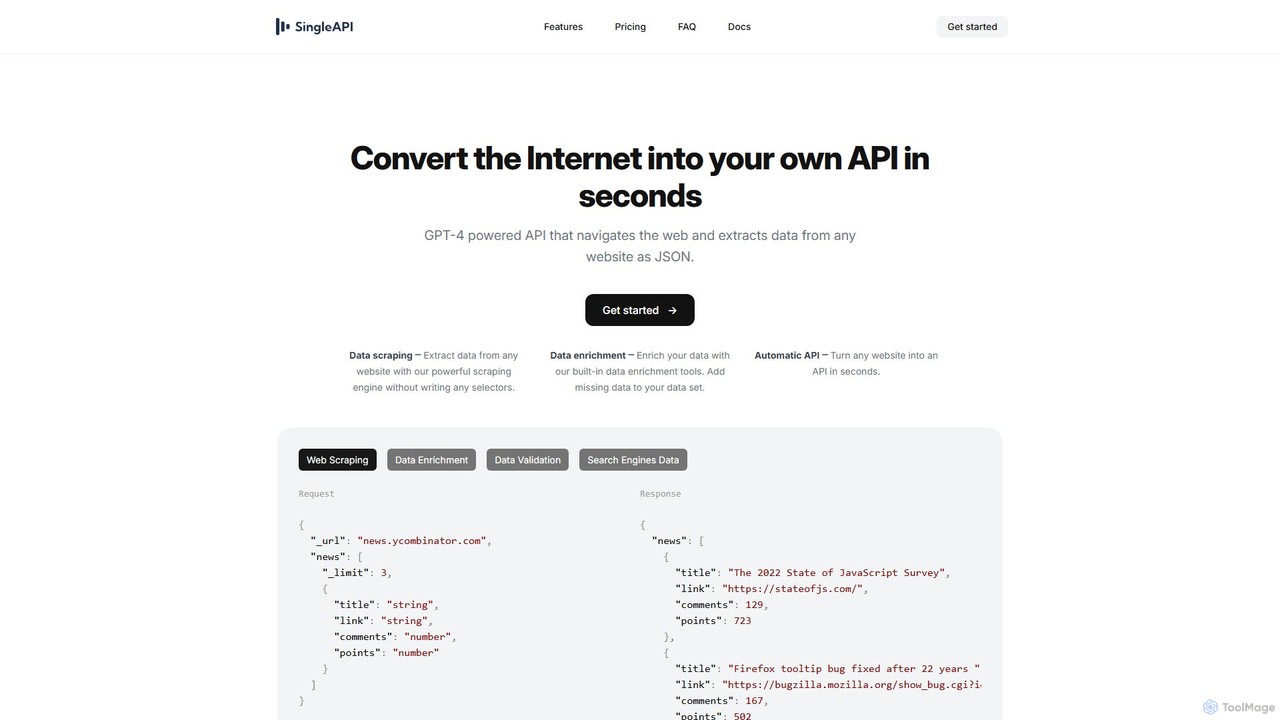
SingleAPI 是一款由 GPT-4 驅動的工具,可立即將任何網站轉換為結構化的 JSON API。它簡化了網頁抓取、資料提取和資料豐富化過程,無需編寫任何程式碼或選擇器,讓使用者能輕鬆獲取各種應用的網頁資料。
并排查看产品定位、价格模式和目标用户。浅色行表示收录资料不同;未收录价格不代表免费。
| 核心事實 | Crawly | SingleAPI |
|---|---|---|
| 价格类型 | 免费增值 | 免费增值 |
| 产品形态 | 网站 | 网站 |
| 主要定位 | 網頁抓取 | 網頁抓取 |
| 受眾與職務 | 暫無資料 | 暫無資料 |
| 分類 | 網頁抓取 · API · 市場研究 · 自動化 | 網頁抓取 · API · 資料擷取 · 自動化 |
| 收录时间: | 2025年8月10日 | 2025年8月10日 |
| 更新於 | 2026年11月19日 | 2026年11月19日 |
以下展示两款工具已收录的详细资料。按各自的功能和工作方式逐项阅读,不把标签当作功能评测。
Crawly 是由人工智能資料提取領域的領導者 Diffbot 開發的一款功能強大且智慧的網路爬蟲。其設計初衷是徹底消除網路抓取的手動操作和技術挑戰。Crawly 不依賴於編寫複雜的程式碼或使用在網站更新後容易失效的脆弱選擇器,而是利用包括電腦視覺和自然語言處理在內的先進人工智能技術,像人類一樣理解和解讀網頁。這使其僅需一個 URL 作為輸入,即可自動識別並從整個網站提取完整、結構化的資料。
Crawly 的核心承諾是「在幾秒鐘內將網站轉化為資料」。它會在網站中導航,追蹤連結並分析每個頁面的結構,以區分文章、產品、討論和圖片庫等各種內容類型。提取出的資料隨後被組織成乾淨、結構化的格式,可立即用於應用程式、資料分析或機器學習模型。
Crawly 的使用設計得極其簡單,任何人都可以輕鬆上手,無論技術水準如何。整個過程僅需幾個步驟:
Crawly 是一款多功能工具,適用於廣泛的應用場景:
Crawly 的主要優勢在於其簡單性和強大功能。它使網路資料提取大眾化,讓非開發人員也能執行通常需要工程師團隊才能完成的任務。透過自動化整個抓取過程,它節省了大量的時間和資源。此外,其 AI 驅動的方法確保了比傳統方法更高的準確性和更強的彈性,提供了可靠的高品質資料流。作為 Diffbot 的產品,它得到了全球各大公司信賴的企業級技術支援。
Crawly 在其主頁上提供免費試用抓取,用戶可以透過輸入 URL 和電子郵件地址來測試其功能。這旨在提供該工具可以生成的結構化資料的範例。對於更廣泛的需求,例如大規模抓取、頻繁的資料提取或用於程式化使用的 API 存取,用戶通常需要訂閱其母公司 Diffbot 提供的全套工具。Diffbot 的定價是分層的,為新創公司、企業和大型企業提供不同的計劃,提供不同級別的 API 呼叫和功能。
SingleAPI 是一款革命性的工具,旨在將整個網際網路轉變為對開發者友善的結構化資料來源。它由 GPT-4 驅動,提供了一個智慧 API,能夠瀏覽任何網站,理解其結構,並在幾秒鐘內將所需資訊提取為乾淨的 JSON 格式。這消除了傳統網頁抓取中繁瑣複雜的過程,在傳統方式中,開發者需要編寫和維護脆弱的選擇器(如 CSS 選擇器或 XPath)來定位特定的資料點。使用 SingleAPI,您只需描述所需的資料,剩下的一切都由 AI 處理。
該平台兼具簡單性與強大功能,滿足從個人愛好者到大型企業的廣泛使用者需求。無論您是需要監控競爭對手定價、聚合新聞、產生潛在客戶,還是豐富現有資料集,SingleAPI 都提供了一個強大可靠的解決方案,可顯著節省時間和資源。
使用 SingleAPI 非常簡單。整個過程只需發送一個簡單的 HTTP 請求,其 JSON 請求體中指定了目標網站和您希望提取的資料模式。然後,AI 引擎會訪問該 URL,解釋您的請求,在頁面上找到相關資料,並以完美的結構化 JSON 回應返回。
例如,要從 Hacker News 提取前 3 篇文章,您的請求如下所示:
請求:
{
  "_url": "news.ycombinator.com",
  "news": [
    {
      "_limit": 3,
      "title": "string",
      "link": "string",
      "comments": "number",
      "points": "number"
    }
  ]
}
SingleAPI 的 AI 會理解這個結構,導航到 Hacker News,識別文章列表,並提取前三篇文章的標題、連結、評論數和點讚數,最終返回一個乾淨的 JSON 物件。
SingleAPI 的多功能性使其適用於廣泛的應用場景:
SingleAPI 的主要優勢在於其簡單性和效率。它抽象了網頁抓取的複雜性,例如處理動態的、重度依賴 JavaScript 的網站、管理代理和解析 HTML。這使得開發者和非開發者都能專注於使用資料,而不是獲取資料。與傳統抓取工具相比,其 AI 驅動的方法使其對網站佈局變化的適應性更強。其靈活的資料格式和透過 webhooks 實現的即時交付,使其成為現代資料驅動型業務的強大工具。
SingleAPI 提供分層定價結構以滿足不同需求:
分類與標籤可看出兩款產品的重疊範圍,以及各自更明確的定位重點。 未知欄位會明確顯示,不會用推測內容補齊。
流量資料使用同一比例尺,避免弱化兩款產品在市場能見度上的真實差距。
左右图表使用相同的月份与纵轴比例。各工具最新统计月份已单独标注;缺失月份保留空缺,不记为零。地区和来源的访问量是根据比例计算的估算值。
| 国家/地区 | 百分比 | 估算访问量 |
|---|---|---|
| 🇳🇬Nigeria | 82.43% | 1.5K |
| 🇩🇪Germany | 9.9% | 177 |
| 🇨🇦Canada | 7.67% | 137 |
| 国家/地区 | 百分比 | 估算访问量 |
|---|---|---|
| 🇮🇶Iraq | 100% | 438 |
評分、評論、收藏和按讚屬於社群訊號,不能取代對具體使用情境的判斷。
本页由 ToolMage 已收录的产品资料、分类标签、流量统计和站内用户反馈自动整理,不是上手实测或独立评测。