ToolMage
Anmelden

Best 1 Modellbewertung AI tools for Künstliche Intelligenz

Popular Modellbewertung AI tools in Künstliche Intelligenz include OCR Arena, helping you work more efficiently.

OCR Arena
Free

OCR Arena

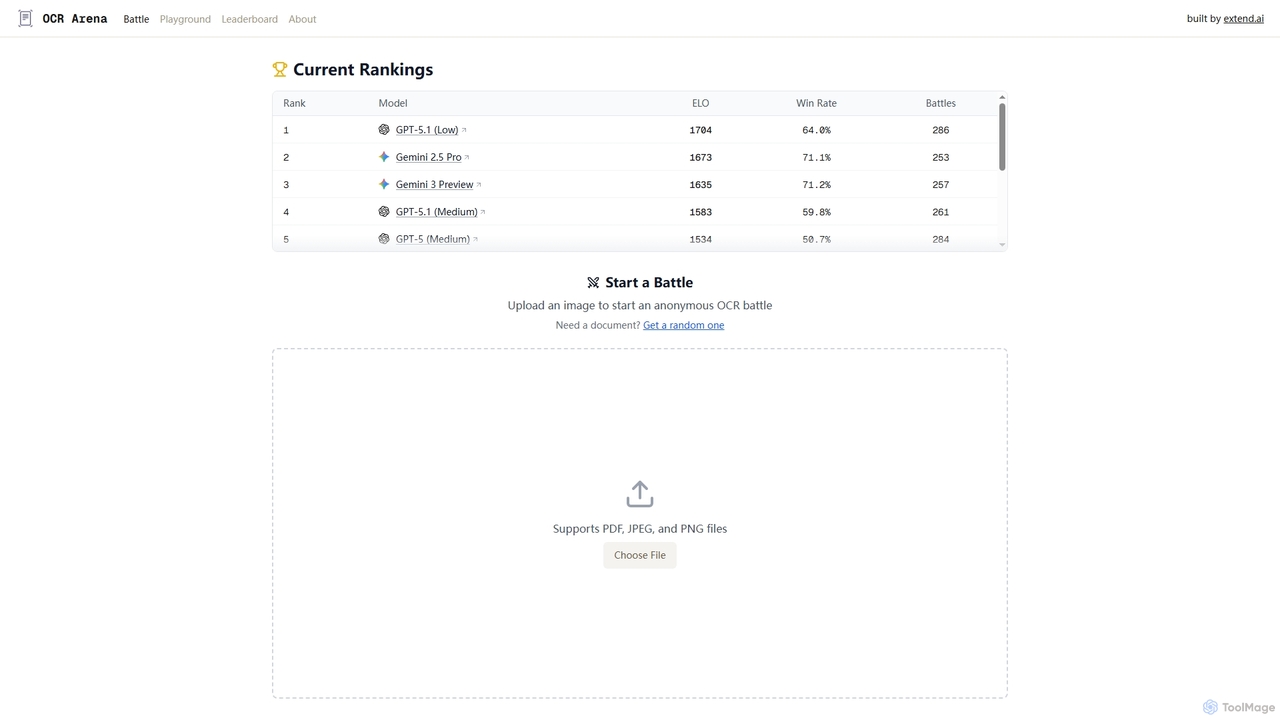
OCR Arena ist eine kostenlose Online-Plattform zum Testen und Bewerten führender grundlegender Vision-Language Models (VLMs) und Open-Source Optical Character Recognition (OCR)-Modelle. Benutzer können Dokumente hochladen, die Genauigkeit messen und die Modellleistung auf einer öffentlichen Rangliste vergleichen.

Modellbewertung
Visits 18.6KFavorites 135Likes 140

About Modellbewertung

Modellbewertungstools sind KI-gestützte Plattformen, die entwickelt wurden, um die Leistung, Qualität und Zuverlässigkeit von Machine-Learning-Modellen rigoros zu bewerten. Diese Tools nutzen statistische Analysen, Leistungsmetriken und Diagnosetechniken, um zu quantifizieren, wie effektiv ein Modell auf ungesehene Daten generalisiert. Ihr Hauptwert liegt darin, sicherzustellen, dass KI-Systeme präzise, fair, robust und bereit für den realen Einsatz sind, wodurch Risiken minimiert und die Betriebseffizienz maximiert werden.

Kernfunktionen

  • Berechnung von Leistungsmetriken: Automatische Berechnung wichtiger Metriken wie Genauigkeit, Präzision, Recall, F1-Score, MSE und AUC-ROC für verschiedene Modelltypen.
  • Bias-Erkennung und Fairness-Analyse: Identifiziert und quantifiziert potenzielle Verzerrungen innerhalb von Modellen, um gerechte Ergebnisse über verschiedene demografische Gruppen hinweg zu gewährleisten.
  • Fehleranalyse und Debugging: Zeigt spezifische Datenpunkte oder Szenarien auf, in denen ein Modell schlecht abschneidet, und unterstützt so eine gezielte Modellverbesserung.
  • Modellvergleich und -auswahl: Ermöglicht den direkten Vergleich mehrerer Modellversionen oder Algorithmen, um den besten Performer zu identifizieren.
  • Datendrift- und Anomalieerkennung: Überwacht bereitgestellte Modelle auf Verschiebungen in der Datenverteilung oder Leistungsabfall im Laufe der Zeit.

Anwendungsfälle

Datenwissenschaftler und Machine-Learning-Ingenieure nutzen diese Tools, um neue Modelliterationen vor der Produktion zu validieren und sicherzustellen, dass sie vordefinierte Leistungsbenchmarks erfüllen. KI-Produktmanager verwenden sie, um verschiedene Modellkandidaten für neue Funktionen zu vergleichen und datengesteuerte Entscheidungen bei der Modellauswahl zu treffen. Forscher setzen Modellbewertungsplattformen auch ein, um die Robustheit und Generalisierbarkeit neuartiger KI-Algorithmen rigoros zu bewerten.

Auswahlkriterien

Bei der Auswahl eines Modellbewertungstools sollten Sie dessen Kompatibilität mit Ihren bestehenden Machine-Learning-Frameworks und unterstützten Modelltypen (z. B. TensorFlow, PyTorch) berücksichtigen. Bewerten Sie die Bandbreite der angebotenen Bewertungsmetriken, insbesondere für spezifische Aufgaben wie NLP oder Computer Vision. Priorisieren Sie Tools mit starken Interpretierbarkeits- und Erklärbarkeitsfunktionen und bewerten Sie deren Integrationsfähigkeiten mit Ihren MLOps-Pipelines für einen nahtlosen Workflow. Die Skalierbarkeit für die Verarbeitung großer Datensätze ist ebenfalls ein entscheidender Faktor.

Modellbewertung use cases

1

Validierung neuer Machine-Learning-Modelle

Datenwissenschaftler testen und validieren neu entwickelte Machine-Learning-Modelle rigoros, bevor sie in Produktion genommen werden. Durch den Einsatz von Modellbewertungstools können sie umfassende Tests durchführen, Leistungsmetriken wie Genauigkeit und F1-Score auf ungesehenen Daten berechnen und sicherstellen, dass das Modell alle Leistungsbenchmarks und Qualitätsstandards erfüllt, wodurch kostspielige Fehler in Live-Systemen vermieden werden.

2

Validierung neuer Machine-Learning-Modelle

Datenwissenschaftler nutzen Modellbewertungstools, um neu entwickelte Machine-Learning-Modelle vor der Bereitstellung rigoros zu testen. Dies beinhaltet die Berechnung von Leistungsmetriken wie Genauigkeit, Präzision und Recall auf ungesehenen Daten, die Identifizierung potenzieller Über- oder Unteranpassung und die Sicherstellung, dass das Modell vordefinierte Leistungsbenchmarks erfüllt. Dieser Prozess minimiert Risiken, die mit der Bereitstellung unzuverlässiger Modelle verbunden sind, und gewährleistet eine robuste Leistung in Produktionsumgebungen.

3

Erkennung von Modellverzerrungen in KI-Systemen

KI-Ethiker und Datenwissenschaftler setzen diese Tools ein, um potenzielle Verzerrungen in KI-Modellen zu identifizieren und zu quantifizieren, insbesondere in sensiblen Anwendungen wie der Kreditwürdigkeitsprüfung oder der Personalbeschaffung. Die Tools helfen, das Modellverhalten über verschiedene demografische Gruppen hinweg zu analysieren, um Fairness zu gewährleisten und diskriminierende Ergebnisse zu verhindern, was für den ethischen KI-Einsatz und die Einhaltung gesetzlicher Vorschriften entscheidend ist.

4

Überwachung bereitgestellter KI-Systeme auf Drift

MLOps-Ingenieure setzen Modellbewertungstools ein, um die Leistung von in Produktion befindlichen KI-Modellen kontinuierlich zu überwachen. Diese Tools erkennen Daten-Drift (Änderungen in der Eingabedatenverteilung) und Konzept-Drift (Änderungen in der Beziehung zwischen Eingabe- und Zielvariablen), die die Modellgenauigkeit im Laufe der Zeit beeinträchtigen können. Durch die Einrichtung von Warnungen für signifikante Drifts können Teams Modelle proaktiv neu trainieren oder aktualisieren, um eine optimale Leistung aufrechtzuerhalten und kostspielige Fehler in realen Anwendungen zu vermeiden.

5

Sicherstellung der Fairness und Minderung von Bias in der KI

Organisationen nutzen Modellbewertungstools, um Bias in KI-Modellen zu identifizieren und zu mindern, insbesondere in sensiblen Anwendungen wie Personalbeschaffung, Kreditvergabe oder Gesundheitswesen. Diese Tools analysieren Modellvorhersagen über verschiedene demografische Gruppen (z. B. Alter, Geschlecht, ethnische Zugehörigkeit), um unfaire Ergebnisse zu erkennen. Durch die Quantifizierung von Fairness-Metriken und die Visualisierung von Ungleichheiten können Datenethiker und Entwickler Modelle verfeinern, um eine gerechte Entscheidungsfindung zu fördern und ethische KI-Richtlinien einzuhalten, wodurch das Vertrauen der Öffentlichkeit gestärkt wird.

6

Optimierung von Hyperparametern für Deep Learning

Machine-Learning-Ingenieure nutzen Modellbewertungsplattformen, um den Einfluss verschiedener Hyperparameterkonfigurationen auf die Leistung von Deep-Learning-Modellen systematisch zu bewerten. Durch die Durchführung von Experimenten und den Vergleich von Metriken wie Validierungsverlust und Genauigkeit können sie den optimalen Satz von Hyperparametern identifizieren, der zu den leistungsstärksten und robustesten Modellen führt, wodurch die Entwicklungseffizienz erheblich verbessert wird.

7

Debugging und Verbesserung der Modellleistung

KI-Entwickler nutzen Modellbewertungstools, um ihre Modelle zu debuggen und iterativ zu verbessern. Interpretierbarkeitsfunktionen (XAI) helfen ihnen zu verstehen, welche Merkmale am meisten zu den Vorhersagen eines Modells beitragen oder warum ein Modell einen bestimmten Fehler gemacht hat. Durch die Identifizierung von Schwachstellen und Verbesserungsbereichen können Entwickler Modellarchitekturen verfeinern, Hyperparameter anpassen oder Trainingsdaten erweitern, was zu genaueren und effizienteren KI-Lösungen führt.

8

Überwachung der Leistungsdrift von bereitgestellten Modellen

MLOps-Teams integrieren Modellbewertungstools in ihre Produktionspipelines, um die Leistung bereitgestellter KI-Modelle kontinuierlich zu überwachen. Diese Tools verfolgen wichtige Metriken im Laufe der Zeit, erkennen Datendrift oder Konzeptdrift und alarmieren Teams bei jeder Verschlechterung der Modellgenauigkeit oder -zuverlässigkeit. Diese proaktive Überwachung stellt sicher, dass Modelle in dynamischen realen Umgebungen effektiv und relevant bleiben.

9

Vergleich mehrerer KI-Algorithmus-Kandidaten

Forscher und Entwicklungsteams verwenden Modellbewertungstools, um die Stärken und Schwächen verschiedener KI-Algorithmen oder Modellarchitekturen für ein bestimmtes Problem objektiv zu vergleichen. Durch die Standardisierung von Bewertungsmetriken und Datensätzen können sie fundierte Entscheidungen darüber treffen, welcher Ansatz überlegene Ergebnisse liefert, wodurch Forschungs- und Entwicklungszyklen beschleunigt werden.

10

Benchmarking und Vergleich von KI-Algorithmen

Forscher und Datenwissenschaftsteams verwenden Modellbewertungstools, um verschiedene KI-Algorithmen oder Modellversionen miteinander zu vergleichen. Durch die Anwendung konsistenter Bewertungsmetriken und Datensätze können sie objektiv die Stärken und Schwächen verschiedener Ansätze vergleichen. Dies ist entscheidend für die Auswahl des leistungsstärksten Modells für eine bestimmte Aufgabe, die Optimierung der Ressourcenzuweisung und die Weiterentwicklung des Stands der Technik in der KI-Forschung und -Entwicklung.

11

Sicherstellung der regulatorischen Compliance für KI-Modelle

Branchen mit strengen Vorschriften, wie Finanzen und Gesundheitswesen, verlassen sich auf Modellbewertungstools, um sicherzustellen, dass ihre KI-Modelle den gesetzlichen und ethischen Standards entsprechen. Diese Tools liefern auditierbare Berichte über Modellleistung, Fairness und Transparenz, die oft von Aufsichtsbehörden gefordert werden. Durch die systematische Dokumentation der Bewertungsergebnisse können Organisationen die gebotene Sorgfalt nachweisen, Strafen vermeiden und Vertrauen bei Stakeholdern und Kunden aufbauen.

12

Sicherstellung der Einhaltung gesetzlicher Vorschriften für KI-Modelle

Compliance-Beauftragte und Rechtsteams nutzen Modellbewertungstools, um zu überprüfen, ob KI-Modelle branchenspezifische Vorschriften, Fairness-Richtlinien und Transparenzanforderungen einhalten. Diese Tools liefern auditierbare Berichte über Modellleistung, Bias-Analyse und Erklärbarkeit und helfen Organisationen, die Einhaltung nachzuweisen und Vertrauen bei Stakeholdern und Aufsichtsbehörden aufzubauen.

Modellbewertung FAQ

Was sind Modellbewertungstools?

Modellbewertungstools sind spezialisierte Softwareplattformen, die zur Bewertung der Qualität, Leistung und ethischen Auswirkungen von Machine-Learning-Modellen verwendet werden. Sie helfen Datenwissenschaftlern und MLOps-Teams zu verstehen, wie gut ein Modell bei verschiedenen Aufgaben abschneidet, Verzerrungen zu identifizieren und seine Zuverlässigkeit vor und nach der Bereitstellung sicherzustellen. Diese Tools sind entscheidend für den Aufbau vertrauenswürdiger und effektiver KI-Systeme.

Was sind Modellbewertungstools in der KI?

Modellbewertungstools sind spezialisierte Softwareplattformen, die entwickelt wurden, um die Leistung, Qualität und Zuverlässigkeit von Machine-Learning-Modellen zu bewerten. Sie helfen Datenwissenschaftlern und Ingenieuren zu verstehen, wie gut ein Modell auf neue Daten generalisiert, potenzielle Verzerrungen zu identifizieren und sicherzustellen, dass es spezifische Leistungskriterien vor oder nach dem Einsatz erfüllt. Diese Tools sind entscheidend für den Aufbau vertrauenswürdiger und effektiver KI-Systeme.

Wie wähle ich das richtige Modellbewertungstool für mein Projekt aus?

Bei der Auswahl eines Modellbewertungstools sollten Sie mehrere Faktoren berücksichtigen: die Arten von Machine-Learning-Modellen und Frameworks, die es unterstützt (z. B. TensorFlow, PyTorch), die Bandbreite der angebotenen Bewertungsmetriken (z. B. Klassifikation, Regression, NLP-spezifische), seine Fähigkeiten zur Bias-Erkennung und Interpretierbarkeit sowie seine Integration in Ihren bestehenden MLOps-Workflow. Die Skalierbarkeit für die Größe Ihres Datensatzes und Teamkollaborationsfunktionen sind ebenfalls wichtig.

Warum ist die Modellbewertung für die KI-Entwicklung entscheidend?

Die Modellbewertung ist entscheidend, da sie sicherstellt, dass KI-Modelle genau, fair und robust sind, bevor sie reale Entscheidungen beeinflussen. Ohne eine ordnungsgemäße Bewertung können Modelle Verzerrungen aufrechterhalten, falsche Vorhersagen treffen oder sich im Laufe der Zeit verschlechtern, was zu finanziellen Verlusten, Reputationsschäden oder ethischen Bedenken führen kann. Eine rigorose Bewertung hilft, die Modellintegrität zu validieren, das Vertrauen der Benutzer aufzubauen und regulatorische Standards einzuhalten, wodurch KI-Systeme zuverlässig und verantwortungsbewusst werden.

Welche Schlüsselmetriken werden bei der Modellbewertung verwendet?

Schlüsselmetriken variieren je nach Modelltyp. Für Klassifikationsmodelle gehören Genauigkeit, Präzision, Recall, F1-Score und AUC (Fläche unter der ROC-Kurve) zu den gängigen Metriken. Für Regressionsmodelle werden häufig RMSE (Wurzel des mittleren quadratischen Fehlers), MAE (Mittlerer absoluter Fehler) und R-Quadrat verwendet. Fairness-Metriken wie demografische Parität und ausgeglichene Chancen sind ebenfalls entscheidend für die Bewertung von Verzerrungen. Die Wahl der Metriken hängt vom spezifischen Problem und den Geschäftszielen ab.

Welche Kernfunktionen bieten Modellbewertungstools?

Zu den Kernfunktionen gehören typischerweise die automatische Berechnung verschiedener Leistungsmetriken (wie Genauigkeit, Präzision, Recall, F1-Score, MSE), Tools zur Erkennung und Analyse von Modellverzerrungen, Fehleranalyse zur Identifizierung problematischer Vorhersagen und Funktionen zum direkten Vergleich mehrerer Modellversionen. Viele bieten auch Interpretierbarkeitsfunktionen zur Erklärung von Modellentscheidungen und Überwachungsfunktionen für bereitgestellte Modelle.

Wie helfen Modellbewertungstools bei der Bias-Erkennung?

Modellbewertungstools erkennen Bias, indem sie die Modellleistung und -vorhersagen über verschiedene Untergruppen innerhalb der Daten analysieren, die oft durch sensible Attribute wie Geschlecht, Alter oder ethnische Zugehörigkeit definiert sind. Sie berechnen Fairness-Metriken (z. B. statistische Parität, Chancengleichheit) und visualisieren Ungleichheiten bei Fehlerraten oder Vorhersageergebnissen zwischen diesen Gruppen. Dies hilft zu erkennen, ob ein Modell für bestimmte Bevölkerungsgruppen unfair arbeitet, und ermöglicht es Entwicklern, Korrekturmaßnahmen zur Minderung von Bias zu ergreifen.

Warum ist die Modellbewertung für eine erfolgreiche KI-Entwicklung entscheidend?

Die Modellbewertung ist entscheidend, weil sie sicherstellt, dass KI-Modelle nicht nur genau, sondern auch fair, robust und zuverlässig in realen Szenarien sind. Ohne eine ordnungsgemäße Bewertung könnten Modelle auf ungesehenen Daten schlecht abschneiden, schädliche Verzerrungen aufweisen oder in der Produktion stillschweigend versagen, was zu erheblichen finanziellen Verlusten oder ethischen Bedenken führen würde. Sie leitet die iterative Verbesserung und schafft Vertrauen in KI-Systeme.

Wie unterscheidet sich die Modellbewertung vom Modelltraining?

Modelltraining ist der Prozess, bei dem ein Machine-Learning-Algorithmus Muster aus einem Datensatz lernt, um ein Modell zu erstellen. Modellbewertung hingegen ist der nachfolgende Prozess, bei dem bewertet wird, wie gut dieses trainierte Modell auf einem separaten, ungesehenen Datensatz abschneidet. Das Training konzentriert sich auf das Lernen, während die Bewertung sich auf die Überprüfung der Qualität, Generalisierungsfähigkeit und Einsatzbereitschaft des gelernten Modells für die praktische Anwendung konzentriert.

Was ist der Unterschied zwischen Modellbewertung und Modellüberwachung?

Die Modellbewertung konzentriert sich hauptsächlich auf die Bewertung der Leistung und Eigenschaften eines Modells *vor* oder *unmittelbar nach* der Bereitstellung, oft unter Verwendung eines festen Testdatensatzes. Es geht um die anfängliche Validierung und Fehlerbehebung. Die Modellüberwachung hingegen beinhaltet die kontinuierliche Verfolgung der Leistung eines Modells, des Daten-Drifts und des Konzept-Drifts *nachdem* es in einer Live-Produktionsumgebung bereitgestellt wurde. Die Bewertung ist eine Momentaufnahme, während die Überwachung ein fortlaufender Prozess ist, um eine nachhaltige Leistung sicherzustellen und eine Verschlechterung im Laufe der Zeit zu erkennen.