ToolMage
Anmelden

Best 2 GPU-Infrastruktur AI tools for Cloud Computing

Popular GPU-Infrastruktur AI tools in Cloud Computing include Together AI und NeocloudX, helping you work more efficiently.

NeocloudX
Paid

NeocloudX

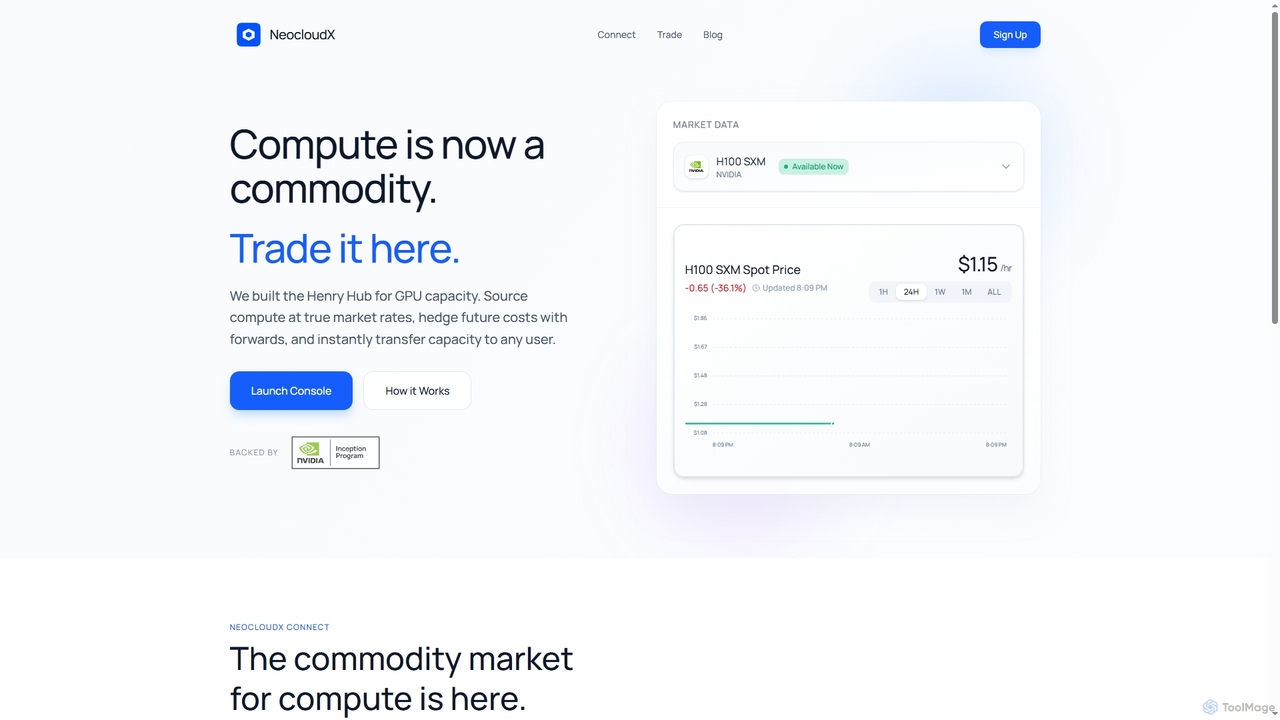
NeocloudX ist ein innovativer Marktplatz, der GPU-Rechenkapazität als Ware behandelt und es Benutzern ermöglicht, Hochleistungs-Computing-Ressourcen wie NVIDIA H100 SXM GPUs zu echten Marktpreisen zu kaufen, zu verkaufen und zu handeln. Es bietet sofortigen Zugriff auf Bare-Metal-Leistung über eine browserbasierte Konsole und ermöglicht erhebliche Kosteneinsparungen im Vergleich zu traditionellen Cloud-Anbietern.

Maschinelles Lerninfrastruktur
Visits 6.4KFavorites 128Likes 112
Together AI
Freemium

Together AI

Together AI ist eine führende Cloud-Plattform für Entwickler, die eine schnelle und kostengünstige Infrastruktur zum Ausführen, Feinabstimmen und Trainieren von Open-Source-Generative-AI-Modellen bereitstellt. Sie bietet eine umfangreiche Bibliothek mit über 200 Modellen, serverlose Inferenz-APIs, anpassbares Fine-Tuning und dedizierte GPU-Cluster und schafft so eine End-to-End-Lösung für die Erstellung und Skalierung von KI-Anwendungen.

GPU-Infrastruktur
Visits 762.5KFavorites 122Likes 132

About GPU-Infrastruktur

GPU-Infrastruktur bietet On-Demand-Zugriff auf leistungsstarke Grafikprozessoren (GPUs) über die Cloud und bildet ein spezialisiertes Segment des Cloud-Computing. Diese Plattformen sind für massiv parallele Verarbeitung konzipiert und nutzen Tausende von Kernen in jeder GPU, um rechenintensive Aufgaben zu beschleunigen. Diese Infrastruktur ist entscheidend für das Training komplexer KI-Modelle, die Durchführung großer wissenschaftlicher Simulationen und das Rendern von hochauflösenden Grafiken und bietet eine skalierbare Leistung, die herkömmliche CPU-basierte Server nicht erreichen können. Sie ermöglicht es Entwicklern und Forschern, komplexe Probleme ohne die hohen Kosten und den Wartungsaufwand von On-Premise-Hardware zu bewältigen.

Kernfunktionen

  • Hochleistungs-GPUs: Zugriff auf GPUs der Enterprise-Klasse (z. B. NVIDIA A100, H100), die für KI- und High-Performance-Computing (HPC)-Workloads optimiert sind.
  • Skalierbare Cluster: Möglichkeit, mehrere GPUs sowohl innerhalb eines einzelnen Servers als auch über ein Netzwerk hinweg bereitzustellen und zu verbinden, um verteilte Rechenaufgaben durchzuführen.
  • Vorkonfigurierte Umgebungen: Gebrauchsfertige Software-Stacks mit den erforderlichen Treibern, CUDA-Bibliotheken und beliebten Machine-Learning-Frameworks wie TensorFlow und PyTorch.
  • Hochgeschwindigkeitsnetzwerk: Verbindungen mit geringer Latenz und hoher Bandbreite, die für eine effiziente Datenübertragung bei Multi-Node-Training und -Simulationen unerlässlich sind.
  • Flexible Preismodelle: Optionen wie Pay-as-you-go, reservierte Instanzen und Spot-Instanzen zur Kostenoptimierung basierend auf den Arbeitslastmustern.

Anwendungsszenarien

GPU-Infrastruktur ist für Branchen wie Technologie, wissenschaftliche Forschung, Unterhaltung und Finanzen unerlässlich. KI-Forscher nutzen sie, um große Sprachmodelle (LLMs) und Computer-Vision-Systeme zu trainieren. Ingenieure und Wissenschaftler führen komplexe Simulationen für die Wirkstoffentdeckung, Klimamodellierung und Materialwissenschaft durch. VFX-Studios und Spieleentwickler nutzen sie für fotorealistisches Rendering und Echtzeit-Grafikverarbeitung.

Auswahlkriterien

Bei der Auswahl eines Anbieters sollten Sie die spezifischen angebotenen GPU-Modelle und ihre Leistungsmetriken (VRAM, Kernanzahl) bewerten. Beurteilen Sie die Skalierbarkeit der Plattform und die Qualität ihrer Netzwerkverbindungen für Multi-GPU-Setups. Berücksichtigen Sie das verfügbare Software-Ökosystem und die Verwaltungstools, um Kompatibilität und Benutzerfreundlichkeit zu gewährleisten. Vergleichen Sie schließlich die Preismodelle, um die kostengünstigste Lösung für Ihre spezifischen Rechenanforderungen zu finden.

GPU-Infrastruktur use cases

1

Training von Großen KI-Modellen

Ein KI-Forschungsteam, das an einem neuen großen Sprachmodell (LLM) arbeitet, benötigt immense Rechenleistung. Anstatt eine millionenschwere Serverfarm zu kaufen und zu warten, nutzen sie einen Cloud-GPU-Infrastrukturanbieter. Sie stellen einen Cluster aus Hunderten von miteinander verbundenen NVIDIA H100 GPUs bereit. Mit einer vorkonfigurierten Umgebung mit PyTorch und verteilten Trainingsbibliotheken können sie ihr Modell in Wochen statt in Monaten trainieren. Das Pay-as-you-go-Modell ermöglicht es ihnen, die Ressourcen während intensiver Trainingsphasen hochzufahren und danach wieder herunterzufahren, um ihr Forschungsbudget zu optimieren.

2

Wissenschaftliches Hochleistungsrechnen

Ein universitäres Forschungslabor führt komplexe Strömungsdynamik-Simulationen zur Modellierung des Klimawandels durch. Diese Simulationen erfordern die Lösung partieller Differentialgleichungen über riesige Datensätze. Durch die Nutzung einer GPU-Infrastrukturplattform können Forscher auf Instanzen mit mehreren GPUs mit hohem VRAM zugreifen. Diese Fähigkeit zur parallelen Verarbeitung reduziert die Simulationszeiten von Monaten auf einem traditionellen CPU-Cluster auf nur wenige Tage. Sie können mehr Iterationen durchführen, verschiedene Hypothesen testen und ihre Ergebnisse schneller veröffentlichen, was die wissenschaftliche Entdeckung ohne einen dedizierten Supercomputer beschleunigt.

3

Fotorealistisches 3D-Rendering für VFX und Animation

Ein Studio für visuelle Effekte (VFX) arbeitet an einem Spielfilm mit hohen CGI-Anforderungen. Das Rendern eines einzelnen Frames kann auf einer lokalen Workstation Stunden dauern. Durch die Nutzung einer Cloud-GPU-Infrastruktur kann das Studio bei Bedarf eine Renderfarm mit Hunderten von GPU-Instanzen hochfahren. Sie übermitteln Render-Jobs an diese Farm, die die Frames parallel verarbeitet. Dies verkürzt die Renderzeit für ganze Sequenzen drastisch von Wochen auf einen einzigen Tag. Dies ermöglicht es den Künstlern, schneller an den Einstellungen zu iterieren und enge Produktionsfristen einzuhalten, während sie nur für die tatsächlich genutzte Rechenzeit bezahlen.

4

Beschleunigung von Big-Data-Analysen und -Verarbeitung

Ein Finanzdienstleistungsunternehmen muss täglich Terabytes an Marktdaten analysieren, um Handelsmuster zu erkennen. Die herkömmliche CPU-basierte Verarbeitung ist zu langsam, um zeitnahe Einblicke zu liefern. Sie setzen auf eine GPU-beschleunigte Analyseplattform, die auf einer Cloud-Infrastruktur läuft. Mit Bibliotheken wie RAPIDS, die beliebte Data-Science-APIs spiegeln, aber auf GPUs laufen, können ihre Datenwissenschaftler riesige Datensätze in Minuten statt in Stunden verarbeiten und visualisieren. Diese Beschleunigung ermöglicht eine Echtzeit-Risikobewertung und algorithmische Handelsstrategien, die zuvor unmöglich waren.

5

Entwicklung und Hosting von Cloud-Gaming-Diensten

Ein Startup möchte einen Cloud-Gaming-Dienst starten, der es Benutzern ermöglicht, High-End-Spiele auf jedes Gerät zu streamen. Dies erfordert leistungsstarke Server, die Spielgrafiken in Echtzeit rendern und die Videoausgabe mit geringer Latenz streamen können. Sie bauen ihren Dienst auf einer GPU-Infrastrukturplattform auf und verwenden Instanzen, die mit Gaming-GPUs ausgestattet sind. Dies ermöglicht es ihnen, Tausenden von gleichzeitigen Benutzern ein flüssiges, hochauflösendes Spielerlebnis zu bieten, ohne dass die Spieler teure Hardware besitzen müssen. Die globale Verfügbarkeit von Cloud-Regionen hilft ihnen auch, die Latenz für Spieler weltweit zu minimieren.

6

Computergestützte Wirkstoffentdeckung und Genomforschung

Ein Biotechnologieunternehmen sucht nach neuen Wirkstoffkandidaten, indem es Proteinfaltung und molekulares Docking simuliert. Diese Aufgaben sind auf Standardcomputern rechentechnisch unerschwinglich. Durch die Nutzung der GPU-Infrastruktur können ihre Computerchemiker massive parallele Simulationen an Tausenden von potenziellen Verbindungen gleichzeitig durchführen. Dies beschleunigt die Identifizierung vielversprechender Kandidaten für weitere Labortests von Jahren auf wenige Wochen. Die sichere und skalierbare Natur der Cloud-Plattform stellt auch sicher, dass ihre sensiblen Forschungsdaten geschützt sind, während die notwendige Rechenleistung bereitgestellt wird.

GPU-Infrastruktur FAQ

Was ist eine GPU-Infrastruktur?

GPU-Infrastruktur bezieht sich auf Cloud-Computing-Dienste, die On-Demand-Zugriff auf Server bieten, die mit leistungsstarken Grafikprozessoren (GPUs) ausgestattet sind. Im Gegensatz zu herkömmlichen CPU-basierten Servern ist diese Infrastruktur speziell für die Bewältigung massiv paralleler Verarbeitungsaufgaben konzipiert. Sie ist die grundlegende Technologie für anspruchsvolle Workloads wie das Training von künstlichen Intelligenzmodellen, die Durchführung komplexer wissenschaftlicher Simulationen und das hochauflösende Grafik-Rendering. Durch die Nutzung dieses Dienstes können Benutzer Rechenleistung mieten, ohne in teure physische Hardware investieren und diese warten zu müssen.

Was ist der Unterschied zwischen einer GPU-Infrastruktur und standardmäßigen CPU-basierten Cloud-Servern?

Der Hauptunterschied liegt in ihrer Architektur und ihrem Verwendungszweck. Standard-Cloud-Server verwenden CPUs (Central Processing Units), die sich hervorragend für sequentielle, allgemeine Aufgaben wie den Betrieb von Webservern oder Datenbanken eignen. Die GPU-Infrastruktur verwendet GPUs, die Tausende kleinerer Kerne enthalten, die darauf ausgelegt sind, viele Berechnungen gleichzeitig durchzuführen (parallele Verarbeitung). Dies macht GPUs für spezifische Workloads wie das Training von KI-Modellen, wissenschaftliches Rechnen und Grafik-Rendering außergewöhnlich schneller. Im Wesentlichen wählen Sie CPU-Server für breite, vielfältige Aufgaben und eine GPU-Infrastruktur für spezialisierte, rechenintensive, parallelisierbare Aufgaben.

Wie wähle ich die richtige GPU-Infrastruktur für mein Projekt aus?

Die Wahl der richtigen GPU-Infrastruktur erfordert mehrere wichtige Überlegungen. Identifizieren Sie zunächst die spezifischen Anforderungen Ihrer Arbeitslast: Trainieren Sie KI-Modelle, rendern Sie oder führen Sie Simulationen durch? Dies bestimmt das erforderliche GPU-Modell (z. B. NVIDIA A100 für das Training, RTX-Serie für das Rendern). Bewerten Sie als Nächstes Ihre Skalierbarkeitsanforderungen; benötigen Sie eine einzelne GPU oder einen Multi-GPU-Cluster? Berücksichtigen Sie auch das Software-Ökosystem und stellen Sie sicher, dass der Anbieter vorkonfigurierte Umgebungen mit den von Ihnen benötigten Treibern und Frameworks anbietet. Vergleichen Sie schließlich die Preismodelle (On-Demand, reserviert, Spot), um sie an Ihr Budget und Ihre Nutzungsmuster anzupassen. Es ist oft nützlich, mit einer kleineren Instanz zu beginnen, um die Leistung zu bewerten, bevor man sich für ein größeres Setup entscheidet.

Wer sind die Hauptnutzer der GPU-Infrastruktur?

Die Hauptnutzer der GPU-Infrastruktur sind Fachleute und Organisationen mit hohem Rechenbedarf. Dazu gehören:

  • KI/ML-Ingenieure und Datenwissenschaftler: Zum Trainieren und Bereitstellen von Deep-Learning-Modellen.
  • Forscher und Akademiker: Für wissenschaftliche Simulationen in Bereichen wie Physik, Biologie und Klimawissenschaft.
  • VFX-Künstler und Animatoren: Zum Rendern komplexer 3D-Szenen und Animationen.
  • Spieleentwickler: Zur Entwicklung und zum Hosting von Cloud-Gaming-Diensten.
  • Finanzanalysten (Quants): Zur Ausführung komplexer Risikomodelle und algorithmischer Handelssimulationen.
Im Allgemeinen kann jeder, dessen Arbeit durch die parallelen Verarbeitungskapazitäten herkömmlicher CPUs eingeschränkt wird, erheblich von der GPU-Infrastruktur profitieren.

Was sind die Hauptvorteile der Nutzung einer Cloud-GPU-Infrastruktur im Vergleich zum Kauf physischer Hardware?

Die Nutzung einer Cloud-GPU-Infrastruktur bietet mehrere entscheidende Vorteile gegenüber dem Kauf physischer Hardware. Die wichtigsten sind:

  • Kosteneffizienz: Es entfallen die hohen anfänglichen Kapitalausgaben für teure GPUs und Server-Hardware, die durch vorhersehbare Betriebskosten (Pay-as-you-go) ersetzt werden.
  • Skalierbarkeit: Sie können Ihre Rechenressourcen je nach Bedarf sofort hoch- oder herunterskalieren, was mit physischer Hardware unmöglich ist.
  • Zugang zu neuester Technologie: Cloud-Anbieter aktualisieren ständig ihre Hardware, sodass Sie Zugriff auf die neuesten und leistungsstärksten GPUs haben, ohne neue Geräte kaufen zu müssen.
  • Reduzierter Wartungsaufwand: Der Anbieter kümmert sich um die gesamte Hardwarewartung, Stromversorgung, Kühlung und Sicherheit, sodass sich Ihr Team auf seine Kernarbeit konzentrieren kann.
Diese Faktoren machen die Cloud-GPU-Infrastruktur für die meisten Anwendungsfälle zu einer flexibleren, skalierbareren und oft wirtschaftlicheren Wahl.