ToolMage
Anmelden

Best 3 Bibliotheken AI tools for Code

Popular Bibliotheken AI tools in Code include Sylph AI, LangUI und hyperficient, helping you work more efficiently.

Sylph AI
Freemium

Sylph AI

Sylph AI ist eine Entwicklungsplattform, die darauf ausgelegt ist, das Potenzial von LLM-Anwendungen zu maximieren. Sie bietet AdalFlow, eine führende Open-Source-Bibliothek zum Erstellen und automatischen Optimieren von LLM-Task-Pipelines, sowie einen KI-Teamkollegen, der während des gesamten Entwicklungsworkflows, von der Idee bis zur Produktion, fachkundige Anleitung bietet.

Bibliotheken
Visits 29.5KFavorites 178Likes 136
LangUI
Freemium

LangUI

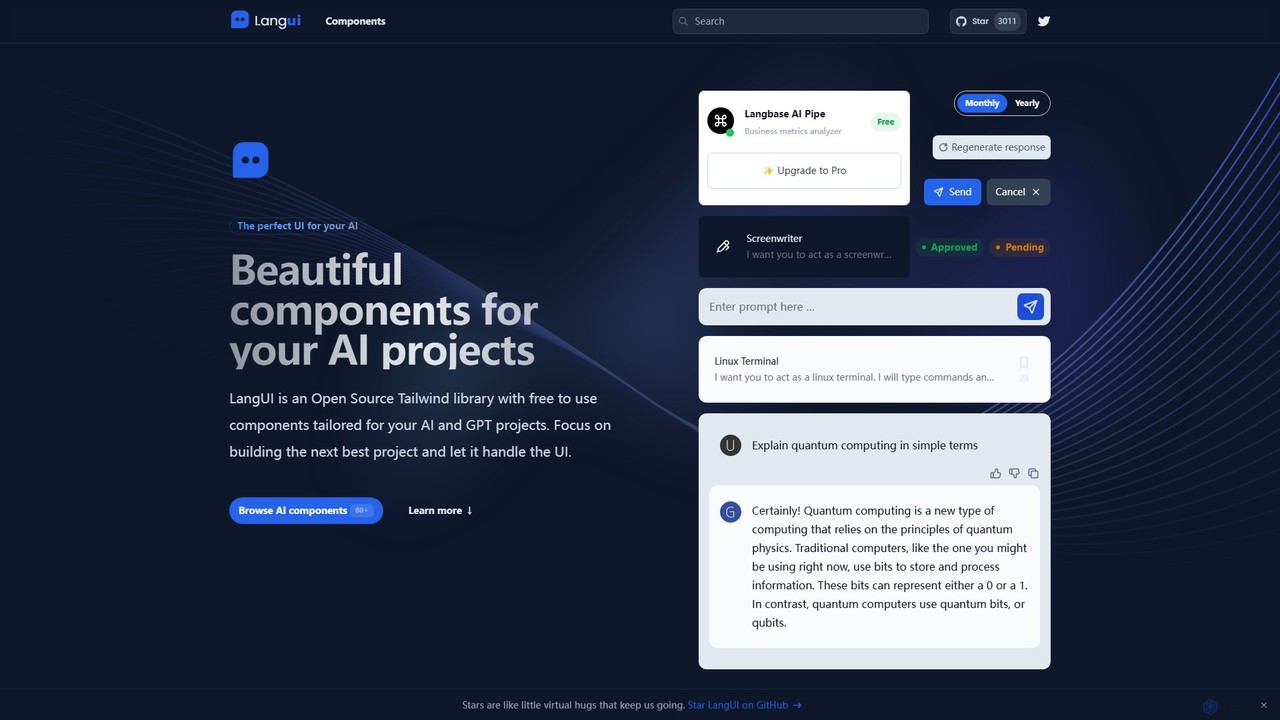
LangUI ist eine Open-Source-Komponentenbibliothek für Tailwind CSS, die über 60 kostenlose, sofort einsatzbereite Komponenten speziell für KI- und GPT-Projekte bietet. Sie hilft Entwicklern, schnell ansprechende und responsive Benutzeroberflächen für ihre KI-Anwendungen zu erstellen, sodass sie sich auf die Kernfunktionalität konzentrieren können.

Bibliotheken
Visits 7.5KFavorites 133Likes 165
hyperficient
Free

hyperficient

hyperficient ist ein Open-Source-KI-Tool für Entwickler und ML-Ingenieure, das die Suche nach den effizientesten Feinabstimmungsstrategien für neuronale Netze automatisiert. Es reduziert Rechenkosten, GPU-Zeit und manuellen Aufwand erheblich und ermöglicht eine optimale Modellleistung bei begrenzten Ressourcen.

Bibliotheken
Visits 6.2KFavorites 123Likes 134

About Bibliotheken

KI-Bibliotheken sind Sammlungen von vorprogrammiertem Code, Funktionen und Modulen, die Entwickler zum Erstellen von Anwendungen der künstlichen Intelligenz verwenden. Diese Bibliotheken abstrahieren komplexe mathematische und algorithmische Details und stellen gebrauchsfertige Tools für maschinelles Lernen, Deep Learning, natürliche Sprachverarbeitung und Computer Vision bereit. Durch den Einsatz von KI-Bibliotheken können Entwickler den Entwicklungszyklus erheblich beschleunigen und so eine schnelle Prototypenentwicklung und Bereitstellung ausgeklügelter KI-Lösungen in verschiedenen Bereichen ermöglichen.

Kernfunktionen

  • Vorgefertigte Algorithmen: Bieten Implementierungen gängiger Algorithmen für maschinelles Lernen und Deep Learning, wie Klassifizierung, Regression, Clustering und neuronale Netze.
  • Datenverarbeitung und -vorbereitung: Stellen Dienstprogramme zum Laden, Bereinigen, Transformieren und Erweitern von Datensätzen bereit, wesentliche Schritte zur Vorbereitung von Daten für KI-Modelle.
  • Modelltraining und -bewertung: Enthalten Funktionen zum Trainieren von KI-Modellen, Optimieren von Hyperparametern und Bewerten der Leistung mithilfe von Metriken wie Genauigkeit, Präzision und Recall.
  • Spezialisierte Module: Enthalten dedizierte Komponenten für spezifische KI-Aufgaben, wie Tokenisierung und Embeddings für NLP oder Objekterkennung und Bildsegmentierung für Computer Vision.
  • GPU-Beschleunigung: Werden oft in Hardware-Beschleuniger wie GPUs integriert, um rechenintensive Aufgaben, insbesondere im Deep Learning, zu beschleunigen.

Anwendungsszenarien

KI-Bibliotheken sind für Entwickler und Forscher, die an KI-gesteuerten Projekten arbeiten, unverzichtbar. Sie werden in der akademischen Forschung zum Experimentieren mit neuen Modellen, in Startups zur schnellen Prototypenentwicklung von KI-Funktionen und in großen Unternehmen zum Aufbau skalierbarer, produktionsreifer KI-Systeme eingesetzt. Von der Automatisierung der Datenanalyse bis zur Unterstützung intelligenter Anwendungen bilden diese Bibliotheken das Rückgrat der modernen KI-Entwicklung.

Auswahlkriterien

Berücksichtigen Sie bei der Auswahl einer KI-Bibliothek deren Kompatibilität mit Ihrem bestehenden Technologie-Stack und Ihrer Programmiersprache, wie Python oder R. Bewerten Sie den Funktionsumfang, den Community-Support und die Qualität der Dokumentation, die für die Fehlerbehebung und das Lernen entscheidend sind. Bewerten Sie die Leistung und Skalierbarkeit für Ihr spezifisches Datenvolumen und Ihre Rechenanforderungen und prüfen Sie, ob sie spezialisierte Tools für Ihren KI-Bereich, wie NLP oder Computer Vision, bietet.

Bibliotheken use cases

1

Aufbau einer maßgeschneiderten Empfehlungsmaschine

Ein E-Commerce-Entwickler nutzt KI-Bibliotheken wie scikit-learn oder TensorFlow, um große Mengen an Benutzer-Browsing-Verlauf, Kaufmustern und Produktattributen zu analysieren. Durch das Trainieren von Machine-Learning-Modellen mit diesen Daten kann der Entwickler eine personalisierte Empfehlungsmaschine erstellen, die einzelnen Kunden relevante Produkte vorschlägt, wodurch die Konversionsraten erheblich gesteigert und das Einkaufserlebnis verbessert werden. Dieser Prozess automatisiert die Entdeckung komplexer Beziehungen innerhalb der Kundendaten.

2

Entwicklung eines automatisierten Bilderkennungssystems

Das F&E-Team eines Sicherheitsunternehmens setzt Computer-Vision-Bibliotheken wie OpenCV und PyTorch ein, um ein automatisiertes Überwachungssystem zu entwickeln. Sie nutzen diese Bibliotheken, um Objekterkennungs- und Gesichtserkennungsalgorithmen zu implementieren, die es dem System ermöglichen, bestimmte Objekte, Personen oder ungewöhnliche Aktivitäten in Echtzeit-Video-Feeds zu identifizieren. Dies verbessert die Sicherheitsüberwachungsfunktionen erheblich, reduziert den Bedarf an ständiger menschlicher Aufsicht und verkürzt die Reaktionszeiten auf potenzielle Bedrohungen.

3

Erstellung eines Chatbots für natürliches Sprachverständnis (NLU)

Ein Kundenservice-Team nutzt NLP-Bibliotheken wie Hugging Face Transformers oder NLTK, um einen intelligenten Chatbot zu entwickeln, der komplexe Benutzeranfragen verstehen kann. Durch das Feinabstimmen vortrainierter Sprachmodelle kann der Chatbot die Benutzerabsicht genau interpretieren, Schlüsselinformationen extrahieren und relevante Antworten liefern, selbst bei nuancierter oder mehrdeutiger Sprache. Dies verbessert die Effizienz des Kundensupports erheblich, reduziert die Arbeitslast der Agenten und bietet rund um die Uhr Unterstützung.

4

Implementierung von vorausschauender Wartung für industrielles IoT

Ein Fertigungsingenieur integriert KI-Bibliotheken in eine industrielle IoT (IIoT)-Plattform, um Geräteausfälle vorherzusagen. Durch das Sammeln von Sensordaten von Maschinen und die Anwendung von Zeitreihenanalyse- und Anomalieerkennungsalgorithmen aus Bibliotheken wie Prophet oder scikit-learn kann das System subtile Abweichungen identifizieren, die auf bevorstehende Fehlfunktionen hinweisen. Dies ermöglicht eine proaktive Wartung, minimiert Ausfallzeiten, verlängert die Lebensdauer der Geräte und optimiert die Betriebskosten in intelligenten Fabriken.

5

Beschleunigung der Arzneimittelentdeckung durch Deep Learning

Biotechnologieforscher nutzen Deep-Learning-Bibliotheken wie PyTorch oder TensorFlow, um die Arzneimittelentdeckungsprozesse zu beschleunigen. Sie wenden diese Bibliotheken an, um komplexe molekulare Strukturen zu analysieren, Medikamenten-Ziel-Interaktionen vorherzusagen und riesige chemische Bibliotheken nach potenziellen therapeutischen Verbindungen zu durchsuchen. Dies reduziert den Zeit- und Kostenaufwand, der mit der traditionellen Arzneimittelentwicklung verbunden ist, erheblich, ermöglicht eine schnellere Identifizierung vielversprechender Kandidaten und fördert medizinische Durchbrüche.

6

Automatisierung der Finanzbetrugserkennung

Ein Fintech-Entwickler integriert KI-Bibliotheken in sein Transaktionsüberwachungssystem, um die Betrugserkennung zu automatisieren. Durch die Verwendung von Bibliotheken wie scikit-learn zur Anomalieerkennung oder TensorFlow zur Deep-Learning-basierten Mustererkennung kann das System Millionen von Transaktionen in Echtzeit analysieren und verdächtige Aktivitäten identifizieren, die vom normalen Verhalten abweichen. Dieser proaktive Ansatz hilft Finanzinstituten, betrügerische Transaktionen zu verhindern, Kundenvermögen zu schützen und regulatorische Anforderungen effektiver zu erfüllen.

Bibliotheken FAQ

Was sind KI-Bibliotheken?

KI-Bibliotheken sind Sammlungen von vorprogrammiertem Code und Funktionen, die die Entwicklung von Anwendungen der künstlichen Intelligenz vereinfachen. Sie bieten gebrauchsfertige Implementierungen von Algorithmen und Tools für verschiedene KI-Aufgaben wie maschinelles Lernen, Deep Learning, natürliche Sprachverarbeitung und Computer Vision. Zu ihren Kernmerkmalen gehören Modularität, umfangreiche Dokumentation und Community-Support, die es Entwicklern ermöglichen, komplexe KI-Systeme zu erstellen, ohne bei Null anfangen zu müssen.

Wie unterscheiden sich KI-Bibliotheken von KI-Frameworks?

KI-Bibliotheken und KI-Frameworks unterstützen beide die KI-Entwicklung, unterscheiden sich jedoch in Umfang und Kontrolle. Eine KI-Bibliothek, wie scikit-learn, bietet spezifische Funktionen oder Module, die Entwickler nach Bedarf aufrufen, was mehr Flexibilität und Kontrolle über den Anwendungsfluss ermöglicht. Ein KI-Framework, wie TensorFlow oder PyTorch, bietet eine umfassendere Struktur, die die Gesamtarchitektur und den Fluss einer Anwendung vorgibt und oft erfordert, dass Entwickler innerhalb ihrer vordefinierten Komponenten arbeiten. Frameworks sind typischerweise größer und vorschreibender, während Bibliotheken fokussierter und anpassungsfähiger sind.

Was sind die Hauptvorteile der Verwendung von KI-Bibliotheken?

Die Verwendung von KI-Bibliotheken bietet Entwicklern mehrere entscheidende Vorteile. Erstens beschleunigen sie die Entwicklung erheblich, indem sie vorgefertigte, optimierte Algorithmen und Funktionen bereitstellen, wodurch die Notwendigkeit, komplexen Code von Grund auf neu zu schreiben, reduziert wird. Zweitens senken sie die technische Einstiegshürde für die KI-Entwicklung, sodass mehr Entwickler KI-gestützte Anwendungen erstellen können. Drittens sind viele Bibliotheken Open Source mit aktiven Communities, die umfangreiche Dokumentation, Tutorials und Support bieten, was das Lernen und die Problemlösen fördert. Schließlich integrieren sie sich oft in die Hardwarebeschleunigung, was die Leistung bei rechenintensiven Aufgaben steigert.

Welche KI-Bibliotheken werden heute am häufigsten verwendet?

Mehrere KI-Bibliotheken dominieren die aktuelle Entwicklungslandschaft aufgrund ihrer Robustheit, umfangreichen Funktionen und starken Community-Unterstützung. TensorFlow und PyTorch sind führende Deep-Learning-Bibliotheken, die häufig für komplexe neuronale Netzwerkarchitekturen verwendet werden. Scikit-learn ist eine beliebte Wahl für traditionelle Machine-Learning-Aufgaben und bietet eine breite Palette von Algorithmen für Klassifizierung, Regression und Clustering. Für die natürliche Sprachverarbeitung werden Hugging Face Transformers und NLTK sehr bevorzugt, während OpenCV die erste Wahl für Computer-Vision-Anwendungen ist. Diese Bibliotheken befähigen Entwickler gemeinsam, vielfältige KI-Herausforderungen zu bewältigen.

Wie wähle ich die richtige KI-Bibliothek für mein Projekt aus?

Die Auswahl der richtigen KI-Bibliothek erfordert die Bewertung mehrerer projektspezifischer Faktoren. Berücksichtigen Sie zunächst den spezifischen KI-Bereich Ihres Projekts (z. B. NLP, Computer Vision, traditionelles ML) und wählen Sie eine Bibliothek, die in diesem Bereich für ihre Exzellenz bekannt ist. Zweitens bewerten Sie deren Kompatibilität mit Ihrer bevorzugten Programmiersprache und Ihrem bestehenden Technologie-Stack. Drittens prüfen Sie den Community-Support, die Qualität der Dokumentation und die aktive Entwicklung der Bibliothek, da diese für die langfristige Wartbarkeit und Fehlerbehebung entscheidend sind. Schließlich bewerten Sie deren Leistung, Skalierbarkeit und Benutzerfreundlichkeit, um sicherzustellen, dass sie die technischen und betrieblichen Anforderungen Ihres Projekts erfüllt.