ToolMage
Anmelden

Best 2 Datengenerierung AI tools for Daten

Popular Datengenerierung AI tools in Daten include ezML und Neosync, helping you work more efficiently.

Neosync
Freemium

Neosync

Neosync ist eine Open-Source-Plattform zur Datenanonymisierung und Generierung synthetischer Daten. Sie hilft Entwicklern und Datenwissenschaftlern, sichere, datenschutzkonforme und realistische Datensätze für Tests, Entwicklung und das Training von KI-Modellen zu erstellen und gewährleistet dabei die referenzielle Integrität über Datenbanken hinweg.

Datengenerierung
Visits 6.5KFavorites 117Likes 119
ezML
Paid

ezML

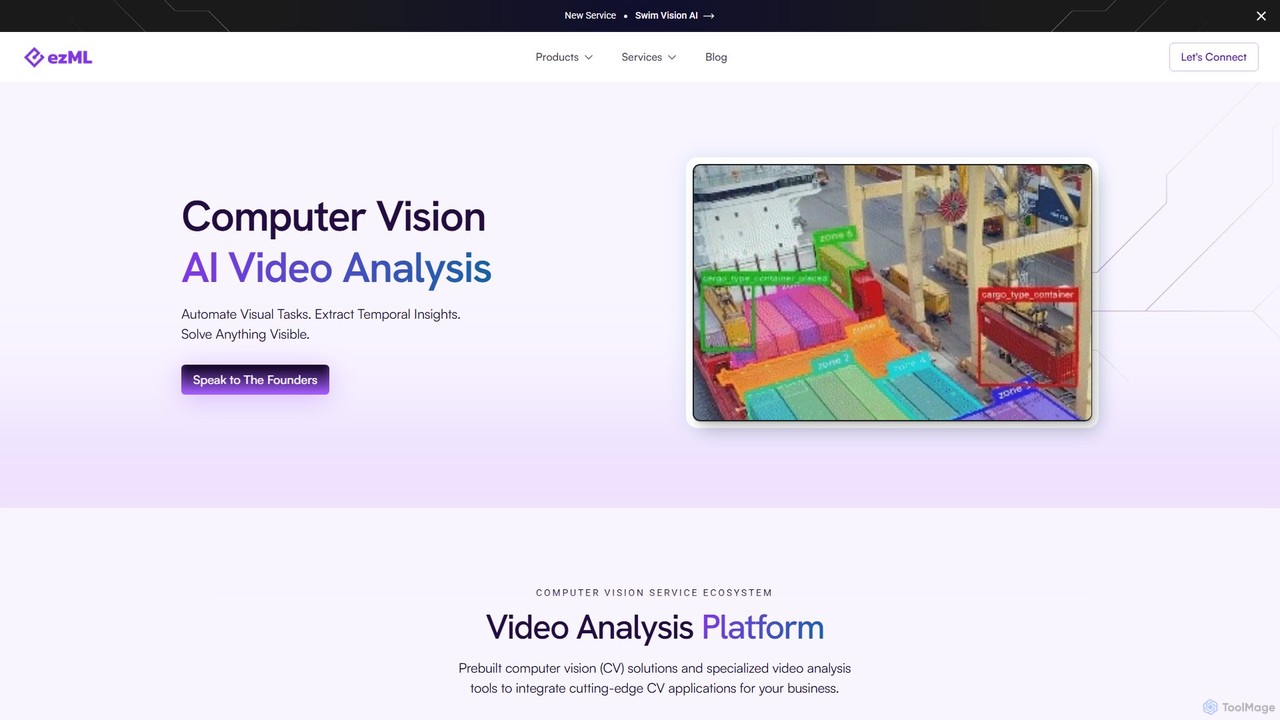
ezML ist eine unternehmenstaugliche Computer-Vision-Plattform, die auf fortschrittliche Videoanalyse spezialisiert ist. Sie bietet eine Reihe von Werkzeugen, darunter vorgefertigte Modelle, multimodale Suche, synthetische Datengenerierung und maßgeschneiderte CV-Lösungen. Mit einem starken Fokus auf Sportanalytik, wie seiner Swim Vision AI, hilft ezML Unternehmen, visuelle Aufgaben zu automatisieren, tiefe Einblicke aus Videodaten zu gewinnen und leistungsstarke, skalierbare CV-Anwendungen bereitzustellen.

Datengenerierung
Visits 8.6KFavorites 130Likes 142

About Datengenerierung

Daten-Generierungs-Tools sind KI-gestützte Lösungen, die neue, synthetische Datensätze erstellen. Diese Tools nutzen fortschrittliche Algorithmen, oft einschließlich Generativer Adversarial Networks (GANs) oder Variational Autoencoders (VAEs), um Daten zu produzieren, die die statistischen Eigenschaften und Muster realer Daten widerspiegeln. Sie sind entscheidend, um Datenknappheit zu begegnen, den Datenschutz zu verbessern und vielfältige, unvoreingenommene Datensätze für das Training und Testen von Machine-Learning-Modellen zu generieren. Durch die Simulation komplexer Datenverteilungen ermöglichen sie eine robuste Entwicklung, ohne sich ausschließlich auf sensible oder begrenzte reale Daten verlassen zu müssen.

Kernfunktionen

  • Synthetische Datenerstellung: Generiert realistische, statistisch ähnliche Datenpunkte über verschiedene Modalitäten wie Bilder, Text oder tabellarische Daten.
  • Datenschutz: Erstellt Daten, die den analytischen Nutzen bewahren, während sensible Informationen anonymisiert oder geschützt werden.
  • Datenerweiterung: Erweitert bestehende Datensätze mit vielfältigen Variationen, um die Robustheit und Generalisierungsfähigkeit des Modells zu verbessern.
  • Bias-Minderung: Generiert ausgewogene Datensätze, um inhärente Verzerrungen in realen Daten zu reduzieren, was zu faireren KI-Modellen führt.
  • Anpassbare Parameter: Bietet Kontrollen zur Spezifikation von Datenmerkmalen, Volumen, Verteilung und spezifischen Generierungsszenarien.

Anwendungsszenarien

Daten-Generierungs-Tools werden von Machine-Learning-Ingenieuren, Datenwissenschaftlern und Softwaretestern weit verbreitet eingesetzt. Sie sind unerlässlich für das Training robuster KI-Modelle in datenarmen Domänen, die Erstellung realistischer Testdaten für Anwendungen ohne Kompromittierung der Privatsphäre und die Produktion anonymisierter Datensätze für die Compliance in regulierten Branchen wie dem Gesundheitswesen und dem Finanzsektor.

Auswahlkriterien

Bei der Auswahl eines Daten-Generierungs-Tools sollten Sie den erforderlichen Datentyp und die Datenqualität berücksichtigen, um sicherzustellen, dass es Daten mit ausreichender Realismus für Ihren Anwendungsfall produzieren kann. Bewerten Sie seine Datenschutz- und Sicherheitsfunktionen für sensible Informationen und beurteilen Sie seine Skalierbarkeit und Leistung für die effiziente Generierung großer Datenmengen. Überprüfen Sie schließlich die Anpassungsoptionen, um Datenmerkmale und spezifische Szenarien zu steuern.

Datengenerierung use cases

1

Synthetische Bilddaten für das KI-Modelltraining generieren

Maschinenlern-Ingenieure benötigen große Mengen vielfältiger Bilddaten, um Computer-Vision-Modelle zu trainieren, doch die Sammlung realer Daten ist kostspielig und oft durch Datenschutzbestimmungen eingeschränkt. Daten-Generierungs-Tools können basierend auf einer kleinen Menge realer Bilder oder spezifischer Beschreibungen automatisch Millionen synthetischer Bilder mit unterschiedlichen Hintergründen, Beleuchtungen, Posen und Merkmalen erstellen. Dies löst nicht nur die Datenknappheit, sondern verbessert auch die Generalisierungsfähigkeit und Robustheit des Modells in realen Anwendungen durch die Einführung von Vielfalt, wodurch der Modellentwicklungszyklus erheblich beschleunigt wird.

2

Datenschutzkonforme Kundentransaktions-Testdaten erstellen

Finanzinstitute benötigen große Mengen an Kundentransaktionsdaten für Funktions- und Leistungstests bei der Entwicklung neuer Produkte oder Systeme. Die Verwendung realer Kundendaten birgt jedoch strenge Risiken hinsichtlich der Einhaltung des Datenschutzes. Daten-Generierungs-Tools können basierend auf den statistischen Mustern bestehender Transaktionsdaten vollständig anonyme synthetische Transaktionsdaten mit derselben Struktur und denselben Merkmalen erzeugen. Dies ermöglicht Entwicklungsteams, umfassende Tests in einer sicheren und konformen Umgebung durchzuführen, Datenlecks zu vermeiden und gleichzeitig die Testeffektivität sicherzustellen.

3

Automatisierte Generierung von Benutzerverhaltensdaten für Softwaretests

Softwaretester müssen verschiedene Benutzerinteraktionsverhaltensweisen innerhalb einer Anwendung für UI- (Benutzeroberfläche) und UX-Tests (Benutzererfahrung) simulieren. Das manuelle Erstellen dieser komplexen Verhaltenspfade ist zeitaufwändig und deckt oft nicht alle Grenzfälle ab. Daten-Generierungs-Tools können basierend auf voreingestellten Benutzerverhaltensmustern oder historischen Protokollen automatisch synthetische Daten generieren, die eine Reihe von Benutzeraktionen wie Klicks, Eingaben und Navigation simulieren. Dies erhöht die Testabdeckung und Effizienz erheblich und hilft, potenzielle Fehler und Leistungsengpässe aufzudecken.

4

Erweiterung von Textdatensätzen mit geringen Ressourcen zur Verbesserung der NLP-Modellleistung

Modelle zur Verarbeitung natürlicher Sprache (NLP) leiden oft unter unzureichenden Daten in ressourcenarmen Sprachen oder spezifischen Domänen (z. B. Recht, Medizin), was zu einer schlechten Modellleistung führt. Inhaltsersteller oder KI-Forscher können Daten-Generierungs-Tools nutzen, um große Mengen grammatikalisch korrekter, semantisch kohärenter synthetischer Textdaten basierend auf einer kleinen Menge von Seed-Texten und linguistischen Regeln zu erzeugen. Diese Daten können zum Vortrainieren oder Feinabstimmen von NLP-Modellen verwendet werden, wodurch Datenknappheit effektiv gemindert und die Genauigkeit von Aufgaben wie Übersetzung, Stimmungsanalyse und Q&A-Systemen in ressourcenarmen Sprachumgebungen erheblich verbessert wird.

5

Vielfältige Sensorsimulationsdaten für autonome Fahrsysteme generieren

Die Entwicklung autonomer Fahrzeuge erfordert riesige Mengen an Sensordaten (z. B. Radar, Lidar, Kameras), um Wahrnehmungs- und Entscheidungsmodelle zu trainieren. Die Sammlung realer Daten ist extrem kostspielig und es ist schwierig, alle extremen oder seltenen Szenarien abzudecken. Daten-Generierungs-Tools können komplexe Verkehrsumgebungen, Wetterbedingungen und Hindernisse simulieren und realistische synthetische Sensordaten erzeugen. Dies ermöglicht Ingenieuren, autonome Fahr-Algorithmen in virtuellen Umgebungen sicher und effizient zu testen und zu validieren, wodurch die technologische Iteration beschleunigt und die Sicherheit verbessert wird.

6

Fehlende Daten ergänzen oder Datensätze ausgleichen, um Modellverzerrungen zu reduzieren

Viele reale Datensätze leiden unter fehlenden Daten oder Klassenungleichgewichten, was zu voreingenommenen oder leistungsschwachen KI-Modellen führen kann. Datenanalysten und Datenwissenschaftler können Daten-Generierungs-Tools verwenden, um fehlende Werte intelligent zu ergänzen oder synthetische Daten für Minderheitsklassen basierend auf bestehenden Datenverteilungsmustern zu generieren. Durch die Erstellung vollständigerer und ausgewogenerer Datensätze reduzieren diese Tools effektiv Verzerrungen im Modelltraining und verbessern die Fairness und Vorhersagegenauigkeit von Modellen, was besonders in Bereichen wie der medizinischen Diagnose oder der Finanzrisikobewertung entscheidend ist.

Datengenerierung FAQ

Was sind KI-Daten-Generierungs-Tools?

KI-Daten-Generierungs-Tools sind Softwareanwendungen, die künstliche Intelligenz, wie generative Modelle, nutzen, um neue, synthetische Daten zu erstellen. Diese Tools produzieren Daten, die statistisch reale Daten nachahmen und Herausforderungen wie Datenknappheit, Datenschutzbedenken und den Bedarf an vielfältigen Datensätzen adressieren. Sie werden hauptsächlich zum Trainieren von Machine-Learning-Modellen, zum Testen von Software und zur Ermöglichung des Datenaustauschs in sensiblen Umgebungen eingesetzt.

Wie unterscheiden sich Daten-Generierungs-Tools von Daten-Augmentierungs-Tools?

Daten-Generierungs-Tools erstellen basierend auf gelernten Mustern aus vorhandenen Daten völlig neue Datenpunkte von Grund auf. Zum Beispiel die Generierung eines völlig neuen synthetischen Bildes einer Katze. Daten-Augmentierung hingegen modifiziert vorhandene reale Daten, um Variationen zu erzeugen, wie das Drehen eines Bildes, das Hinzufügen von Rauschen oder das Ändern von Textsynonymen. Während beide Datensätze erweitern, erzeugt die Generierung neue Instanzen, während die Augmentierung bestehende transformiert. Daten-Generierung kann als eine fortgeschrittenere Form der Datenerweiterung angesehen werden.

Welche Arten von Daten können KI-Daten-Generierungs-Tools erstellen?

KI-Daten-Generierungs-Tools sind äußerst vielseitig und können eine breite Palette von Datentypen erstellen. Dazu gehören tabellarische Daten (z. B. Finanzaufzeichnungen, Kundendemografien), Bilddaten (z. B. Gesichter, Objekte, medizinische Scans, Satellitenbilder), Textdaten (z. B. Produktbewertungen, Artikel, Code-Snippets), Audiodaten (z. B. Sprache, Umgebungsgeräusche) und Zeitreihendaten (z. B. Sensorwerte, Aktienkurse). Entscheidend ist, dass die generierten Daten die statistischen Eigenschaften und den Realismus ihrer realen Gegenstücke beibehalten.

Was sind die Hauptvorteile der Verwendung von KI-generierten synthetischen Daten?

Die Hauptvorteile der Verwendung von KI-generierten synthetischen Daten sind zahlreich. Erstens verbessert es den Datenschutz, indem es realistische Datensätze bereitstellt, ohne sensible reale Informationen preiszugeben, was für die Compliance entscheidend ist. Zweitens begegnet es der Datenknappheit, indem es Entwicklern ermöglicht, robuste Modelle zu trainieren, selbst wenn reale Daten begrenzt sind. Drittens hilft es, Verzerrungen zu mindern, indem es die Erstellung ausgewogener Datensätze ermöglicht. Darüber hinaus können synthetische Daten schneller und kostengünstiger generiert werden als das Sammeln und Annotieren realer Daten, und sie bieten sichere Umgebungen zum Testen komplexer Systeme.

Sind KI-generierte synthetische Daten für das Modelltraining so gut wie reale Daten?

KI-generierte synthetische Daten können für das Modelltraining in bestimmten Kontexten genauso gut oder sogar besser sein als reale Daten. Für Aufgaben, bei denen der Datenschutz von größter Bedeutung ist oder reale Daten knapp sind, bieten synthetische Daten eine praktikable und oft bevorzugte Alternative. Ihre Qualität hängt stark von der Komplexität des Generierungsmodells und der Komplexität der realen Daten ab, die es nachahmt. Obwohl synthetische Daten möglicherweise nicht jede Nuance oder jeden Grenzfall realer Daten erfassen, zeichnen sie sich durch die Bereitstellung vielfältiger, unvoreingenommener und skalierbarer Datensätze aus, was sie besonders effektiv für die Verbesserung der Modellrobustheit und Generalisierung macht, insbesondere wenn sie in Verbindung mit realen Daten verwendet werden.