ToolMage
Anmelden

Best 4 Datenverarbeitung AI tools for Daten

Popular Datenverarbeitung AI tools in Daten include Graphlit, Cloudglue, baselinetrials und JSON Scout, helping you work more efficiently.

Graphlit
Freemium

Graphlit

Graphlit ist eine entwicklerorientierte Wissens-API-Plattform zur Erstellung von KI-Anwendungen und -Agenten. Sie optimiert die Aufnahme, Speicherung und den Abruf unstrukturierter Daten aus beliebigen Quellen und bietet eine leistungsstarke RAG-as-a-Service-Lösung. Mit SDKs für gängige Sprachen und Tools zur Integration von KI-Agenten vereinfacht sie die Erstellung anspruchsvoller KI-Systeme.

Lappen
Visits 17.7KFavorites 157Likes 131
baselinetrials
Paid

baselinetrials

Eine KI-Plattform für die klinische Forschung, die die Erstellung von validierungsbereiten SDTM- und ADaM-Datensätzen automatisiert. Sie reduziert die Zeit von der Datenbanksperre bis zur FDA-Einreichung drastisch, indem sie komplexe Programmieraufgaben übernimmt, sodass sich klinische Teams auf hochwertige, studienspezifische Logik konzentrieren können, während Datensicherheit und HIPAA-Konformität gewährleistet sind.

Datenverarbeitung
Visits 6.4KFavorites 186Likes 165
JSON Scout
Freemium

JSON Scout

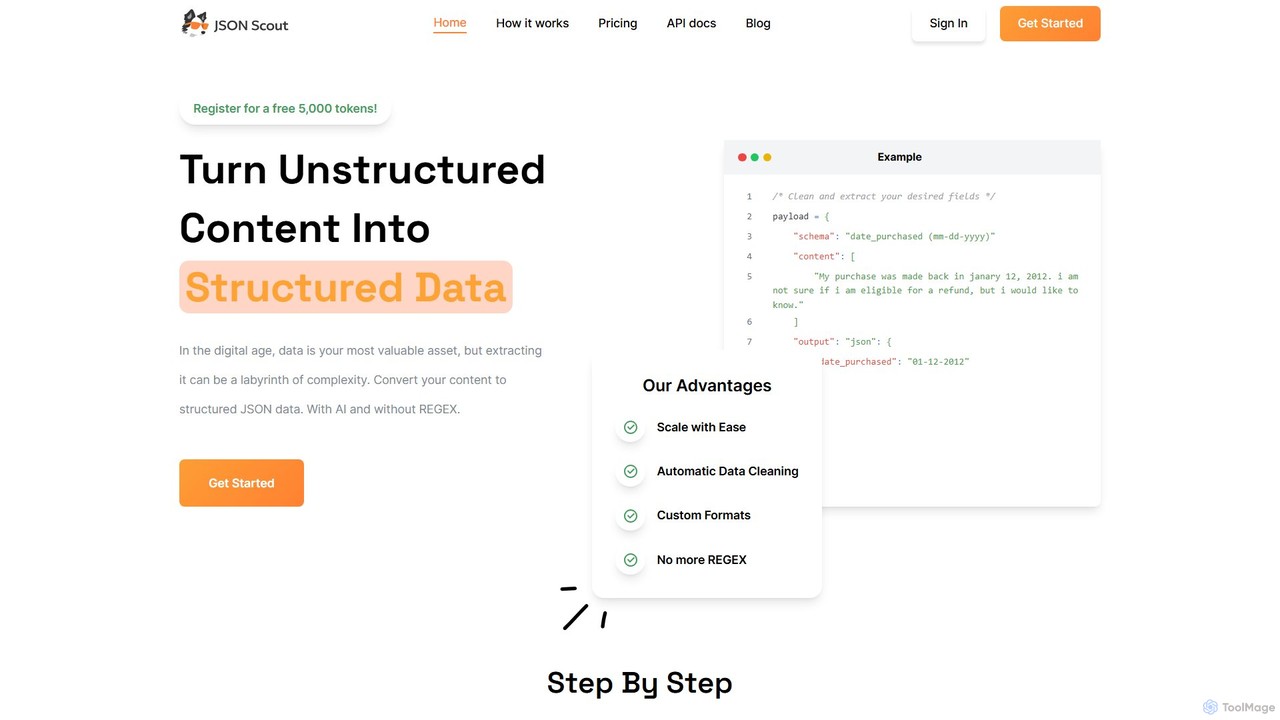
JSON Scout ist eine KI-gestützte API für Entwickler, die unstrukturierte Text- und Audioinhalte in strukturierte JSON-Daten umwandelt. Es nutzt große Sprachmodelle (LLMs) wie GPT-4o, um die Notwendigkeit komplexer regulärer Ausdrücke (REGEX) zu eliminieren, Entwicklungszeit zu sparen und die Genauigkeit der Datenextraktion zu verbessern.

Datenverarbeitung
Visits 6.3KFavorites 152Likes 151
Cloudglue
Freemium

Cloudglue

Cloudglue ist eine auf Entwickler ausgerichtete KI-Plattform, die Videodateien in strukturierte, LLM-fähige Daten umwandelt. Sie ermöglicht die Erstellung leistungsstarker KI-Anwendungen wie videobasierter RAG-Systeme, Chatbots und aufschlussreicher Analysen. Mit einer einfachen API bewältigt sie die Videoverarbeitung, Transkription und multimodale Analyse, sodass Entwickler Videowissen mühelos in ihre Produkte integrieren können.

Datenverarbeitung
Visits 12.3KFavorites 130Likes 166

About Datenverarbeitung

KI-Datenverarbeitungstools sind eine Klasse von Software, die entwickelt wurde, um Rohdaten für Analysen oder maschinelles Lernen automatisch zu bereinigen, zu transformieren und zu strukturieren. Diese Tools nutzen Algorithmen für Aufgaben wie Anomalieerkennung, Datennormalisierung und Feature-Engineering, um Datensätze nutzbar zu machen. Sie sind entscheidend für die Aufbereitung großer, unstrukturierter Datensätze und reduzieren den manuellen Aufwand in Data-Science-Workflows erheblich. Ihr Hauptvorteil liegt in der Beschleunigung der gesamten Datenpipeline, von der Rohdateneingabe bis zu handlungsorientierten Erkenntnissen.

Kernfunktionen

  • Automatisierte Datenbereinigung: Identifiziert und korrigiert Fehler, Duplikate und fehlende Werte in Datensätzen.
  • Datentransformation & -normalisierung: Konvertiert Daten in ein konsistentes Format und eine einheitliche Skala, die für Analysen und Modellierung geeignet sind.
  • Feature-Engineering: Erstellt automatisch neue, relevante Merkmale aus vorhandenen Daten, um die Modellleistung zu verbessern.
  • Verarbeitung unstrukturierter Daten: Extrahiert strukturierte Informationen aus Text, Bildern oder anderen unstrukturierten Quellen.
  • ETL-Automatisierung: Optimiert den Prozess des Extrahierens, Transformierens und Ladens von Daten in ein Zielsystem.

Anwendungsfälle

Diese Tools sind für Datenwissenschaftler, Geschäftsanalysten und Ingenieure für maschinelles Lernen in Branchen wie Finanzen, Gesundheitswesen und E-Commerce unerlässlich. Ein Finanzanalyst könnte sie beispielsweise zur Bereinigung und Standardisierung von Transaktionsdaten für die Betrugserkennung verwenden, während ein E-Commerce-Unternehmen Nutzerverhaltensdaten für eine Empfehlungs-Engine aufbereiten könnte.

Wie man wählt

Berücksichtigen Sie bei der Auswahl eines Tools die Unterstützung verschiedener Datenquellen (Datenbanken, APIs, Dateien), die Komplexität der durchführbaren Transformationen und die Integrationsmöglichkeiten mit Ihrem bestehenden Daten-Stack, wie BI-Tools oder ML-Plattformen. Bewerten Sie auch die Skalierbarkeit für die Verarbeitung großer Datenmengen und ob die Benutzeroberfläche (codebasiert, Low-Code oder visuell) den technischen Fähigkeiten Ihres Teams entspricht.

Datenverarbeitung use cases

1

Aufbereitung von Kundendaten für die Marketingsegmentierung

Ein Marketinganalyst hat die Aufgabe, gezielte Kampagnen zu erstellen, sieht sich jedoch mit inkonsistenten und mit Duplikaten gefüllten Rohdaten aus CRM, Webanalyse und Vertriebssystemen konfrontiert. Mit einem KI-Datenverarbeitungstool kann er diese unterschiedlichen Quellen zusammenführen, Datensätze automatisch auf der Grundlage von Fuzzy-Matching deduplizieren, Adressformate standardisieren und Profile mit berechneten Feldern wie dem „Customer Lifetime Value“ anreichern. Dieser Prozess verwandelt eine chaotische Datensammlung in einen sauberen, einheitlichen Kundendatensatz, der eine genaue Segmentierung und hochgradig personalisierte Marketingmaßnahmen ermöglicht.

2

Bereinigung von Sensordaten für die vorausschauende IoT-Wartung

Ein Datenwissenschaftler in einer Produktionsanlage muss ein Modell für die vorausschauende Wartung erstellen. Die Streaming-Daten von den Sensoren in der Fabrikhalle sind jedoch verrauscht, enthalten aufgrund von Netzwerkproblemen fehlende Werte und weisen gelegentlich Ausreißer auf. Ein KI-Datenverarbeitungstool kann so konfiguriert werden, dass es Echtzeitfilter zur Glättung der Daten anwendet, hochentwickelte Imputationsalgorithmen zur intelligenten Füllung von Lücken verwendet und Anomalien, die auf eine Gerätestörung hindeuten könnten, automatisch erkennt und markiert. Dies führt zu einem hochwertigen, sauberen Zeitreihendatensatz, der die Genauigkeit und Zuverlässigkeit der vorausschauenden Wartungsmodelle erheblich verbessert.

3

Strukturierung von unstrukturiertem Text für die Sentimentanalyse

Ein Business-Intelligence-Analyst muss Tausende von Kundenbewertungen aus sozialen Medien und Support-Tickets analysieren. Dieser Rohtext ist unstrukturiert und schwer zu quantifizieren. Durch die Eingabe dieser Daten in ein KI-Verarbeitungstool kann der Analyst automatisch Aufgaben wie die Korrektur von Tippfehlern, die Erweiterung von Abkürzungen und die Extraktion von Schlüsselentitäten (z. B. Produktnamen, Standorte) durchführen. Das Tool strukturiert diesen bereinigten Text dann in einer Tabelle mit Spalten für die ursprüngliche Bewertung, den Sentiment-Score und identifizierte Themen. Dies wandelt qualitatives Feedback in einen quantifizierbaren Datensatz um und ermöglicht eine groß angelegte Trendanalyse und Berichterstattung.

4

Automatisierung des Abgleichs von Finanzdaten

Das Team eines Finanzcontrollers verbringt jeden Monat Dutzende von Stunden damit, Transaktionen aus mehreren Banksystemen, Rechnungen im PDF-Format und Spesenabrechnungen im CSV-Format manuell abzugleichen. Ein KI-Datenverarbeitungstool automatisiert dies, indem es Daten aus diesen unterschiedlichen Formaten extrahiert, Felder wie Daten und Währungscodes standardisiert und Transaktionen systemübergreifend mithilfe erlernter Regeln intelligent abgleicht. Das Tool kann Abweichungen zur menschlichen Überprüfung kennzeichnen und den manuellen Aufwand um über 90 % reduzieren. Dies beschleunigt nicht nur den monatlichen Abschlussprozess, sondern erhöht auch die Genauigkeit erheblich, indem menschliche Fehler eliminiert werden.

5

Normalisierung von Gesundheitsakten für die klinische Forschung

Ein klinischer Forscher muss für eine Studie Patientendaten aus verschiedenen Krankenhäusern analysieren. Die Daten kommen in unterschiedlichen Formaten, mit verschiedenen medizinischen Kodierungssystemen (z. B. ICD-9 vs. ICD-10) und inkonsistenten Einheiten für Laborergebnisse an. Ein KI-Datenverarbeitungstool kann verwendet werden, um verschiedene medizinische Codes auf eine Standardontologie abzubilden, Laborwerteinheiten auf eine gemeinsame Skala (z. B. mg/dL) zu normalisieren und personenbezogene Daten (PII) automatisch zu erkennen und zu schwärzen, um die Einhaltung von Vorschriften zu gewährleisten. Dies schafft einen standardisierten, anonymisierten und analysebereiten Datensatz, der institutsübergreifende Forschung machbar und zuverlässig macht.

6

Feature-Engineering für E-Commerce-Empfehlungsmaschinen

Ein Ingenieur für maschinelles Lernen möchte die Genauigkeit eines Produktempfehlungsmodells verbessern. Die rohen Nutzerverhaltensdaten (Klicks, Käufe, Verweildauer auf der Seite) müssen in aussagekräftige Merkmale umgewandelt werden. Ein KI-Datenverarbeitungstool kann das Feature-Engineering automatisieren, indem es neue Variablen wie „Zeit seit dem letzten Kauf“, „durchschnittliche Sitzungsdauer“, „Affinität zur Produktkategorie“ oder „Kaufhäufigkeit“ generiert. Das Tool kann Hunderte solcher Kandidatenmerkmale erstellen, was manuell extrem zeitaufwändig wäre. Dieser angereicherte Merkmalsatz liefert dem Modell mehr prädiktive Signale, was zu relevanteren Empfehlungen und höheren Umsätzen führt.

Datenverarbeitung FAQ

Was sind KI-Datenverarbeitungstools?

KI-Datenverarbeitungstools sind Anwendungen, die künstliche Intelligenz nutzen, um die Bereinigung, Transformation und Aufbereitung von Rohdaten zu automatisieren. Im Gegensatz zu herkömmlichen ETL-Tools (Extrahieren, Transformieren, Laden) setzen sie maschinelles Lernen für fortgeschrittenere Aufgaben ein, wie das Erkennen komplexer Muster, das intelligente Imputieren fehlender Werte und das Parsen unstrukturierter Daten aus Quellen wie Text oder Bildern. Ihr Hauptzweck ist es, die Erstellung hochwertiger, analysebereiter Datensätze zu beschleunigen und den manuellen Aufwand bei der Datenaufbereitung erheblich zu reduzieren.

Wie wähle ich das richtige KI-Datenverarbeitungstool aus?

Um das richtige Tool auszuwählen, bewerten Sie diese Schlüsselfaktoren:

  • Datenkonnektivität: Stellen Sie sicher, dass es sich mit all Ihren erforderlichen Datenquellen wie Datenbanken, Cloud-Speicher, APIs und verschiedenen Dateiformaten verbinden kann.
  • Transformationsfähigkeiten: Beurteilen Sie, ob seine Funktionen Ihrer Datenkomplexität entsprechen, von der einfachen Bereinigung und Formatierung bis hin zum fortgeschrittenen Feature-Engineering.
  • Skalierbarkeit: Prüfen Sie, ob es Ihre aktuellen und prognostizierten zukünftigen Datenmengen ohne Leistungseinbußen effizient verarbeiten kann.
  • Benutzeroberfläche: Entscheiden Sie sich zwischen einer Code-First-, Low-Code- oder No-Code-visuellen Oberfläche, basierend auf den technischen Fähigkeiten und Workflow-Präferenzen Ihres Teams.
  • Integration: Überprüfen Sie seine Fähigkeit zur reibungslosen Integration mit Ihren nachgelagerten Tools, wie Business-Intelligence-Plattformen oder ML-Frameworks.
Was ist der Unterschied zwischen Datenverarbeitung und Datenanalyse?

Datenverarbeitung und Datenanalyse sind zwei unterschiedliche, aufeinanderfolgende Phasen in einem Daten-Workflow. Die Datenverarbeitung ist der erste Schritt, der sich auf die Aufbereitung von Rohdaten konzentriert. Sie umfasst das Bereinigen, Transformieren, Strukturieren und Anreichern von Daten, um sie genau und nutzbar zu machen. Das Ziel ist die Erstellung eines hochwertigen Datensatzes. Die Datenanalyse ist der nachfolgende Schritt, bei dem Sie die verarbeiteten Daten untersuchen, um Erkenntnisse zu gewinnen, Trends zu identifizieren und Geschäftsfragen zu beantworten. Kurz gesagt, die Verarbeitung bereitet die Daten für die Analyse vor; die Analyse verwandelt diese aufbereiteten Daten in Wissen.

Was sind die Hauptfunktionen von KI-Datenverarbeitungstools?

Die Hauptfunktionen von KI-Datenverarbeitungstools drehen sich um die Automatisierung und Verbesserung der Datenaufbereitung. Zu den Schlüsselfunktionen gehören:

  • Automatisierte Datenbereinigung: Intelligentes Identifizieren und Behandeln von Duplikaten, Fehlern, fehlenden Werten und Ausreißern.
  • Datentransformation: Konvertieren von Daten in verschiedene Formate oder Strukturen, wie das Pivotieren von Tabellen oder das Parsen von JSON-Feldern.
  • Datennormalisierung: Skalieren numerischer Daten auf einen gemeinsamen Bereich, um die Konsistenz für maschinelle Lernmodelle zu gewährleisten.
  • Feature-Engineering: Automatisches Erstellen neuer prädiktiver Variablen aus vorhandenen Daten, um die Modellgenauigkeit zu verbessern.
  • Extraktion unstrukturierter Daten: Parsen und Extrahieren strukturierter Informationen aus Rohtext, PDFs oder Bildern.
Wer sollte KI-Datenverarbeitungstools verwenden?

KI-Datenverarbeitungstools sind für eine Vielzahl von Fachleuten wertvoll, die mit rohen, unstrukturierten Daten arbeiten. Zu den Hauptnutzern gehören:

  • Datenwissenschaftler: Um den Prozess der Datenbereinigung und des Feature-Engineerings für die Erstellung von maschinellen Lernmodellen zu beschleunigen.
  • Datenanalysten: Um Daten aus mehreren Quellen für Business Intelligence und Berichterstattung zu konsolidieren und zu bereinigen.
  • Ingenieure für maschinelles Lernen: Um robuste, automatisierte Datenpipelines zu erstellen, die saubere Daten in Produktionsmodelle einspeisen.
  • Geschäftsanwender: Um die Datenaufbereitung im Self-Service-Verfahren durchzuführen, ohne tiefgreifende technische oder Programmierkenntnisse zu benötigen, unter Verwendung von Low-Code- oder No-Code-Schnittstellen.