ToolMage
Anmelden

Best 3 Datenbeschriftung AI tools for Entwicklertools

Popular Datenbeschriftung AI tools in Entwicklertools include Label Studio, Labellerr und Segments.ai, helping you work more efficiently.

Label Studio
Freemium

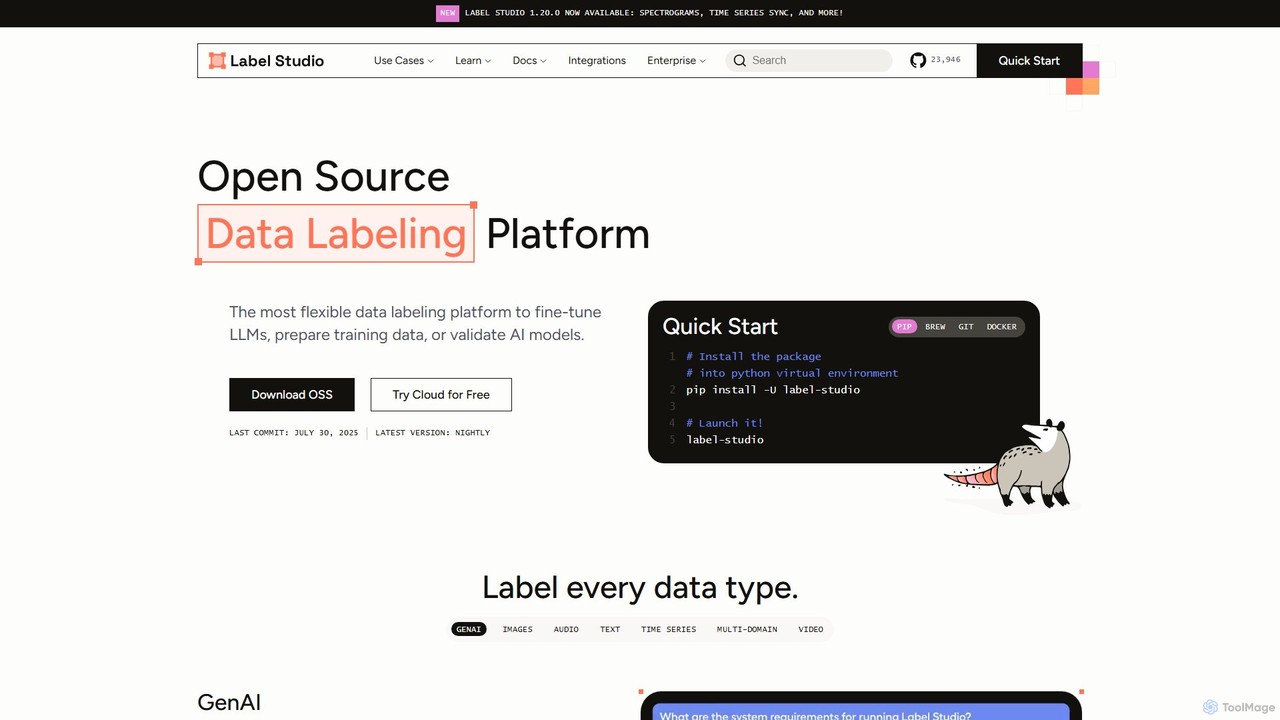
Label Studio

Label Studio ist eine vielseitige Open-Source-Plattform zur Datenkennzeichnung, die für eine breite Palette von Datentypen entwickelt wurde. Sie ermöglicht es Benutzern, Bilder, Texte, Audio, Video und Zeitreihendaten zu annotieren, um LLMs zu verfeinern, Trainingsdaten für maschinelles Lernen vorzubereiten und KI-Modelle mit menschlichem Feedback im Kreislauf zu validieren.

Trainingsdaten
Visits 268KFavorites 160Likes 170
Labellerr
Freemium

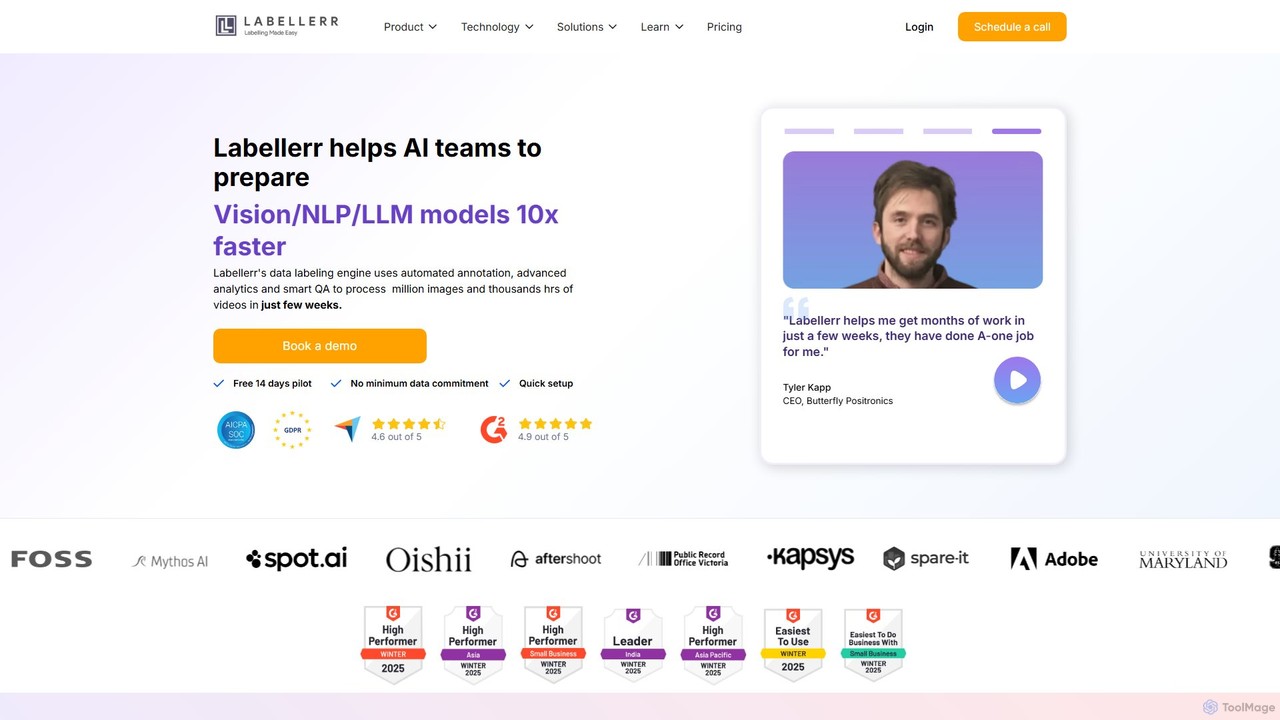
Labellerr

Labellerr ist eine KI-gestützte Daten-Labeling- und Annotationsplattform, die entwickelt wurde, um die Entwicklung von Vision-, NLP- und LLM-Modellen zu beschleunigen. Sie bietet automatisierte Annotation, intelligente Qualitätssicherung und nahtlose MLOps-Integration, um 99 % genaue Labels bis zu 99x schneller zu liefern und so die Datenvorbereitungszeit und die Entwicklungskosten für KI-Teams erheblich zu senken.

Machine Learning Operationen
Visits 116.2KFavorites 164Likes 166
Segments.ai
Freemium

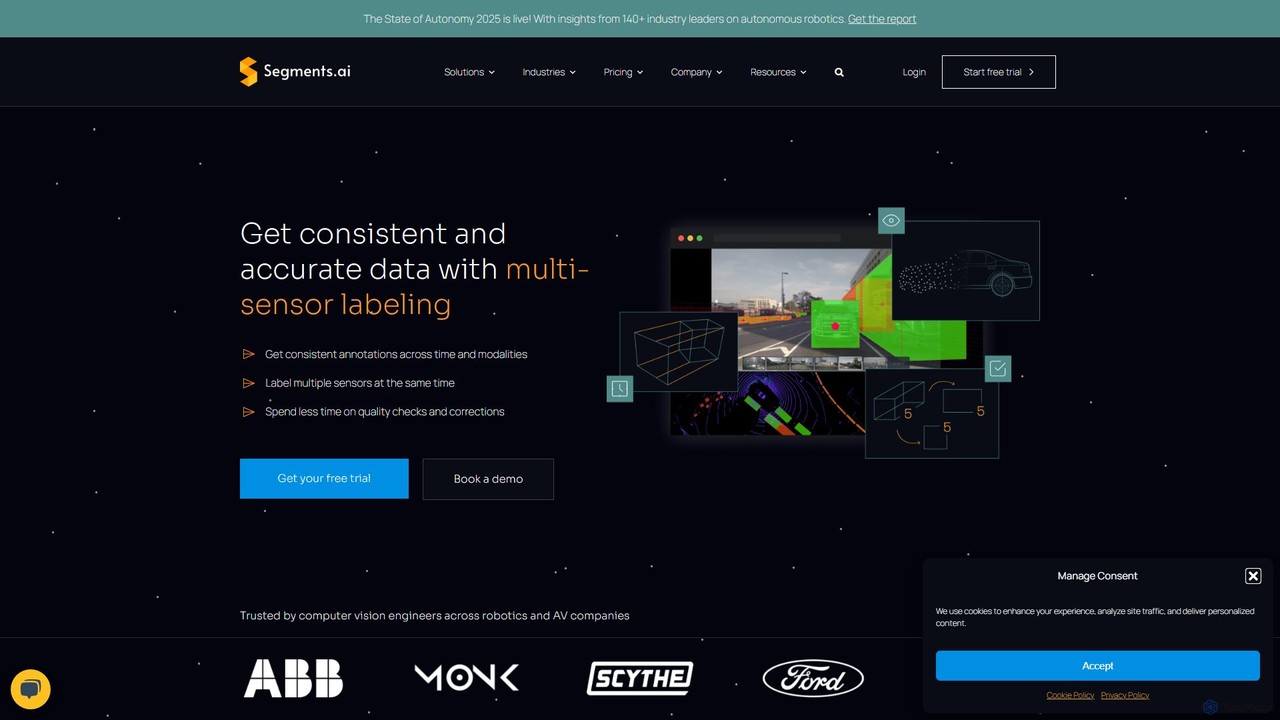
Segments.ai

Segments.ai ist eine fortschrittliche Daten-Labeling-Plattform für Multisensordaten, spezialisiert auf Robotik und autonome Fahrzeuge. Sie optimiert die Annotation von 2D-Bildern und 3D-Punktwolken mit ML-gestützten Werkzeugen und gewährleistet qualitativ hochwertige, konsistente Daten, um die Entwicklung von Computer-Vision-Modellen zu beschleunigen.

Computer Vision
Visits 29.8KFavorites 146Likes 131

About Datenbeschriftung

Datenbeschriftungstools sind spezialisierte Plattformen zur Annotation von Rohdaten wie Bildern, Text, Audio und Video, um sie für maschinelle Lernmodelle verständlich zu machen. Als wichtiger Teil des Entwickler-Toolkits verwenden diese Werkzeuge manuelle, halbautomatische und KI-gestützte Techniken, um Datenpunkten aussagekräftige Tags, Kategorien oder Attribute zuzuweisen. Dieser Prozess ist grundlegend für die Erstellung hochwertiger, strukturierter Trainingsdatensätze, die die Genauigkeit und Leistung von KI-Systemen in Bereichen wie Computer Vision und Natural Language Processing direkt bestimmen. Sie bieten kollaborative Workflows, Qualitätssicherungsmechanismen und spezialisierte Annotationsschnittstellen, um Präzision und Konsistenz in großem Maßstab zu gewährleisten.

Kernfunktionen

  • Unterstützung mehrerer Datentypen: Annotation verschiedener Datenformate, einschließlich Bilder (Bounding Boxes, Polygone, Segmentierung), Text (NER, Klassifizierung), Audio und Video.
  • KI-gestützte Beschriftung: Nutzt vortrainierte Modelle, um Beschriftungen vorzuschlagen, was den manuellen Annotationsprozess erheblich beschleunigt und menschliche Fehler reduziert.
  • Qualitätssicherungs-Workflows: Umfasst Funktionen wie Konsensbewertung, Überprüfungsphasen und Leistungsanalysen, um eine hohe Datenqualität und -konsistenz zu gewährleisten.
  • Zusammenarbeit & Projektmanagement: Bietet Werkzeuge für Teammanagement, Aufgabenverteilung, Fortschrittsverfolgung und die Verwaltung großer Beschriftungsprojekte.
  • Datensicherheit & Integration: Bietet sichere Datenverarbeitung, rollenbasierte Zugriffskontrolle und APIs zur nahtlosen Integration mit Cloud-Speicher und MLOps-Pipelines.

Anwendungsfälle

Datenbeschriftungstools sind für Branchen, die KI-Lösungen entwickeln, unerlässlich. Im Automobilsektor werden sie zur Annotation von Sensordaten für das Training autonomer Fahrzeuge eingesetzt. Im Gesundheitswesen helfen sie bei der Beschriftung medizinischer Bilder (Röntgen, MRTs) für Modelle zur Krankheitserkennung. E-Commerce-Unternehmen nutzen sie zur Kategorisierung von Produkten und zur Kennzeichnung von nutzergenerierten Inhalten für bessere Empfehlungsmaschinen und Inhaltsmoderation.

Wie man wählt

Bei der Auswahl eines Datenbeschriftungstools sollten Sie die spezifischen Datentypen, mit denen Sie arbeiten, und die erforderliche Annotationskomplexität berücksichtigen. Bewerten Sie die Wirksamkeit seiner KI-gestützten Funktionen und die Robustheit seiner Qualitätskontrollmechanismen. Beurteilen Sie seine Projektmanagementfähigkeiten für die Teamzusammenarbeit und Skalierbarkeit. Überprüfen Sie schließlich die Integrationsoptionen mit Ihrer bestehenden Datenspeicher- und maschinellen Lerninfrastruktur sowie die Sicherheitsprotokolle.

Datenbeschriftung use cases

1

Training von Wahrnehmungsmodellen für autonome Fahrzeuge

Ein Automobil-Ingenieurteam, das autonome Fahrtechnologie entwickelt, verwendet eine Datenbeschriftungsplattform, um Millionen von Videoframes von Fahrzeugsensoren zu verarbeiten. Annotatoren beschriften sorgfältig Objekte wie Fußgänger, Fahrzeuge, Verkehrsschilder und Fahrbahnmarkierungen mit Bounding Boxes, Polygonen und semantischer Segmentierung. Die Qualitätssicherungsfunktionen der Plattform, wie Konsensbewertung und Überprüfungsworkflows, gewährleisten hochpräzise Beschriftungen. Dieser präzise beschriftete Datensatz wird dann zum Trainieren und Validieren der Wahrnehmungsmodelle des Fahrzeugs verwendet, damit es seine Umgebung verstehen und sichere Fahrentscheidungen treffen kann.

2

Verbesserung der medizinischen Bilddiagnostik mit KI

Radiologen und Datenwissenschaftler in einem Gesundheitsforschungsinstitut arbeiten mit einem Datenbeschriftungstool zusammen, um Tausende von medizinischen Bildern wie MRTs und CT-Scans zu annotieren. Sie verwenden spezielle Werkzeuge für die Polygon- und Pinsel-Segmentierung, um Tumore, Läsionen und andere Anomalien präzise zu umreißen. Die Unterstützung der Plattform für DICOM-Formate und ihre sichere, konforme Umgebung sind entscheidend. Der resultierende hochwertige Datensatz wird verwendet, um ein Deep-Learning-Modell zur Früherkennung von Krankheiten zu trainieren, mit dem Ziel, Ärzte zu unterstützen, indem potenzielle Problembereiche in zukünftigen Scans hervorgehoben werden, was die diagnostische Genauigkeit und Geschwindigkeit verbessert.

3

Entwicklung eines Kundensupport-Chatbots

Ein Data-Science-Team in einem Technologieunternehmen entwickelt einen NLP-gestützten Chatbot. Sie verwenden ein Datenbeschriftungstool, um die Erkennung benannter Entitäten (NER) und die Absichtsklassifizierung für Tausende von Kundensupport-Transkripten durchzuführen. Annotatoren markieren Produktnamen, Benutzerprobleme und Daten und klassifizieren die Absicht jeder Anfrage (z. B. „Abrechnungsfrage“, „technischer Support“). Die KI-gestützten Funktionen der Plattform schlagen Entitäten und Absichten vor und beschleunigen so den Beschriftungsprozess. Diese strukturierten Daten werden dann verwendet, um den Chatbot zu trainieren, damit er Benutzeranfragen genau versteht, sie an die richtige Abteilung weiterleitet und relevante Antworten liefert.

4

Verbesserung der Produktfindung im E-Commerce

Das Datenteam einer E-Commerce-Plattform zielt darauf ab, seine Such- und Empfehlungsmaschine zu verbessern. Sie nutzen einen Datenbeschriftungsdienst, um ihren Produktkatalog anzureichern. Annotatoren weisen Millionen von Produktbildern detaillierte Attribute zu, wie z. B. „Ärmellänge“ für Kleidung oder „Materialtyp“ für Möbel. Für Produktbeschreibungen führen sie eine Textkategorisierung durch, um Artikel mit relevanten Stilen und Themen zu versehen. Diese hochdetaillierten, beschrifteten Daten ermöglichen es der Plattform, genauere Suchergebnisse zu liefern, facettierte Suchfilter zu betreiben und personalisierte Produktempfehlungen anzubieten, die das Nutzerengagement und den Umsatz erheblich steigern.

5

Erstellung von Datensätzen für die Agrar-KI

Ein Agrartechnologie-Unternehmen verwendet eine Datenbeschriftungsplattform, um Drohnen- und Satellitenbilder von Ackerland zu analysieren. Ein Team von Annotatoren verwendet semantische Segmentierung, um verschiedene Erntearten zu identifizieren, von Schädlingen oder Krankheiten betroffene Gebiete zu erkennen und Bewässerungsmuster zu kartieren. Die Fähigkeit der Plattform, große Geodatenbilder zu verarbeiten, und ihre kollaborativen Werkzeuge sind für den Erfolg des Projekts unerlässlich. Die beschrifteten Daten werden verwendet, um Computer-Vision-Modelle zu trainieren, die Landwirten umsetzbare Erkenntnisse liefern und ihnen helfen, den Ernteertrag zu optimieren, den Wasserverbrauch zu reduzieren und Behandlungen genau dort anzuwenden, wo sie benötigt werden.

6

Moderation von nutzergenerierten Inhalten in großem Maßstab

Das Trust-and-Safety-Team einer Social-Media-Plattform muss täglich Millionen von von Nutzern eingereichten Bildern und Textbeiträgen effizient moderieren. Sie verwenden ein Datenbeschriftungstool, um einen goldenen Datensatz für das Training ihrer automatisierten Moderationsmodelle zu erstellen. Menschliche Annotatoren klassifizieren Inhalte anhand detaillierter Richtlinien in Kategorien wie „sicher“, „Spam“ oder „unangemessen“. Die Überprüfungs- und Konsensfunktionen der Plattform gewährleisten hochwertige, konsistente Beschriftungen. Dieser Datensatz ermöglicht die Entwicklung von KI-Modellen, die richtlinienverletzende Inhalte automatisch kennzeichnen oder entfernen können, was die Belastung für menschliche Moderatoren reduziert und eine sicherere Online-Umgebung schafft.

Datenbeschriftung FAQ

Was sind Datenbeschriftungstools?

Datenbeschriftungstools sind Softwareplattformen, die dazu dienen, Rohdaten wie Bildern, Text oder Audio beschreibende Tags oder Annotationen hinzuzufügen. Dieser Prozess macht die Daten für maschinelle Lernalgorithmen verständlich. Diese Werkzeuge sind ein grundlegender Bestandteil der MLOps-Pipeline und bieten spezialisierte Schnittstellen für verschiedene Annotationsaufgaben (z. B. Bounding Boxes für die Objekterkennung, Named Entity Recognition für Text) sowie Workflows zur Verwaltung von Qualität und Zusammenarbeit zwischen den Annotatoren. Das Ergebnis ist ein hochwertiger, strukturierter Datensatz, der zum Trainieren, Validieren und Testen von KI-Modellen verwendet wird.

Wie wählt man das richtige Datenbeschriftungstool aus?

Die Wahl des richtigen Tools hängt von mehreren Faktoren ab. Berücksichtigen Sie zunächst die Datentypen, die Sie beschriften müssen (z. B. Bilder, Video, Text, Audio) und die spezifischen Annotationsmethoden, die erforderlich sind. Zweitens bewerten Sie die Qualitätskontrollfunktionen der Plattform, wie z. B. Konsensmechanismen, Überprüfungsworkflows und Analysen. Drittens beurteilen Sie die Skalierbarkeit und die Projektmanagementfähigkeiten für die Handhabung großer Datensätze und Teams. Berücksichtigen Sie schließlich die Integrationsfähigkeiten mit Ihrem bestehenden Tech-Stack (wie Cloud-Speicher und ML-Frameworks) und den Grad der Automatisierung oder KI-Unterstützung, den es zur Effizienzsteigerung bietet.

Was ist der Unterschied zwischen Datenbeschriftung und Datenannotation?

Die Begriffe Datenbeschriftung und Datenannotation werden oft synonym verwendet und beziehen sich auf denselben Kernprozess des Hinzufügens von Metadaten zu Rohdaten für das maschinelle Lernen. Einige Praktiker machen jedoch eine feine Unterscheidung. „Beschriftung“ kann sich manchmal auf die Zuweisung einer einfachen Klasse zu einem ganzen Datenelement beziehen (z. B. die Klassifizierung eines Bildes als „Katze“ oder „Hund“). „Annotation“ könnte einen detaillierteren Prozess implizieren, wie das Zeichnen von Bounding Boxes um Objekte oder das Segmentieren von Pixeln. In der Praxis verwenden die meisten modernen Tools und Plattformen beide Begriffe, um den umfassenden Prozess der Datenvorbereitung für KI-Modelle zu beschreiben.

Wer verwendet Datenbeschriftungstools?

Datenbeschriftungstools werden von einer Vielzahl von Rollen verwendet, die an der KI-Entwicklung beteiligt sind. Dazu gehören:

  • Datenwissenschaftler und ML-Ingenieure: Die die Beschriftungsprojekte entwerfen und die beschrifteten Daten zum Trainieren von Modellen verwenden.
  • Datenannotatoren/Beschrifter: Spezialisierte Einzelpersonen oder Teams (intern oder ausgelagert), die die eigentlichen Beschriftungsaufgaben durchführen.
  • Projektmanager: Die den Beschriftungsprozess überwachen, Teams leiten und die Datenqualität und Fristen sicherstellen.
  • Fachexperten: Wie Radiologen oder Agronomen, die das notwendige Fachwissen bereitstellen, um komplexe, spezialisierte Daten genau zu beschriften.
Diese Werkzeuge sind für jede Organisation, die benutzerdefinierte KI-Modelle erstellt, von entscheidender Bedeutung, von Tech-Startups bis hin zu großen Unternehmen in Sektoren wie Automobil, Gesundheitswesen und Einzelhandel.

Warum ist eine qualitativ hochwertige Datenbeschriftung für die KI wichtig?

Eine qualitativ hochwertige Datenbeschriftung ist entscheidend, da die Leistung eines maschinellen Lernmodells direkt von der Qualität der Daten abhängt, mit denen es trainiert wird. Das Prinzip „Garbage In, Garbage Out“ (Müll rein, Müll raus) gilt hier direkt. Ungenaue, inkonsistente oder voreingenommene Beschriftungen führen zu einem KI-Modell, das schlechte Vorhersagen trifft und sich unzuverlässig verhält. Hochwertige Beschriftungen stellen sicher, dass das Modell die richtigen Muster und Beziehungen in den Daten lernt, was zu besserer Genauigkeit, Robustheit und Fairness führt. Die Investition in eine qualitativ hochwertige Beschriftung reduziert den Zeitaufwand für das Debuggen von Modellen und führt letztendlich zu erfolgreicheren und vertrauenswürdigeren KI-Anwendungen.