ToolMage
Anmelden

Best 2 Maschinelles Lern-Framework AI tools for Entwicklertools

Popular Maschinelles Lern-Framework AI tools in Entwicklertools include MindSpore und MONAI, helping you work more efficiently.

MONAI
Free

MONAI

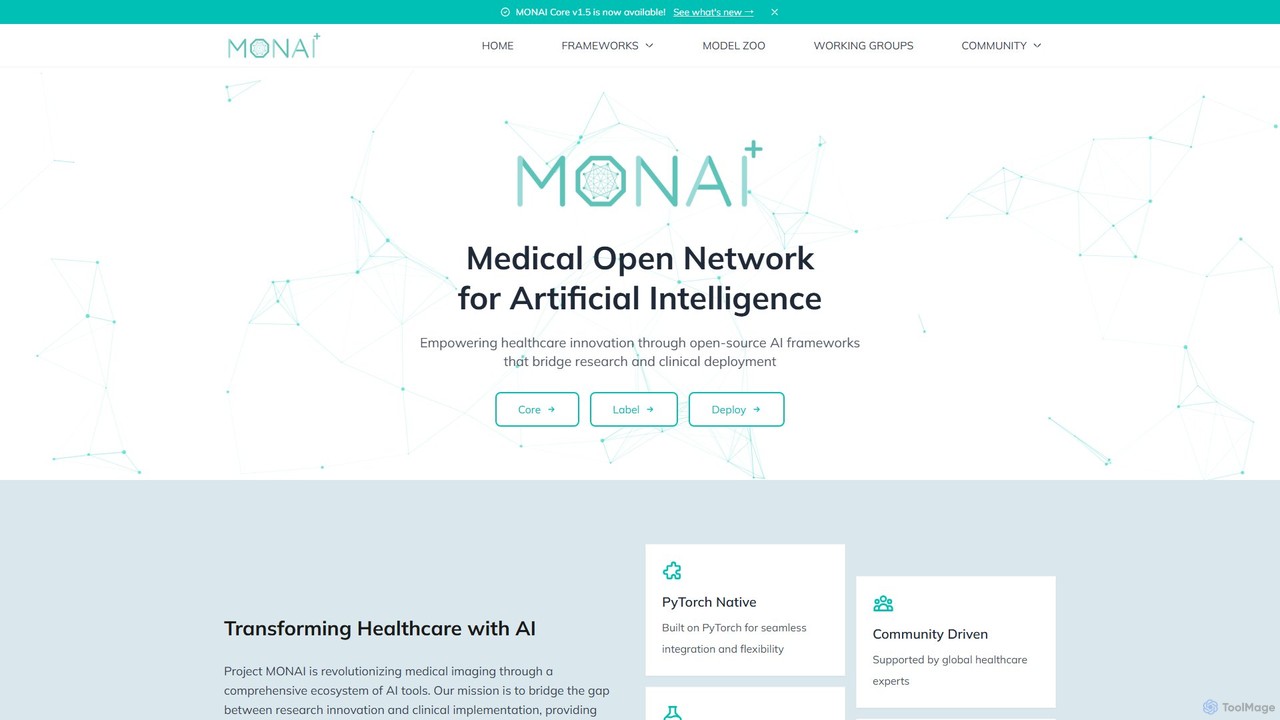
MONAI (Medical Open Network for AI) ist ein kostenloses, quelloffenes, PyTorch-basiertes Framework, das entwickelt wurde, um KI im Gesundheitswesen zu beschleunigen. Es bietet ein umfassendes Ökosystem von Werkzeugen für Forscher und Kliniker, das den gesamten KI-Lebenszyklus von der Datenannotation und dem Modelltraining (MONAI Core, MONAI Label) bis zur klinischen Bereitstellung (MONAI Deploy) abdeckt und die Lücke zwischen Forschung und realer Anwendung schließt.

Datenannotation
Visits 24.6KFavorites 147Likes 139
MindSpore
Free

MindSpore

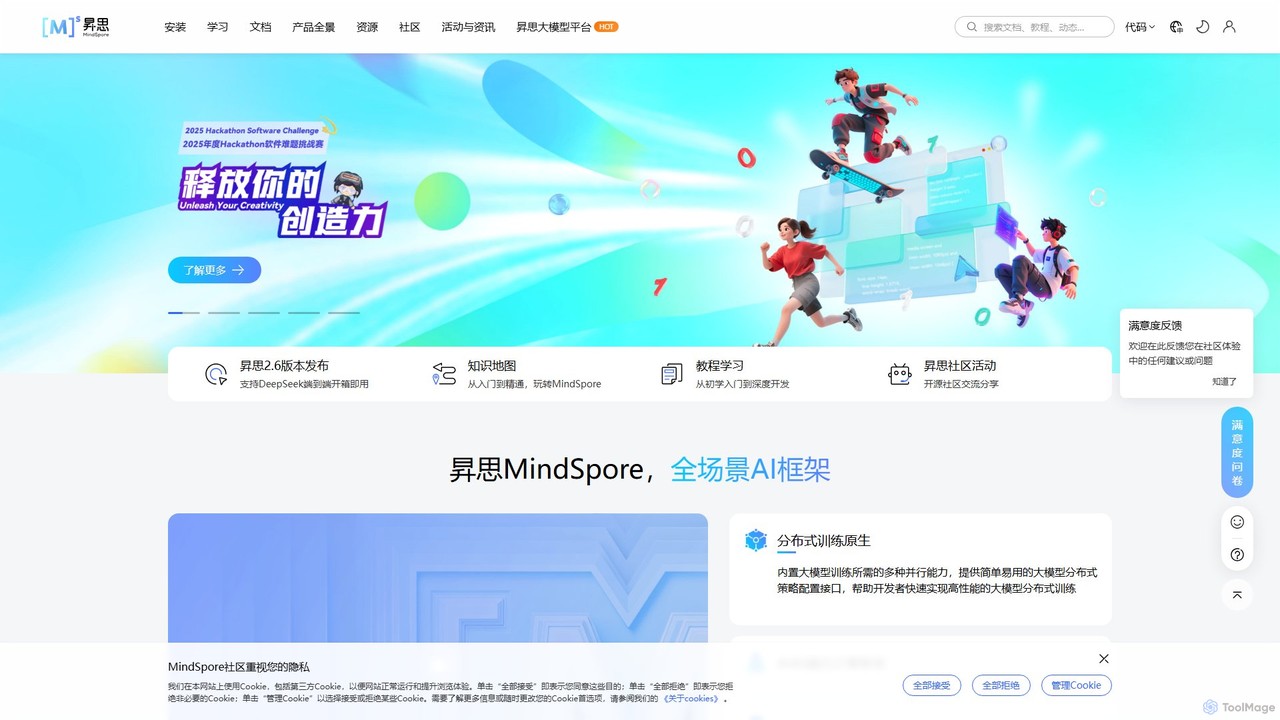
MindSpore ist ein Open-Source-KI-Computing-Framework für alle Szenarien, das für Entwickler und Datenwissenschaftler entwickelt wurde. Es bietet eine entwicklerfreundliche Erfahrung mit flexibler Bereitstellung in Cloud-, Edge- und Geräteumgebungen. Es zeichnet sich durch verteiltes Training für große Modelle aus und bietet spezielle Toolkits für wissenschaftliches Rechnen (AI4S), die eine hohe Leistung und Effizienz gewährleisten, insbesondere auf Ascend-Hardware.

Wissenschaftliches Rechnen
Visits 68.1KFavorites 124Likes 129

About Maschinelles Lern-Framework

Ein Maschinelles Lern-Framework ist ein spezialisiertes Entwicklerwerkzeug, das eine strukturierte Umgebung und High-Level-APIs zum Erstellen, Trainieren und Bereitstellen von Modellen des maschinellen Lernens bietet. Diese Frameworks abstrahieren komplexe mathematische Operationen und Hardware-Optimierungen, sodass sich Entwickler auf die Modellarchitektur und -logik konzentrieren können. Durch die Bereitstellung vorgefertigter Komponenten wie neuronale Netzwerkschichten, Optimierer und Datenlader beschleunigen sie den Entwicklungszyklus von der Forschung bis zur Produktion erheblich. Dies macht die Erstellung anspruchsvoller KI-Systeme zugänglicher und effizienter.

Kernfunktionen

  • Tensor-Bibliotheken & Autograd: Bietet mehrdimensionale Array-Strukturen (Tensoren) und eine automatische Differenzierungs-Engine zur Berechnung von Gradienten für das Modelltraining.
  • Modellbau-APIs: Bietet modulare High-Level-Schnittstellen (wie Keras oder PyTorchs nn.Module) zum Erstellen und Anpassen komplexer Modellarchitekturen.
  • GPU/TPU-Beschleunigung: Nutzt automatisch spezialisierte Hardware, um den rechenintensiven Trainingsprozess drastisch zu beschleunigen.
  • Bereitstellungs- & Serving-Tools: Enthält Dienstprogramme zum Exportieren trainierter Modelle in optimierte Formate und deren Bereitstellung auf Servern, Edge-Geräten oder in der Cloud.
  • Ökosystem & vortrainierte Modelle: Bietet ein reichhaltiges Ökosystem an Werkzeugen, Visualisierungsbibliotheken und Zugriff auf ein riesiges Repository vortrainierter Modelle, die für Transfer-Learning verwendet werden können.

Anwendungsfälle

Maschinelle Lern-Frameworks sind für Datenwissenschaftler, ML-Ingenieure und Forscher von grundlegender Bedeutung. Sie werden verwendet, um Computer-Vision-Systeme für die Bilderkennung zu entwickeln, Modelle zur Verarbeitung natürlicher Sprache für Chatbots und Übersetzungen zu erstellen und prädiktive Analysemodelle für Finanzen und Marketing zu schaffen. In der Wissenschaft sind sie unerlässlich, um mit neuen KI-Architekturen zu experimentieren und die Grenzen der Forschung zu erweitern.

Wie man wählt

Bei der Auswahl eines Maschinellen Lern-Frameworks sollten Sie das Ökosystem und den Community-Support berücksichtigen (z. B. TensorFlow vs. PyTorch). Bewerten Sie den Kompromiss zwischen Benutzerfreundlichkeit (High-Level-APIs) und Flexibilität (Low-Level-Kontrolle). Berücksichtigen Sie auch die Ziel-Bereitstellungsplattform – ob für Server, mobile Geräte (wie TensorFlow Lite) oder Webbrowser (wie TensorFlow.js). Schließlich bewerten Sie die Leistung und Skalierbarkeit des Frameworks für verteiltes Training auf großen Datensätzen.

Maschinelles Lern-Framework use cases

1

Entwicklung eines benutzerdefinierten Bilderkennungsmodells

Ein Computervision-Ingenieur hat die Aufgabe, ein System zur Identifizierung spezifischer Produktfehler an einem Fließband zu erstellen. Mit einem Framework wie PyTorch oder TensorFlow kann er ein Convolutional Neural Network (CNN) entwerfen. Das Framework bietet Werkzeuge zum effizienten Laden und Vorverarbeiten von Tausenden von Bildern, zum schichtweisen Definieren der Netzwerkarchitektur und zur Nutzung der GPU-Beschleunigung, um das Modell in Stunden statt in Tagen zu trainieren. Nach dem Training helfen die Dienstprogramme des Frameworks beim Exportieren des Modells für die Echtzeit-Inferenz am Produktionsband.

2

Feinabstimmung eines großen Sprachmodells (LLM)

Ein Forschungswissenschaftler muss ein vortrainiertes Sprachmodell wie BERT oder GPT für eine bestimmte Aufgabe anpassen, z. B. die Analyse von Rechtsdokumenten. Mit einem Framework wie JAX oder Hugging Face Transformers (das auf PyTorch/TensorFlow aufbaut) kann er das vortrainierte Modell laden und es auf einem benutzerdefinierten Datensatz von Rechtstexten feinabstimmen. Das Framework übernimmt die komplexe Speicherverwaltung und das verteilte Training, die für diese riesigen Modelle erforderlich sind, sodass sich der Forscher auf die Methodik des Experiments konzentrieren und bei seiner Nischenaufgabe hochmoderne Ergebnisse erzielen kann.

3

Bereitstellung eines Modells auf Edge-Geräten

Ein Entwickler mobiler Apps möchte seiner Anwendung eine Echtzeit-Objekterkennungsfunktion hinzufügen. Das Training eines großen Modells erfordert erhebliche Ressourcen, aber die Ausführung auf einem Telefon erfordert, dass es klein und effizient ist. Er verwendet ein Framework wie TensorFlow, um das Modell auf einem leistungsstarken Server zu trainieren. Anschließend verwendet er ein spezielles Werkzeug innerhalb des Frameworks, TensorFlow Lite, um das trainierte Modell zu konvertieren und zu optimieren. Dieser Prozess quantisiert die Gewichte des Modells und beschneidet unnötige Verbindungen, wodurch eine leichtgewichtige Version entsteht, die direkt auf der Hardware eines Smartphones mit geringer Latenz ausgeführt werden kann.

4

Aufbau eines prädiktiven Analysesystems

Ein Datenwissenschaftler in einem E-Commerce-Unternehmen möchte die Kundenabwanderung vorhersagen. Er verwendet ein Framework wie scikit-learn für die anfängliche Untersuchung mit einfacheren Modellen wie der logistischen Regression. Für komplexere Muster könnte er zu einem Deep-Learning-Framework wie Keras wechseln, um ein neuronales Netzwerk zu erstellen. Das Framework bietet Dienstprogramme für die Datenteilung, die Merkmalskalierung und die Modellevaluierung (z. B. die Berechnung von Genauigkeit und Präzision). Dieser strukturierte Ansatz ermöglicht schnelles Experimentieren und Iterieren, was zu einem zuverlässigen Modell führt, das in das CRM-System des Unternehmens integriert werden kann.

5

Beschleunigung von wissenschaftlicher Forschung und Simulation

Ein Physiker erforscht komplexe Teilchenwechselwirkungen, die mit traditionellen Gleichungen schwer zu modellieren sind. Er kann ein maschinelles Lern-Framework wie JAX verwenden, das für seine Hochleistungsrechenfähigkeiten bekannt ist, um ein neuronales Netzwerk zu erstellen, das die Dynamik der Simulation aus Daten lernt. Die Fähigkeit des Frameworks, Code für GPUs/TPUs zu kompilieren und automatische Differenzierung bei komplexen Funktionen durchzuführen, ermöglicht es dem Forscher, neuartige Simulationsmodelle weitaus schneller zu erstellen und zu testen, als es manuelles Codieren erlauben würde, was potenziell zu neuen wissenschaftlichen Entdeckungen führen kann.

6

Erstellung eines Chatbots für die Verarbeitung natürlicher Sprache (NLP)

Ein ML-Ingenieur hat die Aufgabe, einen intelligenten Kundenservice-Chatbot zu erstellen. Er verwendet ein Framework wie PyTorch zusammen mit einer Bibliothek wie Hugging Face Transformers. Das Framework bietet die Kernkomponenten zum Erstellen eines Transformer-basierten Modells, wie z. B. Aufmerksamkeitsmechanismen und Einbettungsschichten. Es bietet auch effiziente Datenlader zur Verarbeitung großer Textkorpora für das Training. Dies ermöglicht es dem Ingenieur, sich auf die spezifische Logik des Chatbots zu konzentrieren, wie z. B. die Absichtserkennung und das Dialogmanagement, anstatt das komplexe zugrunde liegende neuronale Netzwerk von Grund auf neu zu implementieren.

Maschinelles Lern-Framework FAQ

Was ist ein Maschinelles Lern-Framework?

Ein Maschinelles Lern-Framework ist eine umfassende Softwarebibliothek, die Entwicklern die Werkzeuge und die Struktur zur Verfügung stellt, um Modelle des maschinellen Lernens effizient zu erstellen, zu trainieren und bereitzustellen. Es fungiert als Grundlage und abstrahiert komplexe Low-Level-Operationen wie Matrixmultiplikation und Gradientenberechnung. Zu den Schlüsselkomponenten gehören Tensor-Bibliotheken (z. B. für die Datenverarbeitung), automatische Differenzierungs-Engines für das Training, vorgefertigte Schichten für den Modellaufbau und Optimierer. Beliebte Beispiele sind TensorFlow, PyTorch und JAX.

Wie wähle ich zwischen TensorFlow und PyTorch?

Die Wahl hängt oft von den Anforderungen Ihres Projekts und Ihren persönlichen Vorlieben ab. Hier sind einige allgemeine Überlegungen:

  • Ökosystem & Bereitstellung: TensorFlow hatte historisch ein reiferes und robusteres Ökosystem für die Produktionsbereitstellung, einschließlich Tools wie TensorFlow Serving und TensorFlow Lite für Mobilgeräte.
  • Benutzerfreundlichkeit & Flexibilität: PyTorch wird oft als 'pythonischer' und intuitiver angesehen, mit einem dynamischen Berechnungsgraphen, der das Debuggen erleichtert. Es wird in der Forschungsgemeinschaft wegen seiner Flexibilität weithin bevorzugt.
  • Community & Ressourcen: Beide haben riesige, aktive Communities und umfangreiche Dokumentationen. Ihre Wahl könnte von den für Ihr spezifisches Problem verfügbaren Tutorials oder vortrainierten Modellen beeinflusst werden.
  • High-Level-APIs: Beide Frameworks verfügen über ausgezeichnete High-Level-APIs (Keras für TensorFlow und die eigene API von PyTorch), was den Unterschied in der Benutzerfreundlichkeit bei vielen gängigen Aufgaben weniger ausgeprägt macht.
Was ist der Unterschied zwischen einem Maschinellen Lern-Framework und einer Bibliothek wie NumPy?

Der Hauptunterschied liegt im Umfang und Zweck. Eine Bibliothek wie NumPy bietet grundlegende Werkzeuge für eine bestimmte Aufgabe, in diesem Fall effiziente numerische Berechnungen mit Arrays. Ein Maschinelles Lern-Framework ist ein viel breiteres System, das *auf* solchen Bibliotheken aufbaut oder neben ihnen existiert. Ein Framework bietet eine vollständige, strukturierte Umgebung für den gesamten ML-Workflow, einschließlich:

  • Automatische Differenzierung: Zur Berechnung von Gradienten für das Training, eine Funktion, die NumPy nicht hat.
  • GPU/TPU-Unterstützung: Zur Beschleunigung von Berechnungen auf spezialisierter Hardware.
  • Modellabstraktionen: High-Level-APIs zur Definition von Schichten, Modellen und Verlustfunktionen.
  • End-to-End-Workflow: Werkzeuge für das Laden von Daten, Trainingsschleifen, Evaluierung und Bereitstellung.

Kurz gesagt, Sie verwenden eine Bibliothek wie NumPy, um Berechnungen durchzuführen, aber Sie verwenden ein Framework wie TensorFlow, um ein gesamtes maschinelles Lernsystem zu erstellen und zu trainieren.

Muss ich ein Mathe-Experte sein, um ein Maschinelles Lern-Framework zu verwenden?

Nein, Sie müssen kein Mathe-Experte sein, um mit der Verwendung eines Maschinellen Lern-Frameworks zu beginnen. High-Level-APIs wie Keras (in TensorFlow) oder fast.ai (auf PyTorch) abstrahieren die meisten komplexen mathematischen Vorgänge, sodass Sie mit nur wenigen Codezeilen leistungsstarke Modelle erstellen können. Ein grundlegendes Verständnis von Konzepten wie linearer Algebra, Analysis (insbesondere Ableitungen) und Wahrscheinlichkeitstheorie ist jedoch äußerst hilfreich für:

  • Das Debuggen von Modellen, wenn sie nicht gut funktionieren.
  • Das Anpassen von Modellen über Standardarchitekturen hinaus.
  • Das Verstehen von Forschungsarbeiten und die Implementierung neuartiger Techniken.
  • Die Optimierung der Modellleistung und der Trainingseffizienz.

Sie können zuerst mit dem Erstellen beginnen und die zugrunde liegenden mathematischen Konzepte lernen, während Sie Fortschritte machen und auf komplexere Probleme stoßen.

Was sind die Schlüsselkomponenten eines typischen Maschinellen Lern-Frameworks?

Obwohl sich die Frameworks unterscheiden, teilen die meisten einen gemeinsamen Satz von Kernkomponenten, die den Workflow des maschinellen Lernens erleichtern sollen. Dazu gehören typischerweise:

  • Tensor-Bibliothek: Die grundlegende Datenstruktur für den Umgang mit mehrdimensionalen Datenarrays.
  • Automatische Differenzierungs-Engine (Autograd): Berechnet automatisch die Gradienten von Operationen, was für das Training von Modellen mittels Backpropagation unerlässlich ist.
  • Modellbau-API: Eine Sammlung vorgefertigter und anpassbarer Schichten (z. B. Faltungs-, rekurrente Schichten), Aktivierungsfunktionen und Verlustfunktionen zum Aufbau neuronaler Netze.
  • Optimierer: Implementierungen von Algorithmen (wie Adam, SGD), die die Modellgewichte basierend auf den berechneten Gradienten aktualisieren, um den Verlust zu minimieren.
  • Datenlade-Dienstprogramme: Werkzeuge zum effizienten Laden, Vorverarbeiten und Stapeln großer Datensätze für das Training.
  • Bereitstellungswerkzeuge: Dienstprogramme zum Speichern, Konvertieren und Bereitstellen von Modellen für die Inferenz in Produktionsumgebungen (z. B. TensorFlow Serving, TorchServe).