
ToolMage
Anmelden

Best 1 Bibliotheken für Maschinelles Lernen AI tools for Entwicklertools

Popular Bibliotheken für Maschinelles Lernen AI tools in Entwicklertools include Cleora, helping you work more efficiently.

Cleora
Free

Cleora

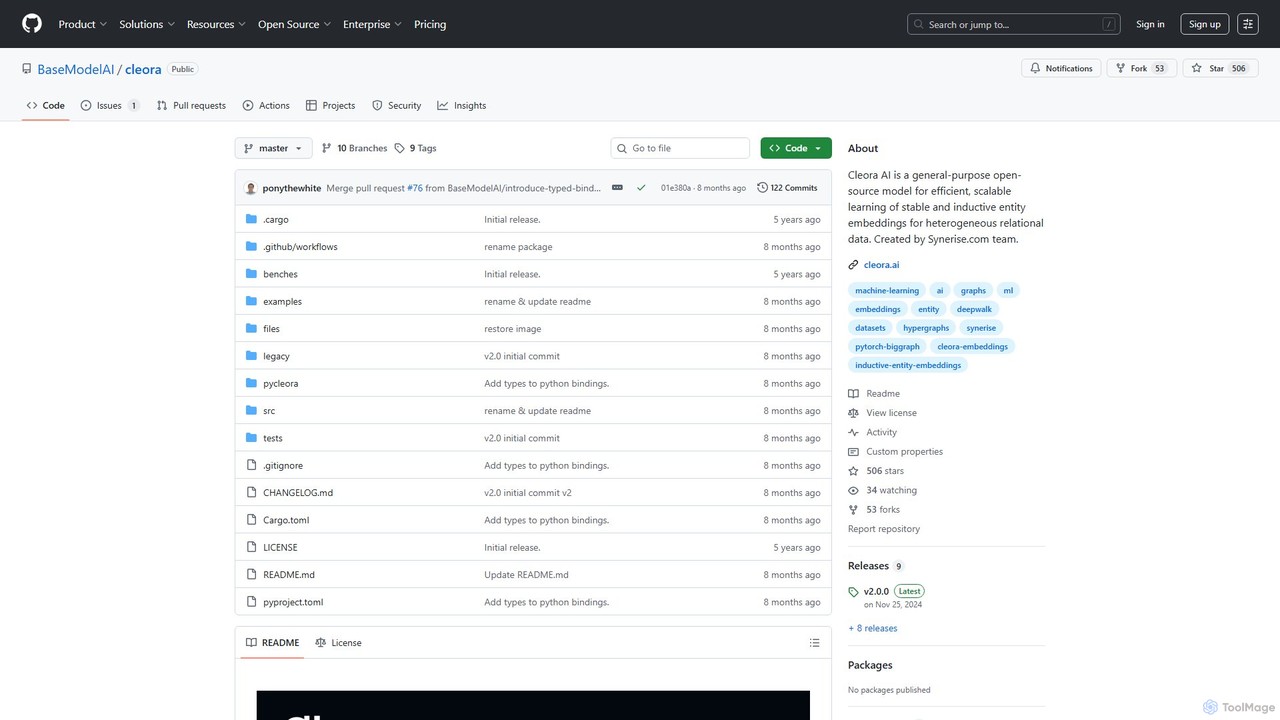
Cleora ist ein quelloffenes, hochleistungsfähiges Modell zur Erstellung stabiler und induktiver Entitäten-Embeddings aus großen, heterogenen relationalen Daten und Hypergraphen. Es ist in Rust geschrieben und verfügt über eine Python-API, die unübertroffene Geschwindigkeit und Skalierbarkeit für Aufgaben wie Empfehlungssysteme und Graphenanalysen bietet.

Embedding-Modelle
Visits 61.8KFavorites 142Likes 140

About Bibliotheken für Maschinelles Lernen

Bibliotheken für Maschinelles Lernen sind spezialisierte Sammlungen von vorprogrammiertem Code, Algorithmen und Tools, die entwickelt wurden, um die Entwicklung von Machine-Learning-Modellen zu vereinfachen und zu beschleunigen. Als entscheidende Komponente innerhalb der Entwickler-Tools abstrahieren diese Bibliotheken komplexe mathematische Operationen und bieten hochrangige APIs, die es Datenwissenschaftlern und Entwicklern ermöglichen, KI-gestützte Anwendungen effizient zu erstellen, zu trainieren und bereitzustellen. Sie befähigen Benutzer, sich auf Daten und Modellarchitektur statt auf Implementierungsdetails auf niedriger Ebene zu konzentrieren, was den Machine-Learning-Workflow erheblich beschleunigt.

Kernfunktionen

  • Algorithmus-Implementierungen: Vorgefertigte Algorithmen für Klassifizierung, Regression, Clustering und mehr, sofort einsatzbereit.
  • Datenvorverarbeitungstools: Funktionen zum Bereinigen, Transformieren und Vorbereiten von Rohdaten für das Modelltraining.
  • Modellbewertungsmetriken: Standardisierte Metriken und Tools zur Bewertung der Modellleistung und zur Identifizierung von Verbesserungsbereichen.
  • Deep-Learning-Frameworks: Spezialisierte Module zum Erstellen und Trainieren neuronaler Netze, einschließlich konvolutioneller und rekurrenten Architekturen.
  • Modellpersistenz: Funktionen zum Speichern und Laden trainierter Modelle für die zukünftige Verwendung oder Bereitstellung.

Anwendungsszenarien

Bibliotheken für Maschinelles Lernen sind in verschiedenen Bereichen unverzichtbar. Datenwissenschaftler nutzen sie für prädiktive Analysen in Finanzen und Gesundheitswesen, während Softwareentwickler sie in Anwendungen für Empfehlungssysteme oder die Verarbeitung natürlicher Sprache integrieren. Forscher verwenden diese Bibliotheken auch für schnelles Prototyping und Experimente mit neuen KI-Modellen.

Auswahlkriterien

Die Auswahl der richtigen Machine-Learning-Bibliothek erfordert die Berücksichtigung mehrerer Faktoren: die spezifische Art der ML-Aufgabe (z. B. Deep Learning, traditionelles ML), die erforderliche Programmiersprache, Community-Support und Dokumentation, Leistungsanforderungen und die einfache Integration in bestehende Systeme. Bewerten Sie das API-Design der Bibliothek und ihre Skalierbarkeit für das zukünftige Wachstum Ihres Projekts.

Bibliotheken für Maschinelles Lernen use cases

1

Aufbau von Predictive-Analytics-Systemen

Datenwissenschaftler nutzen Machine-Learning-Bibliotheken, um robuste prädiktive Modelle für verschiedene Geschäftsanforderungen zu entwickeln. Im Finanzwesen können sie beispielsweise Modelle zur Vorhersage von Aktienkursen oder zur Erkennung betrügerischer Transaktionen erstellen, indem sie Algorithmen mit historischen Daten trainieren, was proaktive Entscheidungen und Risikominderung ermöglicht.

2

Entwicklung von Empfehlungssystemen

E-Commerce-Plattformen und Streaming-Dienste nutzen ML-Bibliotheken, um personalisierte Empfehlungssysteme zu erstellen. Entwickler trainieren kollaborative Filter- oder inhaltsbasierte Modelle anhand des Nutzerverhaltens und der Artikelattribute, um relevante Produkte, Filme oder Musik vorzuschlagen, was die Nutzerbindung und den Umsatz erheblich steigert.

3

Implementierung von Natural Language Processing (NLP)-Lösungen

KI-Ingenieure und Linguisten nutzen Bibliotheken, um ausgeklügelte NLP-Anwendungen zu entwickeln. Dazu gehören Tools zur Stimmungsanalyse für Kundenfeedback, Chatbots für automatisierten Support oder Textzusammenfassungssysteme, die es Unternehmen ermöglichen, große Mengen an Textdaten effizient zu verarbeiten und zu verstehen.

4

Training von Computer-Vision-Modellen

Forscher und Entwickler in Bereichen wie autonomes Fahren oder medizinische Bildgebung nutzen Deep-Learning-Bibliotheken, um Computer-Vision-Modelle zu trainieren. Sie können Objekterkennungssysteme zur Identifizierung von Fahrzeugen auf Straßen oder Bildklassifizierungsmodelle zur Diagnose von Krankheiten aus Scans entwickeln und so die Grenzen der visuellen KI erweitern.

5

Automatisierung von Datenvorverarbeitungs-Workflows

Dateningenieure und -analysten nutzen ML-Bibliotheken häufig, um komplexe Aufgaben der Datenbereinigung, -transformation und Feature-Engineering zu automatisieren. Dies optimiert die Vorbereitung von Rohdatensätzen für das Modelltraining und gewährleistet Datenqualität und -konsistenz, was für genaue Machine-Learning-Ergebnisse entscheidend ist.

6

Schnelles Prototyping und Forschung

Machine-Learning-Forscher und Akademiker verlassen sich auf diese Bibliotheken, um schnell neue Algorithmen und Modellarchitekturen zu prototypisieren und zu experimentieren. Die hochrangigen APIs und umfangreichen Funktionalitäten ermöglichen eine schnelle Iteration und das Testen von Hypothesen, wodurch Innovationen im KI-Bereich beschleunigt werden.

Bibliotheken für Maschinelles Lernen FAQ

Was sind Bibliotheken für Maschinelles Lernen?

Bibliotheken für Maschinelles Lernen sind Sammlungen von vorprogrammiertem Code, Funktionen und Algorithmen, die den Prozess des Erstellens, Trainierens und Bereitstellens von Machine-Learning-Modellen vereinfachen. Sie bieten hochrangige Abstraktionen für komplexe mathematische Operationen, sodass Entwickler und Datenwissenschaftler sich auf das Modell-Design und die Daten konzentrieren können, anstatt auf die Implementierung auf niedriger Ebene. Zu den Hauptmerkmalen gehören umfassende Algorithmusunterstützung, Datenvorverarbeitungstools und Modellbewertungsfunktionen.

Wie wähle ich die richtige Machine-Learning-Bibliothek für mein Projekt aus?

Die Wahl der richtigen Bibliothek hängt von mehreren Faktoren ab. Berücksichtigen Sie die spezifische ML-Aufgabe (z. B. Deep Learning, traditionelle Klassifizierung), die bevorzugte Programmiersprache (Python ist dominant), die Größe und Komplexität Ihrer Daten sowie die erforderliche Leistung. Bewerten Sie den Community-Support, die Dokumentationsqualität und die einfache Integration in Ihren bestehenden Technologie-Stack. Beliebte Optionen sind Scikit-learn für traditionelles ML und TensorFlow/PyTorch für Deep Learning.

Was sind die Haupttypen von Machine-Learning-Bibliotheken?

Machine-Learning-Bibliotheken lassen sich grob in traditionelle ML-Bibliotheken und Deep-Learning-Frameworks unterteilen. Traditionelle ML-Bibliotheken (wie Scikit-learn) bieten eine breite Palette von Algorithmen für Klassifizierung, Regression, Clustering und Dimensionsreduktion. Deep-Learning-Frameworks (wie TensorFlow und PyTorch) sind speziell für den Aufbau und das Training neuronaler Netze konzipiert und zeichnen sich bei Aufgaben wie Computer Vision und natürlicher Sprachverarbeitung durch ihre optimierte GPU-Unterstützung und automatische Differenzierungsfunktionen aus.

Wer nutzt Machine-Learning-Bibliotheken und zu welchem Zweck?

Machine-Learning-Bibliotheken werden hauptsächlich von Datenwissenschaftlern, Machine-Learning-Ingenieuren, KI-Forschern und Softwareentwicklern verwendet. Datenwissenschaftler nutzen sie für prädiktive Modellierung und Datenanalyse. Ingenieure integrieren sie in Anwendungen für Funktionen wie Empfehlungssysteme oder Betrugserkennung. Forscher nutzen sie zum Experimentieren mit neuen Algorithmen und zur Weiterentwicklung von KI-Fähigkeiten. Im Wesentlichen profitiert jeder, der an der Entwicklung oder Bereitstellung von KI-gestützten Lösungen beteiligt ist, von diesen Tools.

Welche Vorteile bieten Machine-Learning-Bibliotheken im Vergleich zum Bau von Modellen von Grund auf?

Die Verwendung von Machine-Learning-Bibliotheken bietet erhebliche Vorteile gegenüber dem Bau von Modellen von Grund auf. Sie sparen enorme Entwicklungszeit, indem sie voroptimierte, getestete Algorithmen und Funktionen bereitstellen. Bibliotheken reduzieren die Fehlerwahrscheinlichkeit, gewährleisten eine konsistente Leistung und werden oft mit umfassender Dokumentation und Community-Support geliefert. Dies ermöglicht es Entwicklern, sich auf übergeordnete Problemlösungen und Innovationen zu konzentrieren, anstatt grundlegende mathematische und algorithmische Komponenten neu zu erfinden.