ToolMage
Anmelden

Best 2 Datenextraktion AI tools for Dokumentenmanagement

Popular Datenextraktion AI tools in Dokumentenmanagement include Extractify und Parsemania, helping you work more efficiently.

Extractify
Freemium

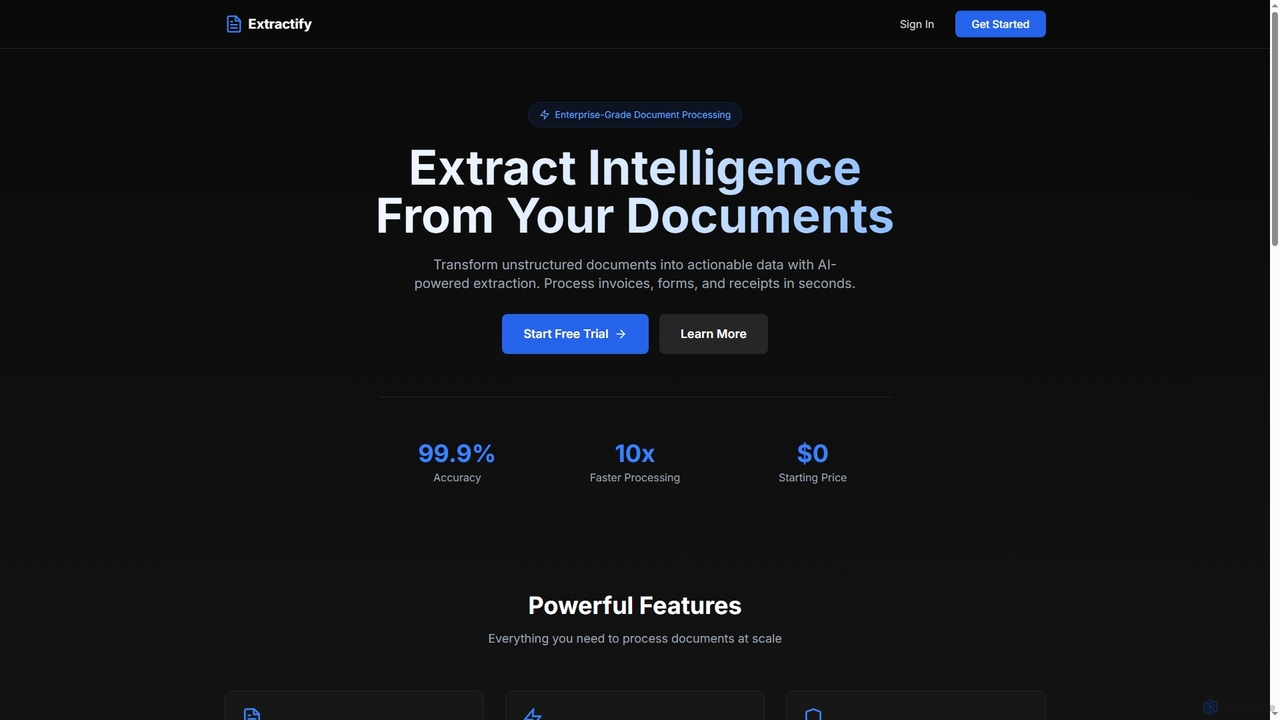
Extractify

Extractify ist ein KI-gestütztes Dokumentenverarbeitungstool, das unstrukturierte Dokumente wie Rechnungen, Formulare und Belege in verwertbare, strukturierte Daten umwandelt. Es bietet eine Genauigkeit von 99,9% und eine 10-fach schnellere Verarbeitung, mit intelligenter Extraktion von Text, Tabellen und Schlüssel-Wert-Paaren aus verschiedenen Formaten. Mit Unternehmenssicherheit und skalierbaren Plänen hilft es Unternehmen, die Dateneingabe zu automatisieren und Informationen aus ihren Dokumenten zu gewinnen.

Intelligent Document Processing
Visits 6.5KFavorites 35Likes 38
Parsemania
Freemium

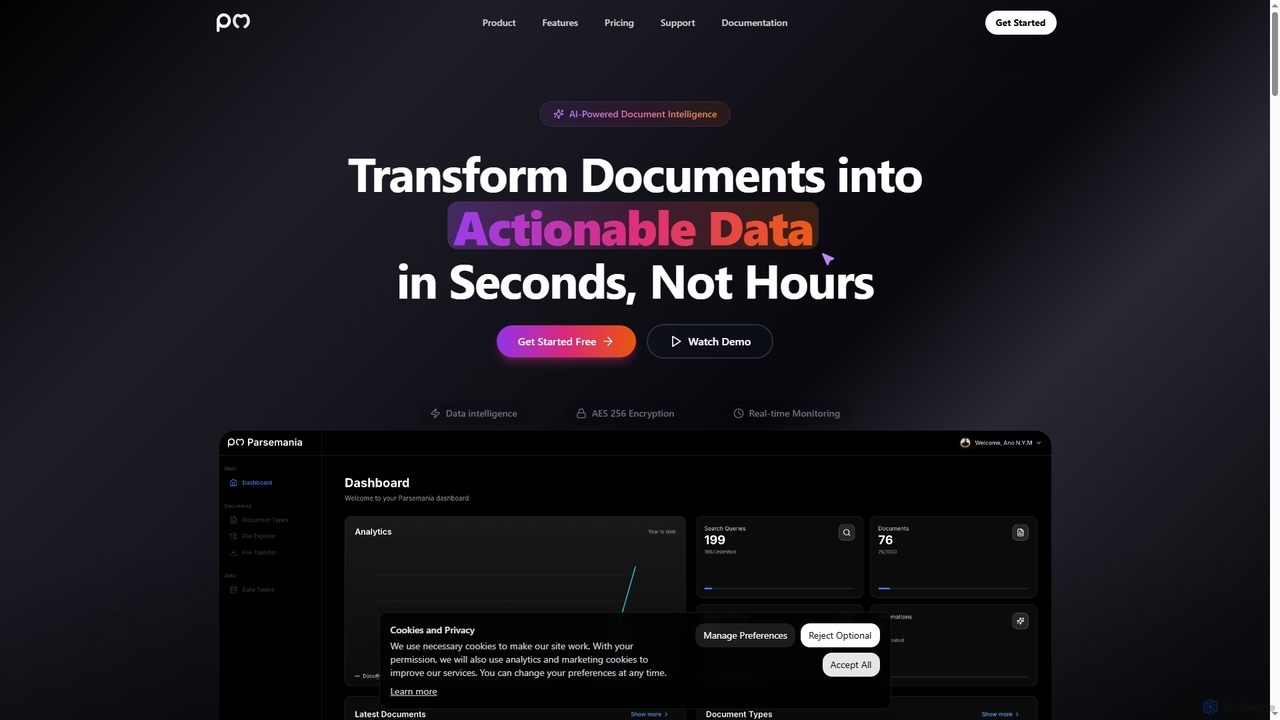
Parsemania

Parsemania ist eine KI-gestützte Dokumentenintelligenzplattform, die unstrukturierte Dokumente in verwertbare Daten umwandelt. Sie automatisiert die Datenextraktion, -strukturierung und -verarbeitung aus Rechnungen, Belegen und PDFs, wodurch die Produktivität erheblich gesteigert und der manuelle Aufwand für Unternehmen in verschiedenen Branchen reduziert wird.

Datenextraktion
Visits 6.4KFavorites 165Likes 158

About Datenextraktion

Datenextraktions-Tools sind KI-gestützte Lösungen, die darauf ausgelegt sind, spezifische Informationen aus verschiedenen Dokumenttypen automatisch zu identifizieren, zu extrahieren und zu strukturieren. Mithilfe fortschrittlicher Technologien wie Natural Language Processing (NLP), Optical Character Recognition (OCR) und maschinellem Lernen wandeln diese Tools unstrukturierte oder semi-strukturierte Daten in nutzbare Formate um. Sie sind entscheidend für die Automatisierung der manuellen Dateneingabe, die Verbesserung der Genauigkeit und die Beschleunigung der Informationsverarbeitung innerhalb umfassenderer Dokumentenmanagement-Workflows.

Kernfunktionen

  • Automatisierte Datenidentifikation: Lokalisiert und kategorisiert automatisch wichtige Datenfelder wie Namen, Daten, Beträge und Adressen aus verschiedenen Dokumenten.
  • Multi-Format-Unterstützung: Verarbeitet Informationen aus einer Vielzahl von Quellen, einschließlich PDFs, gescannten Bildern, handschriftlichen Notizen, Webseiten und digitalen Dokumenten.
  • Strukturierte Ausgabeerzeugung: Exportiert extrahierte Daten in organisierte Formate wie CSV, JSON, XML oder integriert sie direkt über APIs in Datenbanken und Geschäftssysteme.
  • Vorlagenfreies & Adaptives Lernen: Viele Tools können Dokumentenlayouts ohne vordefinierte Vorlagen lernen und sich im Laufe der Zeit an Variationen und neue Dokumenttypen anpassen.
  • Validierung und Fehlerbehandlung: Enthält Mechanismen zur Datenvalidierung, zur Kennzeichnung von Abweichungen und oft eine menschliche Überprüfung (Human-in-the-Loop) zur Verbesserung der Genauigkeit.

Anwendbare Szenarien

Diese Tools sind unverzichtbar für Organisationen, die große Mengen an Dokumenten verarbeiten, wie z.B. Finanzinstitute, die Kreditanträge bearbeiten, Anwaltskanzleien, die Verträge analysieren, oder Gesundheitsdienstleister, die Patientenakten zusammenfassen. Sie optimieren Abläufe, indem sie Rohdokumentendaten in verwertbare Erkenntnisse umwandeln, die Compliance unterstützen und die Betriebskosten senken.

Auswahlkriterien

Bei der Auswahl eines Datenextraktions-Tools sollten Sie dessen Genauigkeitsraten für Ihre Dokumententypen, die Kompatibilität mit verschiedenen Dateiformaten und die Integrationsmöglichkeiten mit bestehenden Unternehmenssystemen berücksichtigen. Bewerten Sie die Skalierbarkeit zur Bewältigung zukünftiger Datenmengen, den Grad der Anpassung für spezifische Extraktionsregeln und robuste Sicherheitsfunktionen zum Schutz sensibler Informationen.

Datenextraktion use cases

1

Automatisierte Rechnungsverarbeitung

Finanzabteilungen nutzen die KI-Datenextraktion, um kritische Informationen wie Lieferantennamen, Rechnungsnummern, Einzelposten und Gesamtbeträge aus eingehenden Rechnungen automatisch zu erfassen. Dies eliminiert die manuelle Dateneingabe, beschleunigt die Kreditorenbuchhaltung erheblich und reduziert menschliche Fehler, wodurch pünktliche Zahlungen und genaue Finanzunterlagen gewährleistet werden.

2

Vertragsklausel-Identifikation

Juristen und Compliance-Beauftragte nutzen diese Tools, um spezifische Klauseln, Bedingungen, Daten und Parteien aus großen Mengen von Rechtsverträgen schnell zu identifizieren und zu extrahieren. Dies beschleunigt die Vertragsprüfung, Due-Diligence-Prozesse und gewährleistet die Einhaltung gesetzlicher Vorschriften, wodurch unzählige Stunden manueller Suche eingespart werden.

3

Kundenfeedback-Analyse

Marketing- und Produktteams nutzen die Datenextraktion, um Schlüsselthemen, Stimmungen und spezifische Schlüsselwörter aus Kundenbewertungen, Umfrageantworten und Social-Media-Kommentaren zu extrahieren. Durch die Strukturierung dieser qualitativen Daten können Unternehmen verwertbare Einblicke in Kundenpräferenzen, Produktleistung und aufkommende Markttrends gewinnen.

4

Forschungsdatenerfassung

Forscher aus verschiedenen Bereichen nutzen die KI-Datenextraktion, um systematisch spezifische Datenpunkte, Statistiken und Methodologien aus wissenschaftlichen Arbeiten, Berichten und Artikeln zu sammeln. Dies automatisiert den mühsamen Prozess der Literaturrecherche und Datensynthese und ermöglicht eine schnellere Analyse und Entdeckung.

5

Digitalisierung von Lieferkettendokumenten

Logistik- und Lieferkettenunternehmen nutzen die Datenextraktion, um Informationen aus Versandmanifesten, Frachtbriefen, Zollanmeldungen und Lieferbelegen zu digitalisieren und zu verarbeiten. Dies verbessert die Bestandsverwaltung, verfolgt Waren effizienter und erhöht die allgemeine Transparenz und Compliance der Lieferkette.

6

Abstraktion von Gesundheitsdaten

Gesundheitsdienstleister und medizinische Kodierer nutzen die Datenextraktion, um relevante Patienteninformationen, Diagnosen, Verfahren und Medikamentendetails aus unstrukturierten klinischen Notizen und Krankenakten zu abstrahieren. Dies optimiert die Abrechnung, gewährleistet eine genaue Kodierung für Versicherungsansprüche und unterstützt die klinische Forschung sowie Initiativen im Bereich der öffentlichen Gesundheit.

Datenextraktion FAQ

Was ist KI-Datenextraktion?

KI-Datenextraktion bezieht sich auf den Einsatz von Technologien der künstlichen Intelligenz, wie maschinelles Lernen und natürliche Sprachverarbeitung, um spezifische Informationen aus verschiedenen Dokumenten automatisch zu identifizieren, zu lokalisieren und zu extrahieren. Im Gegensatz zur einfachen Zeichenerkennung verstehen KI-Tools den Kontext und die Struktur, wodurch sie aussagekräftige Daten aus strukturierten und unstrukturierten Quellen wie Rechnungen, Verträgen und Berichten extrahieren und in ein nutzbares, organisiertes Format umwandeln können.

Wie unterscheidet sich die KI-Datenextraktion von herkömmlichem OCR?

Herkömmliche optische Zeichenerkennung (OCR) wandelt hauptsächlich Textbilder in maschinenlesbaren Text um, wobei der Fokus auf der Zeichenerkennung liegt, ohne den Inhalt zu verstehen. Die KI-Datenextraktion baut jedoch auf OCR auf, indem sie Intelligenz hinzufügt: Sie erkennt nicht nur Text, sondern versteht auch die Bedeutung und den Kontext der Daten. Dies ermöglicht es ihr, spezifische Datenfelder (z. B. Rechnungsnummern, Daten, Adressen) unabhängig von ihrer Position oder ihrem Layout zu identifizieren und diese Daten dann für die weitere Verarbeitung zu strukturieren, was sie für die Analyse komplexer Dokumente wesentlich leistungsfähiger macht.

Welche Arten von Dokumenten können KI-Datenextraktions-Tools verarbeiten?

KI-Datenextraktions-Tools sind äußerst vielseitig und können eine breite Palette von Dokumenttypen verarbeiten. Dazu gehören strukturierte Dokumente wie Formulare und Vorlagen, semistrukturierte Dokumente wie Rechnungen, Bestellungen und Quittungen sowie sogar hochgradig unstrukturierte Dokumente wie Rechtsverträge, Forschungsarbeiten, E-Mails und klinische Notizen. Sie können verschiedene Formate verarbeiten, darunter PDFs, gescannte Bilder, handschriftliche Dokumente und digitale Textdateien, wodurch sie an nahezu jeden Geschäftsanforderungen angepasst werden können.

Was sind die Hauptvorteile der Verwendung von KI-Datenextraktions-Tools?

Die Hauptvorteile der Verwendung von KI-Datenextraktions-Tools umfassen eine erheblich gesteigerte Effizienz durch die Automatisierung der manuellen Dateneingabe, was zu erheblichen Zeit- und Kosteneinsparungen führt. Sie verbessern die Datengenauigkeit drastisch, indem sie menschliche Fehler minimieren und so qualitativ hochwertigere Informationen für die Entscheidungsfindung gewährleisten. Darüber hinaus erhöhen diese Tools die Skalierbarkeit, sodass Unternehmen große Mengen an Dokumenten schnell verarbeiten können, und bieten eine bessere Compliance durch die Sicherstellung einer konsistenten Datenverarbeitung und Audit-Trails.

Wie kann die Datengenauigkeit bei der KI-Datenextraktion sichergestellt werden?

Um eine hohe Datengenauigkeit bei der KI-Datenextraktion zu gewährleisten, können verschiedene Strategien angewendet werden. Wählen Sie zunächst Tools mit robusten maschinellen Lernmodellen, die auf Ihre spezifischen Dokumententypen trainiert werden können. Implementieren Sie einen „Human-in-the-Loop“-Validierungsprozess, bei dem extrahierte Daten von menschlichen Bedienern überprüft und korrigiert werden, was auch dazu beiträgt, die KI im Laufe der Zeit neu zu trainieren und zu verbessern. Überwachen Sie regelmäßig Leistungsmetriken, geben Sie dem System klares Feedback und stellen Sie sicher, dass die Eingabedokumente von guter Qualität sind (z. B. klare Scans), um die Extraktionsergebnisse zu optimieren.