ToolMage
Anmelden

Best 3 Datenbank AI tools for Produktivität

Popular Datenbank AI tools in Produktivität include vika, Rowy und Tabidoo, helping you work more efficiently.

Tabidoo
Freemium

Tabidoo

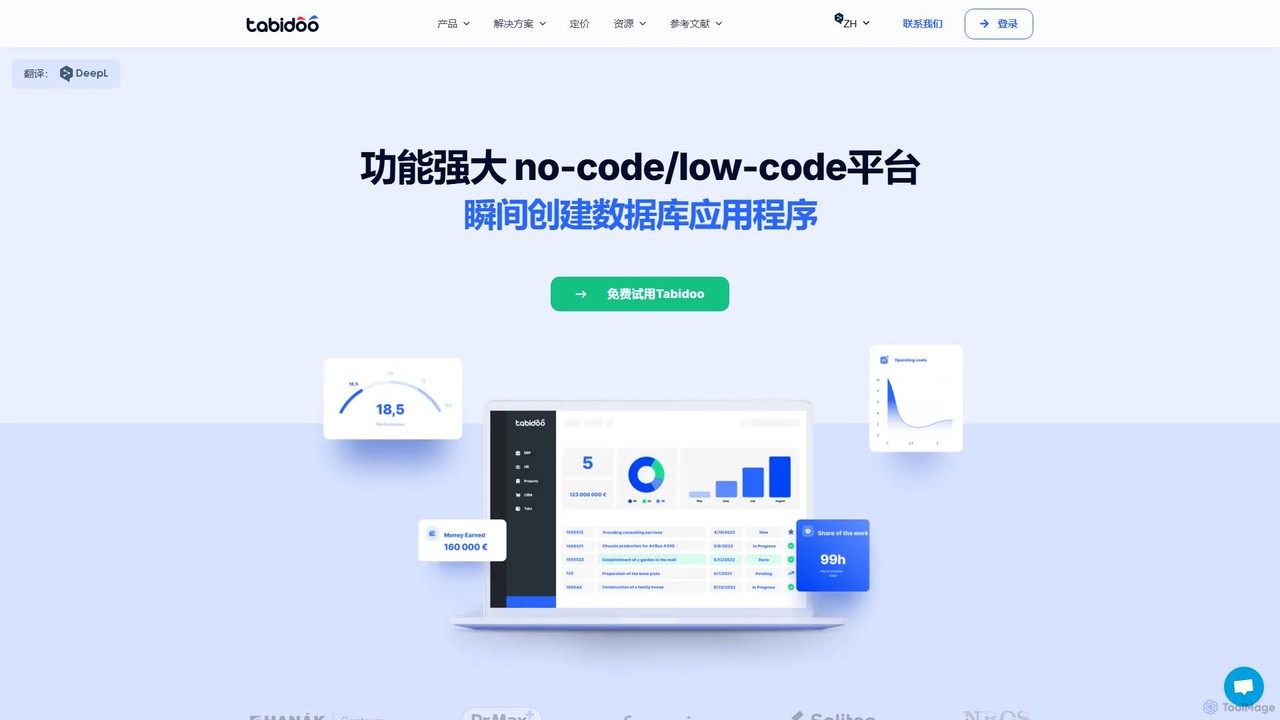
Tabidoo ist eine leistungsstarke Low-Code/No-Code-Plattform, mit der Sie benutzerdefinierte Geschäftsanwendungen und Datenbanken ohne Programmierung erstellen können. Verwalten Sie einfach Daten, automatisieren Sie Arbeitsabläufe und erstellen Sie Lösungen für CRM, Projektmanagement, HR und mehr. Es ist eine flexible, skalierbare und benutzerfreundliche Alternative zu komplexer Software und verstreuten Tabellenkalkulationen.

CRM
Visits 31.9KFavorites 135Likes 138
vika
Freemium

vika

vika ist eine wegweisende mehrdimensionale Tabelle und eine API-orientierte, einfach zu bedienende Low-Code-Plattform. Sie befähigt Teams, flexible, skalierbare digitale Systeme zu erstellen und Arbeitsabläufe ohne umfangreiche Programmierung zu automatisieren, indem sie die Funktionalität einer Datenbank mit der Einfachheit einer Tabellenkalkulation verbindet.

Projektmanagement
Visits 103.9KFavorites 118Likes 121
Rowy
Freemium

Rowy

Rowy ist eine Open-Source-Low-Code-Plattform, die eine Airtable-ähnliche Benutzeroberfläche für Firebase und Google Cloud bietet. Sie ermöglicht es Benutzern, Datenbanken zu verwalten, Cloud-Funktionen zu erstellen und Arbeitsabläufe mit der Einfachheit einer Tabellenkalkulation und der Leistungsfähigkeit von benutzerdefiniertem Code zu automatisieren.

Backend
Visits 37.2KFavorites 153Likes 170

About Datenbank

KI-Datenbanktools sind fortschrittliche Datenmanagementsysteme, die künstliche Intelligenz integrieren, um Datenoperationen zu automatisieren und zu verbessern. Sie nutzen maschinelle Lernalgorithmen für Aufgaben wie Leistungsoptimierung, Anomalieerkennung und die Ermöglichung von Abfragen in natürlicher Sprache, wodurch die Notwendigkeit von komplexem Code entfällt. Dies ermöglicht es Benutzern, intuitiver mit Daten zu interagieren, tiefere Einblicke zu gewinnen und intelligentere, datengesteuerte Anwendungen zu erstellen. Als spezialisierter Bereich der Produktivität reduzieren diese Datenbanken den manuellen Aufwand für die Datenverwaltung und -analyse erheblich.

Kernfunktionen

  • Abfragen in natürlicher Sprache: Stellen Sie Fragen und rufen Sie Daten in einfacher, umgangssprachlicher Sprache ab, anstatt komplexes SQL zu verwenden.
  • Automatische Leistungsoptimierung: Das System optimiert selbstständig Indizes, Abfragepläne und Ressourcenzuweisungen für maximale Effizienz.
  • In-Database Machine Learning: Führen Sie Vorhersagemodelle und KI-Algorithmen direkt auf den Daten aus, ohne separate ML-Plattformen zu benötigen.
  • Vektorsuche: Suchen Sie effizient nach ähnlichen Elementen basierend auf semantischer Bedeutung, was für KI-Anwendungen wie Empfehlungssysteme entscheidend ist.

Anwendungsfälle

Diese Tools sind ideal für Entwickler, die intelligente Anwendungen erstellen, Datenwissenschaftler, die die Bereitstellung von Modellen optimieren möchten, und Geschäftsanalysten, die komplexe Abfragen ohne tiefes technisches Wissen durchführen müssen. Gängige Anwendungen umfassen Echtzeit-Betrugserkennung, semantische Suchmaschinen und prädiktive Business-Intelligence-Dashboards.

Wie man wählt

Bei der Auswahl einer KI-Datenbank sollten Sie deren Kompatibilität mit Ihren bestehenden Datenstrukturen (SQL, NoSQL) berücksichtigen. Bewerten Sie die Raffinesse ihrer KI-Funktionen, wie die Genauigkeit der Verarbeitung natürlicher Sprache und die Bandbreite der integrierten ML-Modelle. Bewerten Sie auch ihre Skalierbarkeit zur Bewältigung wachsender Datenmengen und ihre Integrationsfähigkeiten mit anderen Analyse- und Entwicklungstools.

Datenbank use cases

1

Business-Intelligence-Berichterstattung in natürlicher Sprache

Ein Geschäftsanalyst muss die vierteljährlichen Verkaufstrends verstehen, ist aber nicht versiert in SQL. Mit einer KI-Datenbank kann er einfach Fragen eingeben wie „Zeige mir die Top-5-Produkte nach Umsatz in Nordamerika für Q2“ oder „Vergleiche das Umsatzwachstum zwischen diesem und dem letzten Quartal für die Elektronikkategorie“. Die Natural Language Processing (NLP)-Engine der Datenbank übersetzt diese Anfragen in komplexe Abfragen, ruft die Daten ab und präsentiert sie oft in zusammengefasster oder visualisierter Form. Dies befähigt nicht-technische Benutzer, Self-Service-Analysen durchzuführen, was ihre Abhängigkeit von Datenteams verringert und den Entscheidungsprozess beschleunigt.

2

Aufbau einer semantischen Suchmaschine für den E-Commerce

Ein E-Commerce-Entwickler möchte die Produktfindung über einfaches Keyword-Matching hinaus verbessern. Er verwendet eine KI-Datenbank mit Vektorsuchfunktionen. Zuerst werden Produktbeschreibungen und -attribute in numerische Vektoren (Embeddings) umgewandelt und gespeichert. Wenn ein Benutzer nach „warme Jacke für Winterwanderungen“ sucht, sucht die Datenbank nicht nur nach diesen exakten Wörtern. Stattdessen wandelt sie die Anfrage in einen Vektor um und findet Produkte mit den ähnlichsten Vektoren, wie „isolierter Parka“ oder „Thermo-Fleece-Mantel“. Dieses semantische Verständnis führt zu relevanteren Suchergebnissen, einer besseren Benutzererfahrung und erhöhten Konversionsraten.

3

Automatisierung des Datenbank-Leistungsmanagements

Ein Datenbankadministrator (DBA) ist für die Aufrechterhaltung der Leistung einer großen, komplexen Anwendungsdatenbank verantwortlich. Anstatt die Abfrageleistung manuell zu überwachen und zu entscheiden, welche Indizes erstellt oder gelöscht werden sollen, verwendet er eine KI-Datenbank mit automatischer Optimierung. Das System analysiert kontinuierlich Abfragemuster und Datenverteilung. Es kann proaktiv Indizes erstellen, um langsame Abfragen außerhalb der Spitzenzeiten zu beschleunigen, und ungenutzte Indizes entfernen, um Speicherplatz zu sparen. Es kann auch potenzielle Engpässe vorhersagen und Ressourcen neu zuweisen, bevor die Leistung nachlässt, wodurch der DBA sich auf strategische Aufgaben wie Datenarchitektur und Sicherheit anstatt auf routinemäßige Wartung konzentrieren kann.

4

Echtzeit-Anomalieerkennung in IoT-Daten

Ein produzierendes Unternehmen sammelt pro Sekunde Millionen von Datenpunkten von Sensoren in seiner Fabrikhalle. Ein Dateningenieur verwendet eine KI-Datenbank mit In-Database Machine Learning, um Anomalien in Echtzeit zu erkennen. Er definiert ein Modell direkt in der Datenbank, um Sensormesswerte wie Temperatur und Vibration zu überwachen. Wenn die Sensordaten einer Maschine von ihrem normalen Betriebsmuster abweichen, löst die Datenbank sofort einen Alarm aus. Dies ermöglicht eine vorausschauende Wartung, die kostspielige Geräteausfälle und Produktionsstillstände verhindert, und das alles ohne die Komplexität, riesige Datenströme zur Analyse in ein separates System zu verschieben.

5

Prädiktive Kundenabwanderungsanalyse

Ein Datenwissenschaftler bei einem abonnementbasierten Dienstleistungsunternehmen möchte Kunden identifizieren, bei denen das Risiko einer Abwanderung besteht. Er verwendet eine KI-Datenbank mit integrierten maschinellen Lernfunktionen. Indem er ein Klassifizierungsmodell direkt auf Kundendaten – einschließlich Nutzungsmustern, Support-Ticket-Verlauf und Abonnementdauer – ausführt, kann er für jeden Benutzer einen „Abwanderungsrisiko-Score“ generieren. Dieser Prozess ist viel schneller als der Export von Daten in ein externes Modellierungstool. Das Marketingteam kann diese Scores dann nutzen, um gefährdete Kunden mit proaktiven Bindungskampagnen wie Sonderangeboten oder personalisiertem Support anzusprechen und so letztendlich Umsatzverluste zu reduzieren.

6

Intelligente Automatisierung der Datenqualität

Ein Data-Governance-Team hat die Aufgabe, die Genauigkeit und Konsistenz der Daten in einem großen Unternehmen sicherzustellen. Sie setzen eine KI-Datenbank ein, die automatisch Datenqualitätsprobleme scannen und identifizieren kann. Die KI-Modelle können Anomalien wie inkonsistente Formatierungen (z. B. „USA“ vs. „United States“), Ausreißerwerte und doppelte Datensätze mit geringfügigen Abweichungen erkennen. Das System markiert nicht nur diese Probleme, sondern kann auch Korrekturen auf der Grundlage erlernter Muster vorschlagen oder automatisch anwenden. Dies automatisiert einen erheblichen Teil des Datenbereinigungsprozesses, verbessert die allgemeine Datenzuverlässigkeit und gibt dem Team die Freiheit, sich auf komplexere Governance-Richtlinien zu konzentrieren.

Datenbank FAQ

Was ist eine KI-Datenbank?

Eine KI-Datenbank ist ein Datenbankmanagementsystem, das mit künstlicher Intelligenz und maschinellen Lernfähigkeiten erweitert wurde. Im Gegensatz zu herkömmlichen Datenbanken, die Daten nur auf der Grundlage expliziter Befehle speichern und abrufen, kann eine KI-Datenbank Aufgaben autonom ausführen. Zu den Hauptmerkmalen gehören die automatische Leistungsoptimierung, die Möglichkeit, Daten in natürlicher Sprache abzufragen, und die Ausführung von prädiktiven Analysen direkt in der Datenbank. Dies macht die Datenverwaltung effizienter und die Datenanalyse für eine breitere Palette von Benutzern zugänglicher.

Wie unterscheidet sich eine KI-Datenbank von einer herkömmlichen SQL/NoSQL-Datenbank?

Der Hauptunterschied liegt in der Intelligenz und Automatisierung. Während herkömmliche Datenbanken manuelle Verwaltung und präzise Abfragesprachen (wie SQL) erfordern, automatisieren KI-Datenbanken viele dieser Aufgaben. Zu den wichtigsten Unterscheidungen gehören:

  • Abfragen: Herkömmliche Datenbanken benötigen strukturierte Abfragen. KI-Datenbanken können oft natürliche Sprache interpretieren.
  • Optimierung: DBAs optimieren herkömmliche Datenbanken manuell. KI-Datenbanken verwenden maschinelles Lernen zur Selbstoptimierung der Leistung.
  • Analyse: Herkömmliche Datenbanken erfordern den Export von Daten in andere Tools zur Analyse. KI-Datenbanken können ML-Modelle intern ausführen und ermöglichen so Echtzeit-Vorhersagen.
Im Wesentlichen entwickeln sich KI-Datenbanken von passiven Datenspeichern zu aktiven Teilnehmern am Datenanalyseprozess.

Welche Schlüsselfunktionen sollte man bei einem KI-Datenbanktool beachten?

Bei der Bewertung einer KI-Datenbank sollten Sie sich auf Funktionen konzentrieren, die greifbare Automatisierung und analytische Leistung bieten. Zu den wichtigsten zu berücksichtigenden Funktionen gehören:

  • Verarbeitung natürlicher Sprache (NLP): Die Fähigkeit, Abfragen in menschlicher Sprache zu verstehen und zu verarbeiten.
  • Automatische Optimierung: Selbstoptimierungsfunktionen für Indizes, Abfragen und Ressourcenmanagement.
  • In-Database ML: Unterstützung für das Training und die Bereitstellung von maschinellen Lernmodellen direkt in der Datenbank.
  • Vektorsuche: Effiziente Indizierung und Suche von hochdimensionalen Vektordaten für semantische Such- und Ähnlichkeitsaufgaben.
  • Skalierbarkeit und Leistung: Die Fähigkeit, große Datensätze und hohe Abfragelasten ohne Leistungseinbußen zu bewältigen.

Wer sollte eine KI-Datenbank verwenden?

KI-Datenbanken sind für eine Vielzahl von Rollen von Vorteil. Entwickler können sie verwenden, um intelligentere Anwendungen mit Funktionen wie semantischer Suche und Echtzeitempfehlungen zu erstellen. Datenwissenschaftler können ihren Arbeitsablauf beschleunigen, indem sie Modelle direkt auf den Daten ausführen und so komplexe Datenpipelines eliminieren. Geschäftsanalysten und nicht-technische Benutzer können durch Abfragen in natürlicher Sprache direkten Zugriff auf Dateneinblicke erhalten, ohne SQL lernen zu müssen. Schließlich können Datenbankadministratoren (DBAs) Automatisierungsfunktionen nutzen, um den manuellen Wartungsaufwand zu reduzieren und sich auf übergeordnete strategische Initiativen zu konzentrieren.

Ist die Migration von einer herkömmlichen Datenbank zu einer KI-Datenbank schwierig?

Die Schwierigkeit der Migration hängt von der spezifischen KI-Datenbank und Ihrem bestehenden System ab. Viele moderne KI-Datenbanken sind so konzipiert, dass sie mit Standard-SQL kompatibel sind, was den Prozess vereinfachen kann. Sie bieten oft Tools und Dokumentationen, um die Migration zu erleichtern. Herausforderungen können sich jedoch aus Unterschieden im Datenschema, der Notwendigkeit, Anwendungscode umzuschreiben, um neue KI-Funktionen zu nutzen, und der Lernkurve für das Team ergeben. Es ist ratsam, mit einem Proof-of-Concept auf einem unkritischen Datensatz zu beginnen, um den Aufwand und die potenziellen Vorteile vor einer vollständigen Migration zu verstehen.