
ToolMage
Anmelden

Best 1 Benchmarking AI tools for Forschung

Popular Benchmarking AI tools in Forschung include LMArena, helping you work more efficiently.

LMArena
Free

LMArena

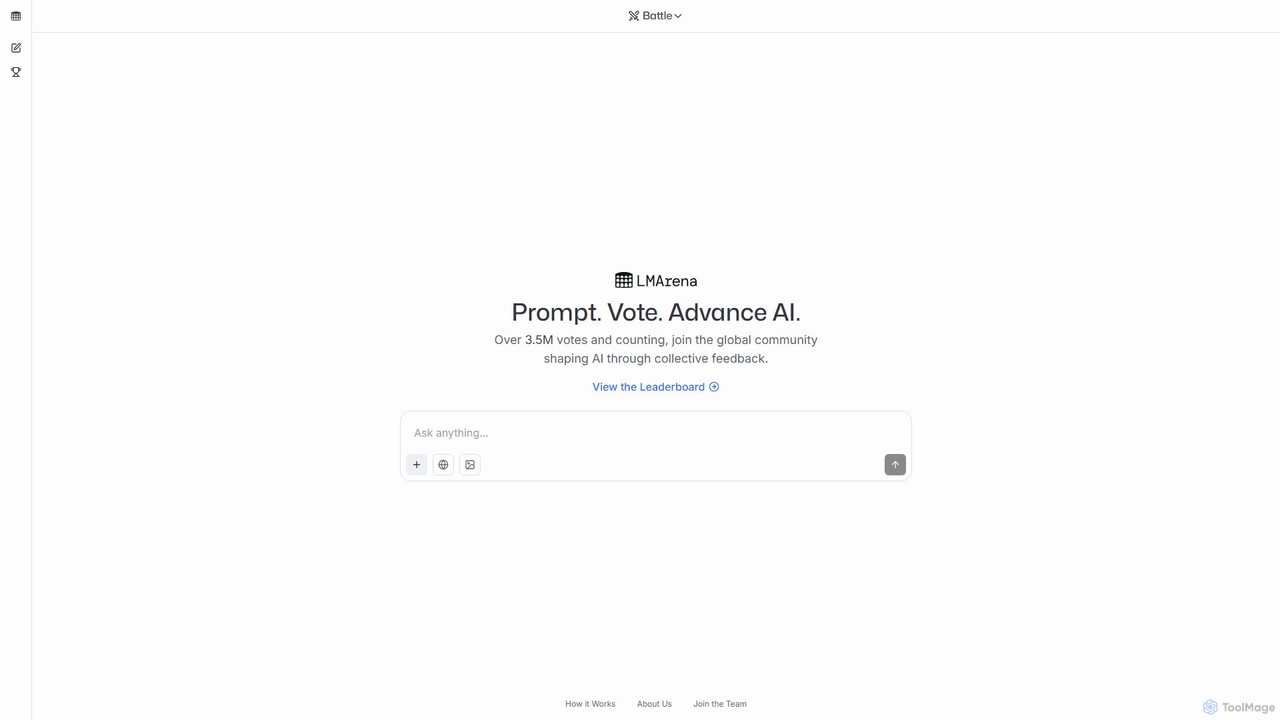
LMArena ist eine offene, Crowdsourcing-Plattform von Forschern der UC Berkeley zur Bewertung und zum Vergleich führender KI-Modelle. Benutzer testen anonym zwei Modelle nebeneinander, stimmen für die beste Antwort ab und tragen zu einer dynamischen, öffentlichen Rangliste bei. Ziel ist es, den KI-Fortschritt transparent und auf der Grundlage von realem menschlichem Feedback zu gestalten.

Künstliche Intelligenz
Visits 631.4KFavorites 141Likes 112

About Benchmarking

KI-Benchmarking-Tools sind eine Klasse von Software, die entwickelt wurde, um die Leistung von KI-Modellen und -Systemen systematisch zu messen, zu vergleichen und zu bewerten. Sie führen standardisierte Tests mit verschiedenen Modellen durch, wobei konsistente Datensätze und Bewertungsmetriken wie Genauigkeit, Geschwindigkeit oder Ressourcenverbrauch verwendet werden. Dieser Prozess liefert objektive, datengesteuerte Einblicke, die es Entwicklern und Forschern ermöglichen, die effektivsten Modelle für bestimmte Aufgaben zu identifizieren und den Fortschritt auf dem Gebiet zu verfolgen. Als wichtiger Teil des KI-Forschungs-Toolkits sind diese Werkzeuge unerlässlich, um die Fähigkeiten von Modellen zu validieren und Transparenz in der KI-Entwicklung zu gewährleisten.

Kernfunktionen

  • Standardisierte Testsuiten: Bietet vorgefertigte Sammlungen von Datensätzen und Aufgaben zur Bewertung von Modellen in Bereichen wie NLP und Computer Vision.
  • Leistungsmetrik-Tracking: Automatisiert die Berechnung und Visualisierung von Schlüsselmetriken wie Genauigkeit, F1-Score, Latenz und Durchsatz.
  • Vergleichende Ranglisten: Erstellt öffentliche oder private Ranglisten verschiedener Modelle basierend auf ihrer Leistung bei spezifischen Benchmarks.
  • Ressourcennutzungsanalyse: Überwacht und berichtet über Rechenkosten, einschließlich CPU/GPU-Nutzung und Speicherverbrauch während der Tests.
  • Reproduzierbarkeits-Frameworks: Stellt sicher, dass Experimente durch Umgebungs-Snapshots oder Containerisierung zuverlässig von anderen wiederholt werden können.

Anwendungsfälle

KI-Benchmarking-Tools werden hauptsächlich von KI-Forschungslaboren, akademischen Einrichtungen und F&E-Teams in Unternehmen eingesetzt. Sie sind entscheidend in Bereichen wie der Entwicklung großer Sprachmodelle (LLM), der Forschung im Bereich Computer Vision und dem Testen autonomer Systeme, um neue Architekturen zu validieren und sie mit den modernsten Modellen zu vergleichen.

Wie man wählt

Berücksichtigen Sie bei der Auswahl eines Tools die unterstützten Modelltypen und Frameworks (z. B. PyTorch, TensorFlow). Bewerten Sie die Breite und Relevanz der verfügbaren Benchmark-Suiten für Ihre Domäne. Überprüfen Sie die Integrationsmöglichkeiten mit MLOps-Plattformen und Cloud-Infrastruktur und bewerten Sie die Klarheit der Berichts- und Visualisierungsfunktionen für eine einfachere Analyse.

Benchmarking use cases

1

Vergleich der LLM-Leistung für die Chatbot-Entwicklung

Ein Entwicklungsteam muss das beste große Sprachmodell (LLM) für seinen neuen Kundenservice-Chatbot auswählen. Sie verwenden ein Benchmarking-Tool, um drei verschiedene Modelle anhand eines benutzerdefinierten Datensatzes von Benutzeranfragen zu bewerten. Das Tool misst systematisch die Antwortgenauigkeit, Relevanz und Latenz für jedes Modell. Anschließend wird eine vergleichende Rangliste erstellt, die eine klare, datengesteuerte Grundlage für die Auswahl des kostengünstigsten und leistungsstärksten Modells bietet und so eine hochwertige Benutzererfahrung gewährleistet.

2

Validierung von Computer-Vision-Modellen für die Qualitätskontrolle

Ein Fertigungsunternehmen testet mehrere Objekterkennungsmodelle, um Fehler an einer Produktionslinie zu identifizieren. Mithilfe einer Benchmarking-Plattform laden sie ihren proprietären Datensatz mit Produktbildern hoch. Die Plattform führt standardisierte Tests durch, um die Präzision, den Recall und die Inferenzgeschwindigkeit jedes Modells auf spezifischer Edge-Hardware zu vergleichen. Der resultierende Bericht ermöglicht es ihnen, das zuverlässigste und effizienteste System einzusetzen und Produktionsfehler zu minimieren.

3

Akademische Forschung und Veröffentlichung von Artikeln

Eine universitäre Forschungsgruppe entwickelt eine neuartige neuronale Netzwerkarchitektur. Um deren Überlegenheit gegenüber bestehenden Methoden zu beweisen, verwenden sie ein öffentliches Benchmarking-Tool. Sie führen ihr Modell auf etablierten akademischen Datensätzen wie ImageNet oder SQuAD aus und vergleichen die Ergebnisse mit den modernsten Modellen, die auf öffentlichen Ranglisten aufgeführt sind. Dies liefert überprüfbare, reproduzierbare Nachweise für die Leistung ihres Modells, stärkt ihre Forschungsarbeit und leistet einen Beitrag zur wissenschaftlichen Gemeinschaft.

4

Optimierung der Algorithmus-Effizienz zur Senkung der Cloud-Kosten

Ein MLOps-Team zielt darauf ab, die Betriebskosten seiner KI-Dienste zu senken. Sie verwenden ein Benchmarking-Tool, um den Ressourcenverbrauch (GPU-Zeit, Speicher) ihrer bereitgestellten Modelle unter verschiedenen Lastbedingungen zu analysieren. Das Tool hilft ihnen, ineffiziente Modelle zu identifizieren und optimierte Versionen nebeneinander zu testen. Durch den Vergleich des Preis-Leistungs-Verhältnisses können sie Modellvarianten auswählen und bereitstellen, die eine ähnliche Genauigkeit bei einer quantifizierbaren Reduzierung ihrer monatlichen Cloud-Computing-Rechnung liefern.

5

Regressionstests in CI/CD-Pipelines für KI

Ein Softwareunternehmen integriert ein KI-Benchmarking-Tool in seine CI/CD-Pipeline. Jedes Mal, wenn ein Entwickler ein Update für ein Modell eincheckt, löst die Pipeline automatisch einen Benchmark-Test gegen einen Basisdatensatz aus. Dies stellt sicher, dass die jüngsten Änderungen die Leistung oder Genauigkeit nicht negativ beeinflusst haben. Wenn eine Regression festgestellt wird (z. B. ein Genauigkeitsabfall um 2 %), schlägt der Build fehl, wodurch verhindert wird, dass ein verschlechtertes Modell in die Produktion gelangt und die Servicequalität aufrechterhalten wird.

6

Auswahl von Drittanbieter-KI-APIs basierend auf der Leistung

Ein Startup muss eine Drittanbieter-API für die Sprache-zu-Text-Transkription auswählen. Anstatt sich auf Marketingaussagen zu verlassen, verwenden sie ein Benchmarking-Tool, um denselben Satz von Audiodateien an mehrere Anbieter zu senden. Das Tool misst und vergleicht objektiv die Wortfehlerrate (WER), die Verarbeitungszeit und die Kosten pro Anfrage für jeden Dienst. Dieser datengesteuerte Ansatz ermöglicht es ihnen, die API auszuwählen, die das beste Gleichgewicht zwischen Genauigkeit und Kosten für ihren spezifischen Anwendungsfall bietet.

Benchmarking FAQ

Was sind KI-Benchmarking-Tools?

KI-Benchmarking-Tools sind spezialisierte Plattformen, die zur systematischen Bewertung und zum Vergleich der Leistung verschiedener KI-Modelle oder -Systeme verwendet werden. Sie bieten eine kontrollierte Umgebung, standardisierte Datensätze und konsistente Metriken, um objektive, wiederholbare Messungen von Fähigkeiten wie Genauigkeit, Geschwindigkeit und Effizienz zu erstellen. Dies ermöglicht es Entwicklern und Forschern, verschiedene Modelle zu bewerten und den technologischen Fortschritt im Laufe der Zeit zu verfolgen.

Wie wähle ich das richtige KI-Benchmarking-Tool aus?

Um das richtige Tool auszuwählen, berücksichtigen Sie diese Schlüsselfaktoren:

  • Benchmark-Abdeckung: Stellen Sie sicher, dass es die für Ihre Arbeit relevanten Aufgaben und Domänen unterstützt (z. B. NLP, Computer Vision, Spracherkennung).
  • Framework-Kompatibilität: Überprüfen Sie, ob es mit Ihren bevorzugten Modell-Frameworks wie PyTorch, TensorFlow oder ONNX funktioniert.
  • Anpassung: Stellen Sie fest, ob Sie Ihre eigenen privaten Datensätze verwenden und benutzerdefinierte Bewertungsmetriken definieren können.
  • Integration: Bewerten Sie die Fähigkeit zur Integration in Ihren bestehenden MLOps-Workflow, Ihre CI/CD-Pipelines und Ihre Cloud-Umgebung.
Was ist der Unterschied zwischen Benchmarking und Modellbewertung?

Modellbewertung ist ein allgemeiner Begriff für die Beurteilung der Leistung eines einzelnen Modells auf einem Datensatz. Benchmarking ist eine strukturiertere und vergleichendere Form der Bewertung. Es beinhaltet das Testen mehrerer Modelle auf denselben standardisierten Datensätzen und Aufgaben unter kontrollierten Bedingungen, um einen formellen Vergleich oder eine Rangliste zu erstellen. Der Hauptunterschied besteht darin, dass Benchmarking den standardisierten, reproduzierbaren Vergleich über mehrere Modelle hinweg betont, während die Bewertung eine einmalige Beurteilung eines einzelnen Modells sein kann.

Welche gängigen Metriken werden beim KI-Benchmarking verwendet?

Metriken variieren je nach Aufgabe erheblich. Einige gängige Beispiele sind:

  • Klassifizierungsaufgaben: Genauigkeit, Präzision, Recall und F1-Score werden häufig zur Messung der Korrektheit verwendet.
  • Sprachmodelle: Perplexität (für die Sprachmodellierung) und BLEU/ROUGE-Scores (für Übersetzung und Zusammenfassung) sind Standard.
  • Objekterkennung: Die mittlere durchschnittliche Präzision (mAP) ist eine Schlüsselmetrik.
  • Systemleistung: Latenz (Antwortzeit), Durchsatz (Abfragen pro Sekunde) und Ressourcennutzung (GPU/CPU-Zyklen, Speicher) sind entscheidend für die Produktionsreife.
Wer sollte KI-Benchmarking-Tools verwenden?

KI-Benchmarking-Tools richten sich hauptsächlich an technische Benutzer, die am KI-Entwicklungslebenszyklus beteiligt sind. Dazu gehören KI/ML-Forscher, die neue Architekturen validieren, Datenwissenschaftler, die Modelle für ein bestimmtes Geschäftsproblem vergleichen, und MLOps-Ingenieure, die die Modellleistung überwachen und Regressionen in der Produktion verhindern. Im Wesentlichen kann jeder, der objektive, datengesteuerte Entscheidungen über die Auswahl, Bereitstellung oder Verbesserung von KI-Modellen treffen muss, von diesen Tools profitieren.