ToolMage
Anmelden

AI TOOL COMPARISON

Browserless vs Scrappey

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Browserless Produktübersicht

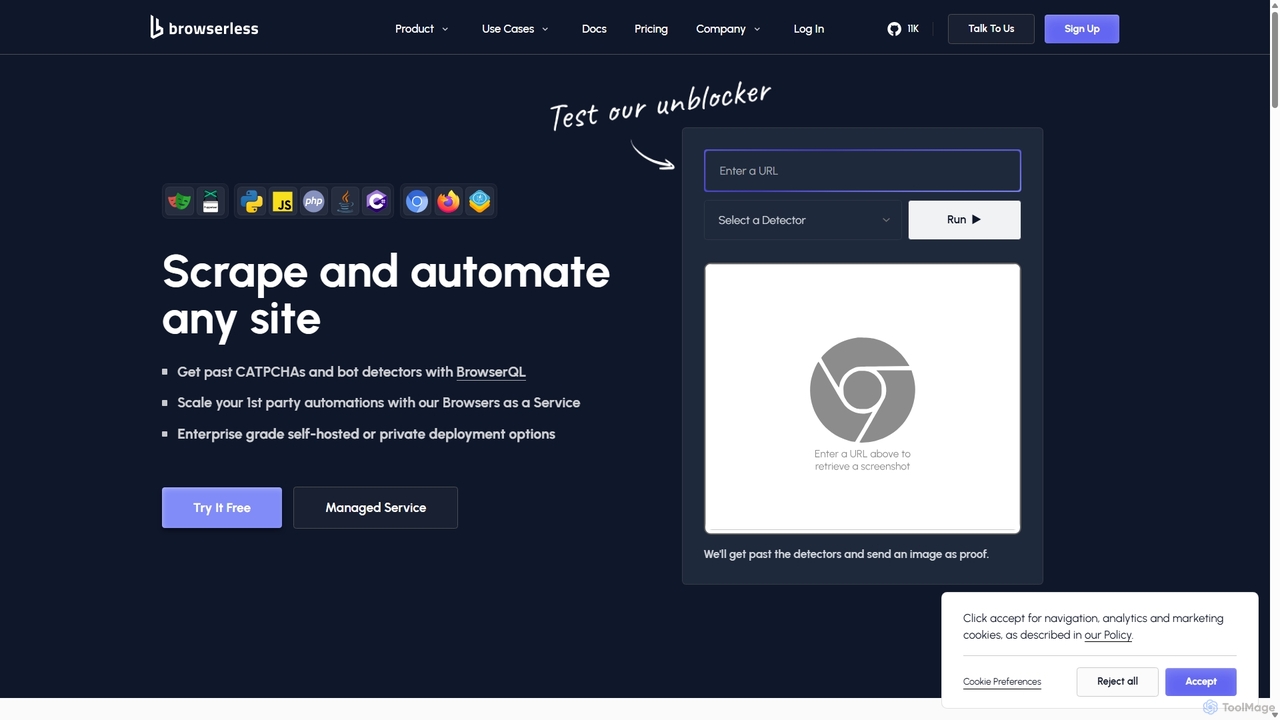
Browserless ist eine leistungsstarke Browser-as-a-Service (BaaS)-Plattform für skalierbares Web-Scraping und Browser-Automatisierung. Sie hilft Entwicklern, CAPTCHAs und Bot-Detektoren mühelos mit Puppeteer, Playwright oder der proprietären Sprache BrowserQL zu umgehen. Der Dienst verwaltet die Browser-Infrastruktur, sodass sich Benutzer auf die Erstellung von Automatisierungsskripten konzentrieren können, ohne sich um Updates, Speicherlecks oder Skalierung kümmern zu müssen.

Preview

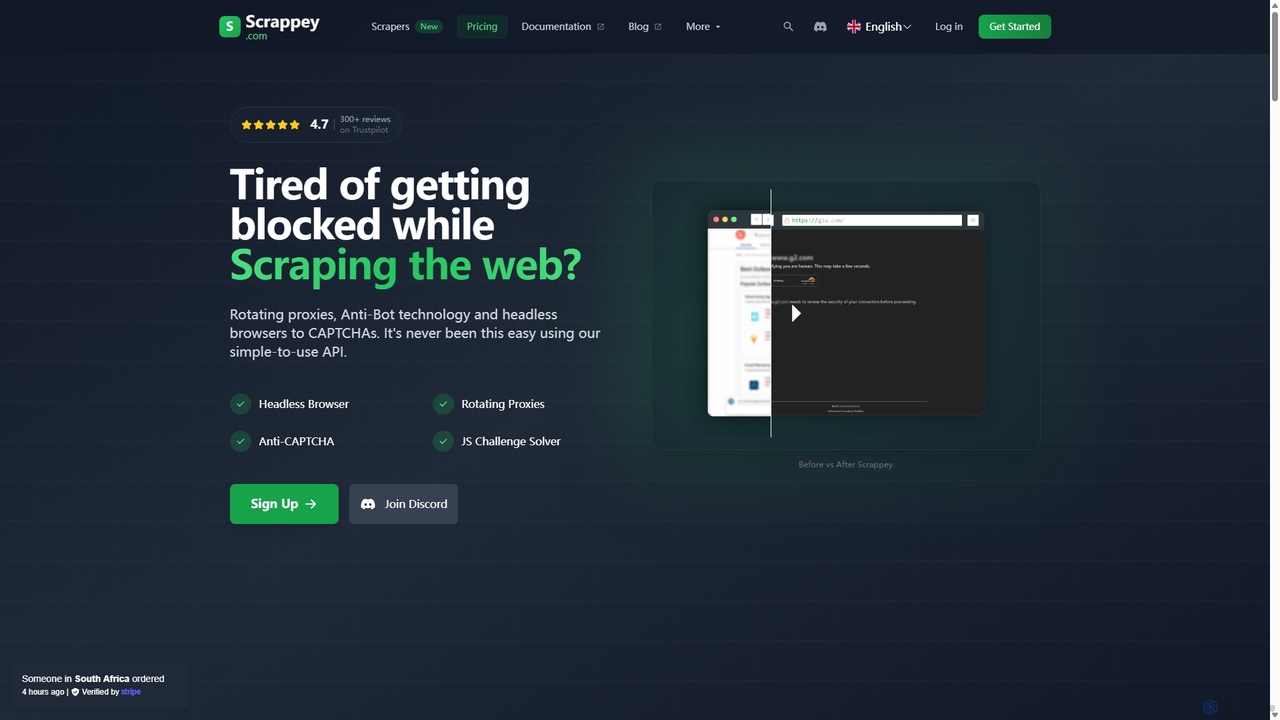
Scrappey Produktübersicht

Scrappey ist eine fortschrittliche Web-Scraping-API, die für Entwickler entwickelt wurde, um mühelos Daten von jeder Website zu extrahieren. Sie bewältigt alle Komplexitäten wie rotierende Proxys, Headless-Browser und die Umgehung von Anti-Bot-Maßnahmen wie Cloudflare und CAPTCHAs. Mit einer hohen Erfolgsquote und einem einfachen Pay-as-you-go-Modell optimiert Scrappey die Datenerfassung für verschiedene Anwendungen.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Browserless VS Scrappey — Kerndaten
KerndatenBrowserlessScrappey
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusDatenextraktionDatenextraktion
Zielgruppen und RollenDatenanalyst · Datenwissenschaftler · DevOps-Ingenieur · Marketing Manager · Produktmanager · QA Ingenieur · SoftwareentwicklerBusiness Analyst · Datenanalyst · Datenwissenschaftler · Marketing Manager · Produktmanager · Forscher · SEO-Spezialist · Softwareentwickler
KategorienDatenextraktion · Web Scraping · AutomatisierungDatenextraktion · Web Scraping · Marktforschung
Added15.09.202511.09.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Browserless

Browserless ist eine umfassende cloudbasierte Plattform, die Headless-Browser-Instanzen für eine Vielzahl von Web-Automatisierungs- und Datenextraktionsaufgaben bereitstellt. Sie wurde entwickelt, um die häufigen Herausforderungen zu lösen, mit denen Entwickler bei der Arbeit mit Headless-Browsern im großen Maßstab konfrontiert sind, wie z. B. Infrastrukturmanagement, Leistungsprobleme und die Umgehung ausgeklügelter Bot-Erkennungssysteme. Durch das Angebot eines robusten Pools verwalteter Browser ermöglicht Browserless Entwicklern und Unternehmen, sich auf ihre Kernlogik zu konzentrieren, anstatt auf die Komplexität der Bereitstellung und Wartung von Browser-Automatisierungssystemen.

Der Dienst wird von Tausenden von Unternehmen, von Start-ups bis hin zu Großunternehmen, für seine Zuverlässigkeit, Skalierbarkeit und fortschrittlichen Funktionen geschätzt. Er bietet sowohl verwaltete Cloud-Dienste als auch selbst gehostete Unternehmenslösungen und bietet Flexibilität für unterschiedliche Sicherheits- und Compliance-Anforderungen, einschließlich der SOC 2 Typ II-Konformität.

Wie man Browserless verwendet

Browserless bietet mehrere Möglichkeiten, seine Dienste in Ihren Arbeitsablauf zu integrieren, wodurch es für verschiedene Fähigkeitsstufen und Projektanforderungen zugänglich wird:

  1. Verbindung mit Puppeteer oder Playwright: Der einfachste Weg, um loszulegen, ist die Verbindung Ihrer bestehenden Puppeteer- oder Playwright-Skripte. Anstatt eine lokale Browser-Instanz zu starten, ändern Sie einfach die Verbindungsmethode, um auf einen Browserless-WebSocket-Endpunkt zu verweisen. Dies erfordert minimale Codeänderungen und skaliert Ihre bestehenden Automatisierungen sofort.
  2. Verwendung von REST-APIs: Für gängige Aufgaben wie das Erstellen von PDFs, das Aufnehmen von Screenshots oder das Extrahieren von HTML-Inhalten bietet Browserless einfache REST-APIs. Sie können eine cURL-Anfrage stellen oder einen beliebigen HTTP-Client verwenden, um diese Aktionen ohne das Schreiben komplexer Browser-Automatisierungsskripte durchzuführen.
  3. Nutzung von BrowserQL: Für fortgeschrittene Anwendungsfälle, insbesondere solche, die das Umgehen von hartnäckigen Bot-Detektoren (wie Cloudflare) beinhalten, bietet Browserless BrowserQL an. Dies ist eine Automatisierungssprache und IDE der nächsten Generation, die darauf ausgelegt ist, minimale Fingerabdrücke zu hinterlassen. Sie können prägnante Abfragen schreiben, um komplexe Aktionen wie das Klicken von Schaltflächen, das Lösen von CAPTCHAs und das Extrahieren strukturierter Daten durchzuführen, während Sie für Erkennungssysteme menschlicher erscheinen.
  4. Hybride Automatisierungen: Browserless unterstützt hybride Arbeitsabläufe, bei denen Sie eine Browser-Sitzung in ein iframe streamen können. Dies ist nützlich für Aufgaben, die manuelle Eingriffe erfordern, wie das Lösen eines komplexen CAPTCHAs, die Eingabe von 2FA-Codes oder die Handhabung von OAuth-Logins innerhalb eines automatisierten Skripts.

Kernfunktionen von Browserless

  • BrowserQL: Eine proprietäre Abfragesprache und IDE, die von Grund auf entwickelt wurde, um die fortschrittlichsten Bot-Detektoren durch Minimierung von Browser-Fingerabdrücken zu umgehen.
  • Browser as a Service (BaaS): Ein skalierbarer, verwalteter Pool von Tausenden von Browsern, der alle Infrastrukturaspekte wie Versionsupdates, Lastausgleich und Ressourcenmanagement übernimmt.
  • Bot-Erkennung & CAPTCHA-Umgehung: Spezialisierte Technologie zur automatischen Lösung von CAPTCHAs (reCAPTCHA, hCaptcha) und zum Umgehen von Bot-Blocking-Diensten wie Cloudflare.
  • Puppeteer & Playwright-Integration: Nahtlose Kompatibilität mit den beiden beliebtesten Browser-Automatisierungsbibliotheken.
  • REST-APIs: Einfache Endpunkte für gängige Aufgaben wie PDF-Erstellung, Screenshots und Content-Scraping.
  • Sitzungsmanagement & Wiederverbindungen: Die Fähigkeit, Browser-Sitzungen am Leben zu erhalten und sich wieder mit ihnen zu verbinden, was die Proxy-Nutzung erheblich reduziert und wiederholte Bot-Prüfungen vermeidet.
  • Unternehmenslösungen: Optionen für Self-Hosting, private Cloud-Bereitstellungen, benutzerdefinierte Maschinen-Setups (einschließlich GPUs), SSO, dedizierten Support und SOC 2 Typ II-Konformität.
  • Überwachung & Debugging: Ein benutzerfreundliches Dashboard bietet Metriken zu Anfragen, Worker-Gesundheit (CPU/Speicher) und einen Debugger, um Skripte in Echtzeit laufen zu sehen.

Anwendungsfälle für Browserless

Browserless ist vielseitig und kann in zahlreichen Szenarien angewendet werden:

  • Web-Scraping & Datenextraktion: Sammeln von Daten von dynamischen, JavaScript-lastigen Websites, E-Commerce-Plattformen (z. B. Walmart, eBay), Immobilienangeboten (Zillow) und Jobbörsen (Indeed).
  • Automatisierte Softwaretests: Ausführen von End-to-End-Tests für Webanwendungen im großen Maßstab, Integration mit Frameworks wie Laravel Dusk ohne die Notwendigkeit, ein komplexes Selenium Grid zu verwalten.
  • KI & LLM-Datenerfassung: Versorgung von KI-Agenten (z. B. mit LangChain oder CrewAI) mit Echtzeit-Webzugriff, um frische Daten für das Training großer Sprachmodelle oder die Durchführung automatisierter Recherchen zu sammeln.
  • Berichterstellung: Automatisches Erstellen von PDFs und Screenshots von Dashboards, Analyseberichten oder Rechnungen aus Webanwendungen.
  • Preis- & Wettbewerbsüberwachung: Verfolgung von Produktpreisen, Lagerbeständen und Wettbewerbsstrategien bei verschiedenen Online-Händlern.

Vorteile von Browserless

Die Verwendung von Browserless bietet mehrere entscheidende Vorteile:

  • Reduzierter Betriebsaufwand: Eliminiert die Notwendigkeit eines dedizierten Teams zum Aufbau, zur Bereitstellung und zur Wartung einer komplexen Browser-Automatisierungsinfrastruktur.
  • Erhöhte Erfolgsraten: Seine fortschrittlichen Bot-Umgehungstechniken, insbesondere mit BrowserQL, führen zu höheren Erfolgsraten beim Scrapen geschützter Websites.
  • Skalierbarkeit bei Bedarf: Skaliert mühelos von wenigen gleichzeitigen Sitzungen auf Tausende und bewältigt Verkehrsspitzen ohne Leistungseinbußen.
  • Kosteneffizienz: Funktionen wie Sitzungswiederverbindungen können die Proxy-Kosten um bis zu 90 % senken. Das einheitenbasierte Preismodell ist vorhersehbar und kostengünstig.
  • Entwicklerfokussiert: Von Entwicklern für Entwickler konzipiert, mit ausgezeichneter Dokumentation, SDKs und reaktionsschnellem technischen Support.

Preise und Pläne

Browserless bietet ein flexibles, einheitenbasiertes Preismodell für unterschiedliche Bedürfnisse:

  • Kostenloser Plan: Beinhaltet 1.000 Einheiten pro Monat, 1 maximal gleichzeitigen Browser und Zugriff auf den BrowserQL-Editor. Keine Kreditkarte erforderlich.
  • Prototyping-Plan: Beginnt bei 25 $/Monat (jährlich abgerechnet) für 20.000 Einheiten und 3 gleichzeitige Browser. Ideal für kleine Projekte und Tests.
  • Starter-Plan: Beginnt bei 140 $/Monat (jährlich abgerechnet) für 180.000 Einheiten und 20 gleichzeitige Browser, geeignet für wachsende Anwendungen.
  • Scale-Plan: Beginnt bei 350 $/Monat (jährlich abgerechnet) für 500.000 Einheiten und 50 gleichzeitige Browser, konzipiert für hochvolumige Operationen.
  • Enterprise-Plan: Individuelle Preise für Benutzer, die Millionen von Einheiten, private Bereitstellungen, Self-Hosting, erweiterte Funktionen wie GPU-Infrastruktur, SSO und einen dedizierten technischen Account Manager benötigen.

Eine „Einheit“ entspricht bis zu 30 Sekunden Browserzeit. Längere Sitzungen verbrauchen zusätzliche Einheiten. Einheiten werden auch für Residential Proxys und erfolgreiche CAPTCHA-Lösungen verwendet.

Scrappey

Scrappey ist eine umfassende Web-Scraping-API, die eine All-in-One-Lösung für Entwickler und Datenanalysten bietet, die vor Herausforderungen bei der Extraktion von Webdaten stehen. Sie wurde entwickelt, um die häufigsten Hindernisse beim Web-Scraping zu bewältigen und zu überwinden, wie z. B. IP-Sperren, CAPTCHAs und anspruchsvolle Anti-Bot-Systeme wie Cloudflare, Datadome und PerimeterX. Durch die Verwaltung dieser Komplexitäten ermöglicht Scrappey den Benutzern, sich auf die Datenverarbeitung und -analyse zu konzentrieren, anstatt auf die Feinheiten der Scraping-Infrastruktur.

Die Plattform rühmt sich einer Erfolgsquote von über 99 % und gewährleistet eine zuverlässige Datenabfrage. Sie integriert ein riesiges Netzwerk von rotierenden Residential- und Datacenter-Proxys, Headless-Browser zum Rendern von JavaScript-lastigen Seiten und fortschrittliche Browser-Automatisierungsfunktionen. Darüber hinaus passen sich ihre KI-gestützten Funktionen, einschließlich eines KI-Unblockers und Auto-Parsing, intelligent an Website-Änderungen an und extrahieren strukturierte Daten mit minimaler Konfiguration.

Wie man Scrappey verwendet

Der Einstieg in Scrappey ist schnell und unkompliziert gestaltet und dauert in der Regel nur wenige Minuten:

  1. Konto erstellen: Registrieren Sie sich für ein kostenloses Scrappey-Konto auf deren Website. Für die Ersteinrichtung ist keine Kreditkarte erforderlich, und Sie erhalten sofort 150 kostenlose Scrapes zum Testen des Dienstes.
  2. API-Schlüssel erhalten: Nach der Registrierung navigieren Sie zu Ihrem Dashboard, um einen eindeutigen API-Schlüssel zu generieren. Dieser Schlüssel authentifiziert alle Ihre Anfragen an die Scrappey-API.
  3. API-Anfragen stellen: Verwenden Sie den API-Schlüssel, um Anfragen an Scrappey zu senden. Sie können einfache HTTP-Anfragen mit jeder Programmiersprache stellen oder deren dedizierte Bibliotheken (z. B. für Node.js und Python) für eine einfachere Integration nutzen. Die API ist flexibel und ermöglicht es Ihnen, URLs, Proxy-Standorte anzugeben und Funktionen wie JavaScript-Rendering oder Browser-Aktionen über einfache Parameter zu aktivieren.

Kernfunktionen von Scrappey

  • Fortschrittliche Anti-Bot-Umgehung: Besiegt automatisch anspruchsvolle Anti-Bot-Systeme wie Cloudflare, Datadome, PerimeterX und Akamai.
  • Automatische CAPTCHA-Lösung: Behandelt nahtlos verschiedene CAPTCHA-Typen wie reCAPTCHA (v2/v3), hCaptcha und FunCAPTCHA ohne manuelle Eingriffe.
  • Rotierende & Sticky Proxys: Zugriff auf einen großen Pool von Residential- und Datacenter-Proxys aus über 195 Ländern, mit Optionen für rotierende und feste Sitzungen.
  • Headless-Browser-Automatisierung: Rendert dynamische, JavaScript-lastige Websites und ermöglicht komplexe Browser-Interaktionen wie das Klicken von Schaltflächen, das Ausfüllen von Formularen, das Scrollen und das Ausführen von benutzerdefiniertem JavaScript.
  • KI-gestütztes Entsperren & Parsen: Nutzt maschinelles Lernen, um sich in Echtzeit an neue Anti-Scraping-Maßnahmen anzupassen, und kann Webseiten automatisch parsen, um strukturierte Daten basierend auf einem definierten Schema zu extrahieren.
  • Hohe Gleichzeitigkeit: Unterstützt bis zu 200 gleichzeitige Anfragen und ermöglicht so groß angelegte und schnelle Daten-Scraping-Operationen.
  • Umfangreiches Scraper-Verzeichnis: Bietet über 200 gebrauchsfertige Scraper für beliebte Websites in Kategorien wie E-Commerce, Nachrichten, soziale Medien und Immobilien, was die Entwicklungszeit erheblich verkürzt.

Anwendungsfälle für Scrappey

Scrappey ist vielseitig und kann für eine breite Palette von Datenextraktionsanforderungen eingesetzt werden:

  • E-Commerce-Intelligenz: Scrapen Sie Produktdetails, Preise, Lagerbestände und Kundenbewertungen von Websites wie Amazon, eBay und Shopify zur Preisüberwachung und Wettbewerbsanalyse.
  • Markt- & Finanzdatenanalyse: Sammeln Sie Echtzeit-Aktienkurse, Kryptowährungsdaten und Finanznachrichten aus verschiedenen Quellen für die Markttrendanalyse und den algorithmischen Handel.
  • Nachrichten- & Inhaltsaggregation: Sammeln Sie Artikel, Schlagzeilen und Veröffentlichungsdaten von Hunderten von Nachrichtenagenturen weltweit, wie Reuters, BBC und WSJ, um Nachrichtenportale oder Medienüberwachungsdienste zu betreiben.
  • Immobilienüberwachung: Extrahieren Sie Immobilienangebote, Preise und Maklerdetails von Plattformen wie Zillow und Idealista, um Markttrends zu analysieren und Investitionsmöglichkeiten zu identifizieren.
  • SEO- & Marktforschung: Scrapen Sie Suchmaschinenergebnisse, Website-Verkehrsdaten von Similarweb oder Backlink-Informationen von Ahrefs, um SEO-Strategien zu informieren und Marktforschung zu betreiben.

Vorteile von Scrappey

Im Vergleich zu anderen Anbietern bietet Scrappey mehrere entscheidende Vorteile:

  • Kosteneffizienz: Das Pay-as-you-go-Preismodell ist äußerst wettbewerbsfähig und flexibel und macht teure monatliche Abonnements überflüssig. Benutzer zahlen nur für das, was sie nutzen.
  • All-in-One-Lösung: Es kombiniert Proxys, CAPTCHA-Lösung und Headless-Browser in einer einzigen API, was den Scraping-Stack vereinfacht und den Wartungsaufwand reduziert.
  • Hohe Leistung und Zuverlässigkeit: Mit einer Erfolgsquote von 99,9 % und hoher Gleichzeitigkeit liefert Scrappey eine zuverlässige und schnelle Datenextraktion im großen Maßstab.
  • Benutzerfreundlichkeit: Die einfache API und die umfangreiche Dokumentation sowie fertige Scraper-Beispiele machen es für Entwickler aller Erfahrungsstufen zugänglich.
  • Starker Community-Support: Aktiver Support ist über Dokumentation, E-Mail und eine Discord-Community verfügbar, in der Benutzer sowohl vom Scrappey-Team als auch von anderen Fachleuten Hilfe erhalten können.

Preise und Pläne

Scrappey arbeitet mit einem transparenten und entwicklerfreundlichen Pay-As-You-Go-Modell. Es gibt keine monatlichen Abonnements oder versteckten Gebühren.

  • Kostenlose Testversion: Neue Benutzer erhalten bei der Anmeldung 150 kostenlose Scrapes, ohne dass eine Kreditkarte erforderlich ist.
  • Credit-basiertes System: Die Preisgestaltung basiert auf Credits, wobei verschiedene Arten von Anfragen eine unterschiedliche Anzahl von Credits verbrauchen. Beispielsweise kann eine einfache GET-Anfrage weniger Credits kosten als eine Anfrage, die JavaScript-Rendering und einen Premium-Residential-Proxy erfordert.
  • Wettbewerbsfähige Preise: Die Preise sind äußerst wettbewerbsfähig und werden mit nur 1 € pro 1.000 Scrapes (mit JS-Rendering und Residential-Proxys) angegeben, was deutlich günstiger ist als bei vielen Wettbewerbern.

Dieses Modell bietet maximale Flexibilität und macht es zu einer erschwinglichen Lösung für Projekte jeder Größe, von der kleinen Datenerfassung bis hin zu großen Unternehmensoperationen.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
DatenextraktionWeb Scraping
Nur Browserless
Automatisierung
Nur Scrappey
Marktforschung

Tags

Gemeinsam
APIDatenextraktionData MiningHeadless BrowserWeb Scraping
Nur Browserless
Bot-ErkennungBrowser-AutomatisierungCaptcha-LösungPlaywrightPuppeteer
Nur Scrappey
Anti-Bot-UmgehungCaptcha-LöserCloudflare-UmgehungDatenerfassungProxyWeb-Automatisierung

Zielgruppen und Rollen

Gemeinsam
DatenanalystDatenwissenschaftlerMarketing ManagerProduktmanagerSoftwareentwickler
Nur Browserless
DevOps-IngenieurQA Ingenieur
Nur Scrappey
Business AnalystForscherSEO-Spezialist

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Browserless monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
242.1K
Ø Besuchsdauer
1:17
Seiten pro Besuch
2.45
Absprungrate
56.01%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 126.9K
  • 2026-01: 150.9K
  • 2026-02: 150.8K
  • 2026-03: 157.8K
  • 2026-04: 148.9K
  • 2026-05: 242.1K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇧🇷Brazil28.09%68K
🇺🇸United States26.55%64.3K
🇨🇭Switzerland23.8%57.6K
🇨🇦Canada11.55%28K
🇪🇸Spain10.01%24.2K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt81.79%198K
Verweis13.74%33.3K
E-Mail4.47%10.8K

Suchbegriffe

browserlessbrowserless apibrowserless iomemory leak fixplaywright vs selenium

Scrappey monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
59K
Ø Besuchsdauer
1:09
Seiten pro Besuch
3.57
Absprungrate
38.66%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 14.5K
  • 2026-01: 41.4K
  • 2026-02: 36.7K
  • 2026-03: 47.8K
  • 2026-04: 35.3K
  • 2026-05: 59K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇻🇳Vietnam49.71%29.3K
🇺🇸United States17.31%10.2K
🇫🇷France17.19%10.1K
🇹🇷Turkey8.68%5.1K
🇧🇷Brazil7.11%4.2K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt89.78%52.9K
Verweis8%4.7K
E-Mail2.22%1.3K

Suchbegriffe

app.scrappey.com donwload a filephone number generatorrandom phone number generatorscrappeyscrappey url finder

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Browserless

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
178
Likes
165

Scrappey

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
130
Likes
134

Browserless vs Scrappey · Vergleichs-FAQ

What do Browserless and Scrappey have in common?
Both tools are listed under Datenextraktion、Web Scraping. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Browserless and Scrappey free?
Listed pricing models: Browserless — Freemium; Scrappey — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Browserless and Scrappey?
The primary listed category is Datenextraktion for Browserless, and Datenextraktion for Scrappey. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche