

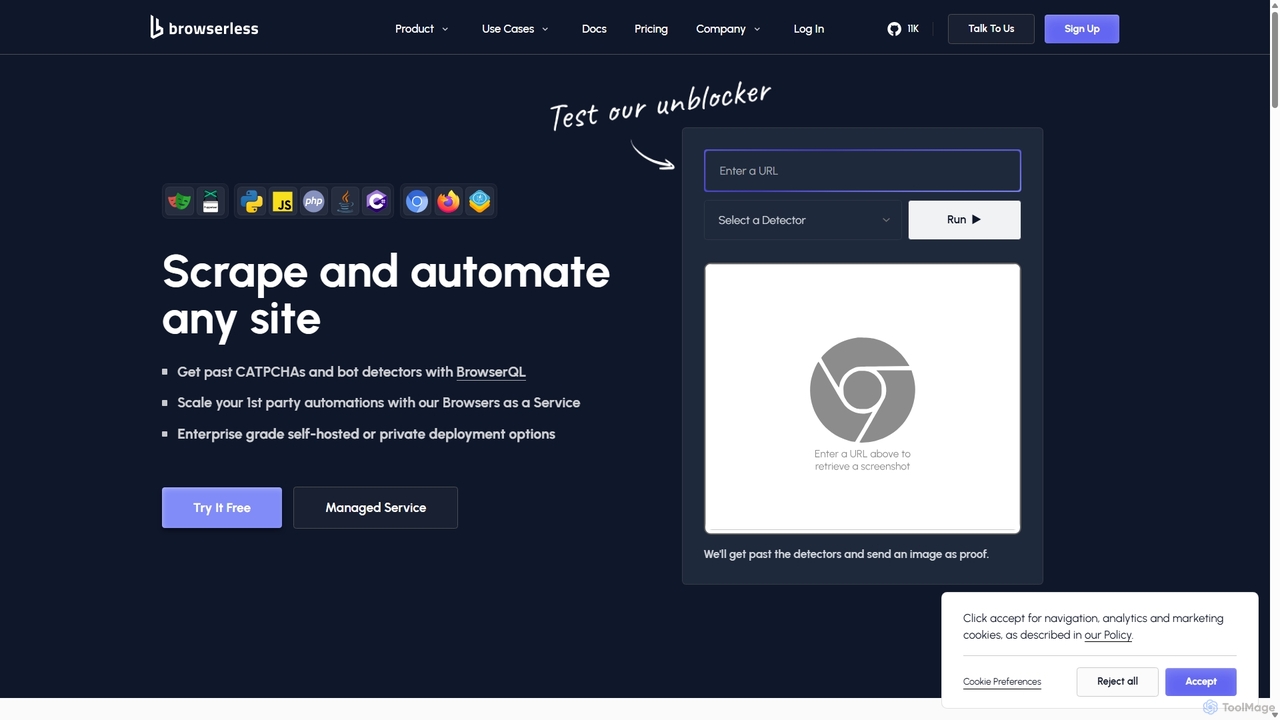
Browserless Overview
Browserless ist eine umfassende cloudbasierte Plattform, die Headless-Browser-Instanzen für eine Vielzahl von Web-Automatisierungs- und Datenextraktionsaufgaben bereitstellt. Sie wurde entwickelt, um die häufigen Herausforderungen zu lösen, mit denen Entwickler bei der Arbeit mit Headless-Browsern im großen Maßstab konfrontiert sind, wie z. B. Infrastrukturmanagement, Leistungsprobleme und die Umgehung ausgeklügelter Bot-Erkennungssysteme. Durch das Angebot eines robusten Pools verwalteter Browser ermöglicht Browserless Entwicklern und Unternehmen, sich auf ihre Kernlogik zu konzentrieren, anstatt auf die Komplexität der Bereitstellung und Wartung von Browser-Automatisierungssystemen.
Der Dienst wird von Tausenden von Unternehmen, von Start-ups bis hin zu Großunternehmen, für seine Zuverlässigkeit, Skalierbarkeit und fortschrittlichen Funktionen geschätzt. Er bietet sowohl verwaltete Cloud-Dienste als auch selbst gehostete Unternehmenslösungen und bietet Flexibilität für unterschiedliche Sicherheits- und Compliance-Anforderungen, einschließlich der SOC 2 Typ II-Konformität.
Wie man Browserless verwendet
Browserless bietet mehrere Möglichkeiten, seine Dienste in Ihren Arbeitsablauf zu integrieren, wodurch es für verschiedene Fähigkeitsstufen und Projektanforderungen zugänglich wird:
- Verbindung mit Puppeteer oder Playwright: Der einfachste Weg, um loszulegen, ist die Verbindung Ihrer bestehenden Puppeteer- oder Playwright-Skripte. Anstatt eine lokale Browser-Instanz zu starten, ändern Sie einfach die Verbindungsmethode, um auf einen Browserless-WebSocket-Endpunkt zu verweisen. Dies erfordert minimale Codeänderungen und skaliert Ihre bestehenden Automatisierungen sofort.
- Verwendung von REST-APIs: Für gängige Aufgaben wie das Erstellen von PDFs, das Aufnehmen von Screenshots oder das Extrahieren von HTML-Inhalten bietet Browserless einfache REST-APIs. Sie können eine cURL-Anfrage stellen oder einen beliebigen HTTP-Client verwenden, um diese Aktionen ohne das Schreiben komplexer Browser-Automatisierungsskripte durchzuführen.
- Nutzung von BrowserQL: Für fortgeschrittene Anwendungsfälle, insbesondere solche, die das Umgehen von hartnäckigen Bot-Detektoren (wie Cloudflare) beinhalten, bietet Browserless BrowserQL an. Dies ist eine Automatisierungssprache und IDE der nächsten Generation, die darauf ausgelegt ist, minimale Fingerabdrücke zu hinterlassen. Sie können prägnante Abfragen schreiben, um komplexe Aktionen wie das Klicken von Schaltflächen, das Lösen von CAPTCHAs und das Extrahieren strukturierter Daten durchzuführen, während Sie für Erkennungssysteme menschlicher erscheinen.
- Hybride Automatisierungen: Browserless unterstützt hybride Arbeitsabläufe, bei denen Sie eine Browser-Sitzung in ein iframe streamen können. Dies ist nützlich für Aufgaben, die manuelle Eingriffe erfordern, wie das Lösen eines komplexen CAPTCHAs, die Eingabe von 2FA-Codes oder die Handhabung von OAuth-Logins innerhalb eines automatisierten Skripts.
Kernfunktionen von Browserless
- BrowserQL: Eine proprietäre Abfragesprache und IDE, die von Grund auf entwickelt wurde, um die fortschrittlichsten Bot-Detektoren durch Minimierung von Browser-Fingerabdrücken zu umgehen.
- Browser as a Service (BaaS): Ein skalierbarer, verwalteter Pool von Tausenden von Browsern, der alle Infrastrukturaspekte wie Versionsupdates, Lastausgleich und Ressourcenmanagement übernimmt.
- Bot-Erkennung & CAPTCHA-Umgehung: Spezialisierte Technologie zur automatischen Lösung von CAPTCHAs (reCAPTCHA, hCaptcha) und zum Umgehen von Bot-Blocking-Diensten wie Cloudflare.
- Puppeteer & Playwright-Integration: Nahtlose Kompatibilität mit den beiden beliebtesten Browser-Automatisierungsbibliotheken.
- REST-APIs: Einfache Endpunkte für gängige Aufgaben wie PDF-Erstellung, Screenshots und Content-Scraping.
- Sitzungsmanagement & Wiederverbindungen: Die Fähigkeit, Browser-Sitzungen am Leben zu erhalten und sich wieder mit ihnen zu verbinden, was die Proxy-Nutzung erheblich reduziert und wiederholte Bot-Prüfungen vermeidet.
- Unternehmenslösungen: Optionen für Self-Hosting, private Cloud-Bereitstellungen, benutzerdefinierte Maschinen-Setups (einschließlich GPUs), SSO, dedizierten Support und SOC 2 Typ II-Konformität.
- Überwachung & Debugging: Ein benutzerfreundliches Dashboard bietet Metriken zu Anfragen, Worker-Gesundheit (CPU/Speicher) und einen Debugger, um Skripte in Echtzeit laufen zu sehen.
Anwendungsfälle für Browserless
Browserless ist vielseitig und kann in zahlreichen Szenarien angewendet werden:
- Web-Scraping & Datenextraktion: Sammeln von Daten von dynamischen, JavaScript-lastigen Websites, E-Commerce-Plattformen (z. B. Walmart, eBay), Immobilienangeboten (Zillow) und Jobbörsen (Indeed).
- Automatisierte Softwaretests: Ausführen von End-to-End-Tests für Webanwendungen im großen Maßstab, Integration mit Frameworks wie Laravel Dusk ohne die Notwendigkeit, ein komplexes Selenium Grid zu verwalten.
- KI & LLM-Datenerfassung: Versorgung von KI-Agenten (z. B. mit LangChain oder CrewAI) mit Echtzeit-Webzugriff, um frische Daten für das Training großer Sprachmodelle oder die Durchführung automatisierter Recherchen zu sammeln.
- Berichterstellung: Automatisches Erstellen von PDFs und Screenshots von Dashboards, Analyseberichten oder Rechnungen aus Webanwendungen.
- Preis- & Wettbewerbsüberwachung: Verfolgung von Produktpreisen, Lagerbeständen und Wettbewerbsstrategien bei verschiedenen Online-Händlern.
Vorteile von Browserless
Die Verwendung von Browserless bietet mehrere entscheidende Vorteile:
- Reduzierter Betriebsaufwand: Eliminiert die Notwendigkeit eines dedizierten Teams zum Aufbau, zur Bereitstellung und zur Wartung einer komplexen Browser-Automatisierungsinfrastruktur.
- Erhöhte Erfolgsraten: Seine fortschrittlichen Bot-Umgehungstechniken, insbesondere mit BrowserQL, führen zu höheren Erfolgsraten beim Scrapen geschützter Websites.
- Skalierbarkeit bei Bedarf: Skaliert mühelos von wenigen gleichzeitigen Sitzungen auf Tausende und bewältigt Verkehrsspitzen ohne Leistungseinbußen.
- Kosteneffizienz: Funktionen wie Sitzungswiederverbindungen können die Proxy-Kosten um bis zu 90 % senken. Das einheitenbasierte Preismodell ist vorhersehbar und kostengünstig.
- Entwicklerfokussiert: Von Entwicklern für Entwickler konzipiert, mit ausgezeichneter Dokumentation, SDKs und reaktionsschnellem technischen Support.
Preise und Pläne
Browserless bietet ein flexibles, einheitenbasiertes Preismodell für unterschiedliche Bedürfnisse:
- Kostenloser Plan: Beinhaltet 1.000 Einheiten pro Monat, 1 maximal gleichzeitigen Browser und Zugriff auf den BrowserQL-Editor. Keine Kreditkarte erforderlich.
- Prototyping-Plan: Beginnt bei 25 $/Monat (jährlich abgerechnet) für 20.000 Einheiten und 3 gleichzeitige Browser. Ideal für kleine Projekte und Tests.
- Starter-Plan: Beginnt bei 140 $/Monat (jährlich abgerechnet) für 180.000 Einheiten und 20 gleichzeitige Browser, geeignet für wachsende Anwendungen.
- Scale-Plan: Beginnt bei 350 $/Monat (jährlich abgerechnet) für 500.000 Einheiten und 50 gleichzeitige Browser, konzipiert für hochvolumige Operationen.
- Enterprise-Plan: Individuelle Preise für Benutzer, die Millionen von Einheiten, private Bereitstellungen, Self-Hosting, erweiterte Funktionen wie GPU-Infrastruktur, SSO und einen dedizierten technischen Account Manager benötigen.
Eine „Einheit“ entspricht bis zu 30 Sekunden Browserzeit. Längere Sitzungen verbrauchen zusätzliche Einheiten. Einheiten werden auch für Residential Proxys und erfolgreiche CAPTCHA-Lösungen verwendet.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 126.9K
- 2026-1: 150.9K
- 2026-2: 150.8K
- 2026-3: 157.8K
- 2026-4: 148.9K
- 2026-5: 242.1K
Geography
Top 5 countries / regions
- 🇧🇷Brasilien28.1%
- 🇺🇸Vereinigte Staaten26.6%
- 🇨🇭Schweiz23.8%
- 🇨🇦Kanada11.6%
- 🇪🇸Spanien10.0%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 81.8% |
Referral | 13.7% |
Email | 4.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| browserless | $3.04 |
| browserless api | $0.00 |
| browserless io | $5.97 |
| memory leak fix | $2.60 |
| playwright vs selenium | $2.37 |
Browserless Videos on YouTube

browserless
browserless


browserless


Latent Space TV (see @LatentSpacePod for Pod)
Browserless Alternatives
Scrappey
Scrappey ist eine fortschrittliche Web-Scraping-API, die für Entwickler entwickelt wurde, um mühelos Daten von jeder Website zu extrahieren. Sie bewältigt alle Komplexitäten wie rotierende Proxys, Headless-Browser und die Umgehung von Anti-Bot-Maßnahmen wie Cloudflare und CAPTCHAs. Mit einer hohen Erfolgsquote und einem einfachen Pay-as-you-go-Modell optimiert Scrappey die Datenerfassung für verschiedene Anwendungen.
Datenextraktion
Crawlbase
Crawlbase ist eine KI-gestützte Web-Crawling- und Daten-Scraping-Plattform für Entwickler und Unternehmen. Sie bietet eine Reihe von Tools, einschließlich einer Crawling-API und eines Smart Proxy, um anonym Daten von jeder Website in großem Maßstab zu extrahieren und dabei Blockaden und CAPTCHAs mit hoher Erfolgsquote zu umgehen. Sie vereinfacht die Datenerfassung für SEO, Marktforschung, E-Commerce-Intelligenz und das Training von KI-Modellen.
Datenextraktion
Foxscrape
FoxScrape ist eine KI-gestützte Web-Scraping-REST-API für Entwickler. Es vereinfacht die Datenextraktion, indem es jede Website in strukturierte JSON-Daten umwandelt, unter Verwendung von Funktionen wie KI-gesteuertem Parsen aus einfachem Englisch, JavaScript-Rendering für dynamische Websites und automatischer Proxy-Rotation, um Blockaden zu verhindern.
Datenextraktion
Apify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
Datenerfassung
FetchFox
FetchFox ist ein KI-gestütztes Web-Scraping-Tool, das es Benutzern ermöglicht, Daten von jeder Website mit einfachen Textanweisungen zu extrahieren. Es eliminiert die Notwendigkeit komplexer Codierung oder CSS-Selektoren und handhabt automatisch Anti-Bot-Maßnahmen. Verfügbar als API, JavaScript-Bibliothek und Chrome-Erweiterung, ist es sowohl für Entwickler als auch für nicht-technische Benutzer konzipiert, um die Datenerfassung mühelos zu automatisieren.
DatenextraktionBrowserless Categories
Browserless Jobs
Browserless Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Scrappey
Scrappey ist eine fortschrittliche Web-Scraping-API, die für Entwickler entwickelt wurde, um mühelos Daten von jeder Website zu extrahieren. Sie bewältigt alle Komplexitäten wie rotierende Proxys, Headless-Browser und die Umgehung von Anti-Bot-Maßnahmen wie Cloudflare und CAPTCHAs. Mit einer hohen Erfolgsquote und einem einfachen Pay-as-you-go-Modell optimiert Scrappey die Datenerfassung für verschiedene Anwendungen.
DatenextraktionCrawlbase
Crawlbase ist eine KI-gestützte Web-Crawling- und Daten-Scraping-Plattform für Entwickler und Unternehmen. Sie bietet eine Reihe von Tools, einschließlich einer Crawling-API und eines Smart Proxy, um anonym Daten von jeder Website in großem Maßstab zu extrahieren und dabei Blockaden und CAPTCHAs mit hoher Erfolgsquote zu umgehen. Sie vereinfacht die Datenerfassung für SEO, Marktforschung, E-Commerce-Intelligenz und das Training von KI-Modellen.
Datenextraktion
Zyte
Zyte ist eine umfassende Web-Scraping-Plattform, die eine Full-Stack-API und Datenextraktionsdienste anbietet. Sie vereinfacht die Datenerfassung durch die Verwaltung von Proxys, Headless-Browsern und fortschrittlichen Anti-Blocking-Systemen. Angetrieben von KI liefert Zyte zuverlässige, strukturierte Webdaten in großem Umfang für Unternehmen im E-Commerce, in der Marktforschung und mehr.
MarktintelligenzFoxscrape
FoxScrape ist eine KI-gestützte Web-Scraping-REST-API für Entwickler. Es vereinfacht die Datenextraktion, indem es jede Website in strukturierte JSON-Daten umwandelt, unter Verwendung von Funktionen wie KI-gesteuertem Parsen aus einfachem Englisch, JavaScript-Rendering für dynamische Websites und automatischer Proxy-Rotation, um Blockaden zu verhindern.
Datenextraktion
Browserman
Browserman ist eine fortschrittliche Browser-Automatisierungsplattform, die darauf ausgelegt ist, KI-Assistenten wie Claude, ChatGPT, Gemini und Grok bei der Verwaltung von Social-Media-Operationen zu unterstützen. Sie bietet Multi-Plattform- und Multi-Account-Unterstützung, eine robuste REST-API und native Model Context Protocol (MCP)-Integration für nahtlose, skalierbare und sichere Automatisierungs-Workflows.
Integration
Skyvern
Skyvern ist eine KI-gestützte Browser-Automatisierungsplattform, die Computer Vision und natürliche Sprache nutzt, um komplexe Web-Workflows zu automatisieren. Sie kann Datenextraktion, Formularübermittlungen, Rechnungsabruf und mehr auf jeder Website bewältigen und passt sich dynamisch an Änderungen an, ohne traditionelles Scripting.
API
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
ManyPI
ManyPI ist eine moderne Datenerfassungsplattform, die jede Website in eine typsichere API umwandelt. Sie vereinfacht die Extraktion strukturierter Daten mit integrierter Schemadefinition, Datenextraktion und Datensatztransformation und ermöglicht es Entwicklern und technischen Teams, Webdaten zuverlässig und in großem Maßstab zu sammeln.
3D
Hyperbrowser
Hyperbrowser ist eine Browser-as-a-Service (BaaS)-Plattform, die für KI-Agenten und Entwickler konzipiert wurde. Sie bietet skalierbare, blitzschnelle Cloud-Browser zur Automatisierung von Web-Aufgaben, zur Datenextraktion und zur Ermöglichung von KI-gesteuerten Web-Interaktionen. Mit Funktionen wie Stealth-Browsing, automatischer Captcha-Lösung und entwicklerfreundlichen APIs ermöglicht sie komplexe Arbeitsabläufe ohne Grenzen.
Web Scraping
Octoparse
Octoparse ist ein leistungsstarkes No-Code-Web-Scraping-Tool, mit dem jeder ohne Programmierung Daten von Websites extrahieren kann. Es verfügt über einen visuellen Workflow-Designer, einen KI-gestützten Assistenten für eine einfache Einrichtung und Hunderte von vorgefertigten Vorlagen für beliebte Websites. Mit cloudbasierter Automatisierung, IP-Rotation und CAPTCHA-Lösung bewältigt Octoparse komplexe Scraping-Aufgaben effizient und wandelt Webseiten in strukturierte Daten für die Lead-Generierung, Marktforschung und mehr um.
Web Scraping
Crawlora
Crawlora ist eine KI-gestützte No-Code-Web-Scraping-Plattform, die es Benutzern ermöglicht, mühelos Daten von jeder Website zu extrahieren. Die intelligente Point-and-Click-Oberfläche vereinfacht die Datenextraktion und ermöglicht es Ihnen, Webseiten in strukturierte Daten (CSV, JSON) umzuwandeln, ohne eine einzige Zeile Code zu schreiben. Ideal für Marktforschung, Lead-Generierung und Preisüberwachung.
Datenextraktion
BrowserBook
BrowserBook ist eine KI-gestützte integrierte Entwicklungsumgebung (IDE) zum Erstellen, Bereitstellen und Skalieren deterministischer Browser-Automatisierungen. Es vereinfacht komplexe Web-Automatisierungsaufgaben und bietet Geschwindigkeit, Stabilität und Kosteneinsparungen durch die Kombination von KI-Code-Generierung mit zuverlässiger Skriptausführung. Ideal für KI-Agenten, Web-Scraping, UI-Tests und branchenspezifische Workflows im Gesundheitswesen und Finanzbereich.
KI-Agentenentwicklung
Browserbase
Browserbase bietet eine skalierbare Cloud-Infrastruktur zum Ausführen und Verwalten von Headless-Browsern. Es wurde für Entwickler konzipiert, um KI-Agenten zu unterstützen, komplexe Web-Workflows zu automatisieren und groß angelegtes Daten-Scraping durchzuführen, ohne die zugrunde liegende Infrastruktur verwalten zu müssen.
Web Scraping
ScrapingBee
ScrapingBee ist eine leistungsstarke Web-Scraping-API, die Headless-Browser und Proxy-Rotation handhabt, um Blockierungen zu vermeiden. Sie verfügt über einen innovativen KI-gestützten Extraktor, mit dem Sie die benötigten Daten in einfachem Englisch beschreiben können, wodurch komplexe CSS-Selektoren überflüssig werden. Ideal für Entwickler, Vermarkter und Datenanalysten für Aufgaben wie Preisüberwachung, Lead-Generierung und SERP-Analyse.
Datenextraktion
Rtrvr
Rtrvr ist ein fortschrittlicher KI-Agent, der komplexe Webaufgaben mithilfe natürlicher Sprache automatisiert. Er navigiert auf Websites, extrahiert Daten, füllt Formulare aus und führt Workflows aus, wodurch mühsame Aufgaben in einfache Gespräche verwandelt werden.
Webautomatisierung
Browserless Comments (0)
Sign in to comment.
AnmeldenNo comments yet.