

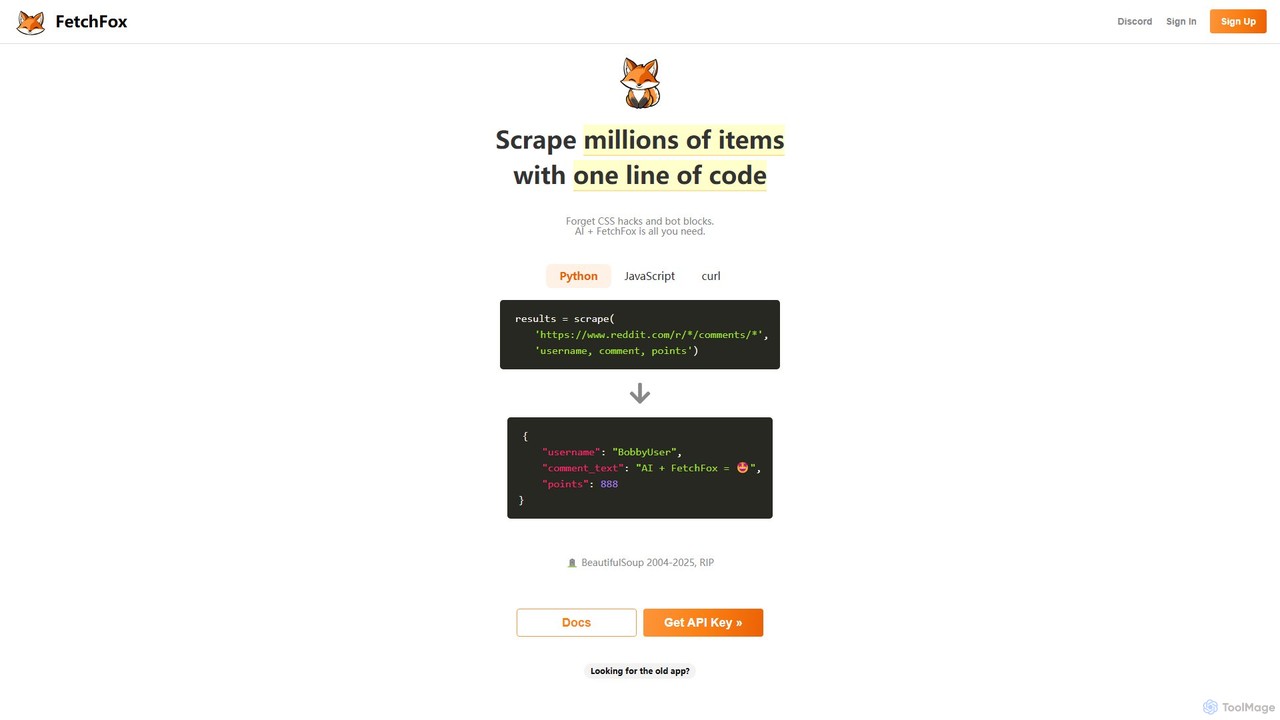
FetchFox Overview
FetchFox ist eine revolutionäre, KI-gestützte Web-Scraping-Plattform, die entwickelt wurde, um den Prozess der Datenextraktion aus dem Web zu vereinfachen und zu automatisieren. Es verändert grundlegend, wie Benutzer an das Web-Scraping herangehen, indem es komplexe Codierung, CSS-Selektoren und die Wartung fragiler Skripte durch einfache, natürlichsprachliche Anweisungen ersetzt. Egal, ob Sie ein Entwickler sind, der Daten in eine Anwendung integrieren muss, oder ein Geschäftsanwender, der Marktinformationen sammeln möchte, FetchFox bietet eine robuste und zugängliche Lösung.
Das Kernprinzip von FetchFox ist seine KI-Engine, die die Struktur und den Inhalt einer Webseite intelligent versteht. Benutzer beschreiben einfach die Daten, die sie extrahieren möchten, und die KI erledigt den Rest. Dies umfasst das Navigieren durch Seiten, das Identifizieren der relevanten Datenpunkte und das Strukturieren der Ausgabe in ein sauberes, nutzbares Format wie JSON. Die Plattform ist so konzipiert, dass sie widerstandsfähig ist, sich automatisch an Änderungen im Website-Layout anpasst und gängige Anti-Scraping-Technologien wie CAPTCHAs und IP-Sperren umgeht, die für traditionelle Scraping-Methoden große Hürden darstellen.
Wie man FetchFox verwendet
FetchFox bietet flexible Nutzungsmöglichkeiten, um den unterschiedlichen Bedürfnissen der Benutzer gerecht zu werden:
1. Für Entwickler (API und Bibliotheken):
- API-Schlüssel erhalten: Melden Sie sich auf der FetchFox-Website an, um Ihren einzigartigen API-Schlüssel zu erhalten.
- In Ihren Code integrieren: Verwenden Sie die offiziellen Python- oder JavaScript-Bibliotheken (npm install fetchfox) für eine nahtlose Integration oder stellen Sie direkte cURL-Anfragen an den API-Endpunkt.
- Ihren Scrape-Job definieren: Geben Sie in Ihrer Anfrage die Ziel-Website(s) mit `start_urls` und einem URL-`pattern` zum Crawlen mehrerer Seiten an.
- Eine natürlichsprachliche Anweisung schreiben: Der wichtigste Teil ist der `template`-Parameter. Hier beschreiben Sie die benötigten Datenfelder, zum Beispiel: "Extrahiere den Produktnamen, den Preis, die Kundenbewertung und den Text der ersten drei Rezensionen."
- Ausführen und Daten empfangen: Führen Sie Ihr Skript aus, um den Scraping-Job zu starten. FetchFox verarbeitet die Anfrage und gibt die extrahierten Daten in einem strukturierten JSON-Format zurück.
2. Für nicht-technische Benutzer (Chrome-Erweiterung):
- Erweiterung installieren: Fügen Sie die FetchFox-Erweiterung aus dem Chrome Web Store zu Ihrem Chrome-Browser hinzu.
- Navigieren und aktivieren: Gehen Sie zu der Webseite, von der Sie Daten extrahieren möchten. Öffnen Sie die Erweiterung und geben Sie Ihren API-Schlüssel ein.
- Eine Anweisung eingeben: Geben Sie in der Benutzeroberfläche der Erweiterung einen einfachen Befehl ein, der beschreibt, was Sie sammeln möchten, z. B. "Liste alle Jobtitel und Firmennamen auf dieser Seite auf."
- Scraping starten: Drücken Sie die 'Go'-Taste. FetchFox analysiert die Seite, extrahiert die angeforderten Informationen und ermöglicht es Ihnen, die Ergebnisse herunterzuladen, typischerweise als CSV-Datei.
Kernfunktionen von FetchFox
- KI-gestütztes natürlichsprachliches Scraping: Keine Notwendigkeit für XPath oder CSS-Selektoren. Sagen Sie der KI einfach in einfachem Englisch, welche Daten Sie benötigen.
- Fortschrittliche Anti-Bot-Umgehung: Navigiert intelligent durch Anti-Scraping-Maßnahmen, einschließlich dynamischer Inhalte, CAPTCHAs und Proxy-Management.
- Multi-Plattform-Zugriff: Nutzen Sie die leistungsstarke API, die praktischen Python/JavaScript-Bibliotheken oder die benutzerfreundliche No-Code-Chrome-Erweiterung.
- Strukturierte Datenausgabe: Liefert automatisch saubere, gut strukturierte JSON-Daten und spart Ihnen Zeit bei der Datenbereinigung und -analyse.
- Skalierbares Crawling: Extrahieren Sie mühelos Millionen von Elementen auf ganzen Websites, indem Sie URL-Muster definieren, denen der Crawler folgen soll.
- Bring Your Own Key (BYOK): Eine Option, Ihren persönlichen OpenAI-API-Schlüssel zu verwenden, was Kosten senken und ein großzügigeres Kontingent an kostenlosen Elementen bieten kann.
Anwendungsfälle für FetchFox
FetchFox ist vielseitig und kann in verschiedenen Branchen und Rollen eingesetzt werden:
- Vertrieb und Lead-Generierung: Scrapen Sie Branchenverzeichnisse, LinkedIn Sales Navigator oder berufliche Netzwerke, um gezielte Lead-Listen mit Namen, Jobtiteln, Unternehmen und Kontaktdaten zu erstellen.
- Markt- und Wettbewerbsforschung: Sammeln Sie Produktinformationen, Preise und Kundenbewertungen von E-Commerce-Websites wie Amazon oder eBay, um Markttrends und Wettbewerbsstrategien zu analysieren.
- Finanzdatenaggregation: Sammeln Sie Daten von Finanznachrichten-Websites, Börsenplattformen oder DeFi-Protokollen für Investitionsanalysen und Modelltraining.
- Akademische und wissenschaftliche Forschung: Stellen Sie große Datensätze aus verschiedenen Online-Quellen, Veröffentlichungen oder öffentlichen Aufzeichnungen für akademische Studien zusammen.
- Immobilienanalyse: Sammeln Sie Immobilienangebote, Preise und Maklerdetails von Immobilien-Websites, um die Marktbedingungen zu überwachen.
Vorteile von FetchFox
Der Hauptvorteil von FetchFox ist seine radikale Einfachheit und Leistungsfähigkeit. Es demokratisiert das Web-Scraping und macht es auch für Benutzer ohne technischen Hintergrund zugänglich. Für Entwickler beschleunigt es den Entwicklungsprozess erheblich, indem es die mühsamsten und anspruchsvollsten Aspekte des Scrapings abstrahiert. Seine Widerstandsfähigkeit gegenüber Website-Änderungen bedeutet weniger Zeit für die Wartung defekter Skripte und mehr Zeit für die Nutzung der Daten. Die Kombination aus einer leistungsstarken KI-Engine und einer robusten Infrastruktur macht es zu einem hocheffizienten und zuverlässigen Werkzeug für jede Datenextraktionsaufgabe.
Preise und Pläne
FetchFox verwendet ein unkompliziertes, transparentes Pay-as-you-go-Preismodell.
- Kostenlose Stufe: Neue Benutzer erhalten ihre ersten 1.000 extrahierten Elemente kostenlos. Ein 'Element' entspricht einer Datenzeile (z. B. die Details eines Produkts).
- Standardpreis: Nach der kostenlosen Stufe beträgt der Preis pauschal 1 $ pro 1.000 Elemente.
- Bring Your Own Key (BYOK) Bonus: Wenn Sie sich dafür entscheiden, Ihren eigenen OpenAI-API-Schlüssel zu verwenden, erhalten Sie zusätzlich 10.000 kostenlose Elemente. Dies kann eine kostengünstigere Option für Benutzer mit bestehenden OpenAI-Konten sein.
- Individuelle Pläne: Für Benutzer mit groß angelegten Scraping-Anforderungen oder komplexen Anforderungen bietet FetchFox individuelle Unternehmenspläne an. Interessenten können sich für eine Beratung an ihr Vertriebsteam wenden.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 2.7K
- 2026-1: 1.9K
- 2026-2: 771
- 2026-3: 1.0K
- 2026-4: 14.8K
- 2026-5: 40.3K
Geography
Top 5 countries / regions
- 🇮🇳Indien45.8%
- 🇺🇸Vereinigte Staaten44.9%
- 🇪🇸Spanien9.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| fetch fox | $0.00 |
| fetchfox ai | $0.00 |
| fetchfoxai | $0.00 |
| fetchfox.ia | $0.00 |
| founding engineer equity | $0.00 |
FetchFox Alternatives
instantapi
instantapi ist eine KI-gestützte Web-Scraping-API, die auf Einfachheit und Geschwindigkeit ausgelegt ist. Sie ermöglicht es Benutzern, strukturierte Daten von jeder Website mit einem einzigen API-Aufruf zu extrahieren, ohne dass komplexe Programmierung oder manuelle Einrichtung erforderlich ist. Ideal für Entwickler, Datenanalysten und Unternehmen, die eine schnelle, kostengünstige und zuverlässige Datenextraktion ohne den Aufwand herkömmlicher Web-Scraper benötigen.
Datenextraktion
Apify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
Datenerfassung
WebScraping.AI
WebScraping.AI ist eine fortschrittliche API für Entwickler, die das Web-Scraping mit KI vereinfacht. Sie bietet rotierende Proxys, JavaScript-Rendering und Geotargeting, um Blockaden zu umgehen und auf dynamische Inhalte zuzugreifen. Ihre Kernstärke liegt in den LLM-gestützten Werkzeugen, die unstrukturierte Daten extrahieren, Zusammenfassungen erstellen und Fragen direkt von Webseiten beantworten können, was die Datenerfassung für jedes Projekt optimiert.
Datenextraktion
Simplescraper
Simplescraper ist ein leistungsstarkes Web-Scraping-Tool, das in Sekundenschnelle Daten von jeder Website extrahiert. Es bietet eine benutzerfreundliche Chrome-Erweiterung für die Datenauswahl ohne Code, cloudbasierte Automatisierung für groß angelegtes Scraping und eine innovative KI-Enhance-Funktion, um mit einfachen Anweisungen Erkenntnisse zu gewinnen. Verwandeln Sie Websites in strukturierte Daten (CSV, JSON) oder sofortige APIs und integrieren Sie sie mit Tools wie Google Sheets und Airtable.
Web Scraping
Crawlbase
Crawlbase ist eine KI-gestützte Web-Crawling- und Daten-Scraping-Plattform für Entwickler und Unternehmen. Sie bietet eine Reihe von Tools, einschließlich einer Crawling-API und eines Smart Proxy, um anonym Daten von jeder Website in großem Maßstab zu extrahieren und dabei Blockaden und CAPTCHAs mit hoher Erfolgsquote zu umgehen. Sie vereinfacht die Datenerfassung für SEO, Marktforschung, E-Commerce-Intelligenz und das Training von KI-Modellen.
DatenextraktionFetchFox Categories
FetchFox Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
instantapi
instantapi ist eine KI-gestützte Web-Scraping-API, die auf Einfachheit und Geschwindigkeit ausgelegt ist. Sie ermöglicht es Benutzern, strukturierte Daten von jeder Website mit einem einzigen API-Aufruf zu extrahieren, ohne dass komplexe Programmierung oder manuelle Einrichtung erforderlich ist. Ideal für Entwickler, Datenanalysten und Unternehmen, die eine schnelle, kostengünstige und zuverlässige Datenextraktion ohne den Aufwand herkömmlicher Web-Scraper benötigen.
DatenextraktionSimplescraper
Simplescraper ist ein leistungsstarkes Web-Scraping-Tool, das in Sekundenschnelle Daten von jeder Website extrahiert. Es bietet eine benutzerfreundliche Chrome-Erweiterung für die Datenauswahl ohne Code, cloudbasierte Automatisierung für groß angelegtes Scraping und eine innovative KI-Enhance-Funktion, um mit einfachen Anweisungen Erkenntnisse zu gewinnen. Verwandeln Sie Websites in strukturierte Daten (CSV, JSON) oder sofortige APIs und integrieren Sie sie mit Tools wie Google Sheets und Airtable.
Web Scraping
hystruct
hystruct ist ein KI-gestütztes Web-Scraping-Tool, das die Datenextraktion vereinfacht. Es ermöglicht Benutzern, unstrukturierte Webinhalte einfach in strukturierte Daten umzuwandeln, indem vordefinierte oder benutzerdefinierte Schemata verwendet werden, ohne dass Code erforderlich ist. Mit Integrationen wie Zapier automatisiert es Arbeitsabläufe für Marktforschung, Lead-Generierung und mehr. Es ist für jeden konzipiert, vom Anfänger bis zum Enterprise-Team.
Scraping
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
webscrapeai
WebscrapeAI ist eine No-Code, KI-gestützte Plattform zur Automatisierung der Web-Datenerfassung. Geben Sie einfach eine URL an und spezifizieren Sie die benötigten Daten, und die KI übernimmt den gesamten Scraping-Prozess. Es unterstützt dynamische Websites, Massen-Scraping, Proxy-Integration und bietet eine API für Entwickler, was die Datenextraktion schnell, genau und für jeden zugänglich macht.
Web Scraping
Curlent
Curlent ist eine KI-gestützte Web-Scraping- und Datenextraktionsplattform, die die Sammlung strukturierter Daten von jeder Website automatisiert. Sie behandelt intelligent dynamische Inhalte, Anti-Bot-Maßnahmen und komplexe Layouts und liefert saubere, gebrauchsfertige Daten über eine leistungsstarke API.
Scraping
MrScraper
MrScraper ist ein KI-gestütztes No-Code-Web-Scraping-Tool, mit dem Benutzer mühelos strukturierte Daten von jeder Website extrahieren können. Es automatisiert den Datenerfassungsprozess, umgeht Anti-Bot-Maßnahmen wie CAPTCHAs und IP-Sperren und ist somit ideal für Preisintelligenz, Marktforschung und Lead-Generierung.
Web Scraping
ScrapeComfort
ScrapeComfort ist eine KI-gestützte, codefreie Desktop-Anwendung für müheloses Web-Scraping. Es nutzt ChatGPT, damit Sie Daten von jeder Website mit einfachen Textbefehlen extrahieren können, ohne dass technische Kenntnisse wie CSS-Selektoren oder XPaths erforderlich sind. Es ist für Benutzer aller Niveaus konzipiert, um die Datenerfassung für Marktforschung, Lead-Generierung und Datenanalyse zu automatisieren.
ScrapingApify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
Datenerfassung
Octoparse
Octoparse ist ein leistungsstarkes No-Code-Web-Scraping-Tool, mit dem jeder ohne Programmierung Daten von Websites extrahieren kann. Es verfügt über einen visuellen Workflow-Designer, einen KI-gestützten Assistenten für eine einfache Einrichtung und Hunderte von vorgefertigten Vorlagen für beliebte Websites. Mit cloudbasierter Automatisierung, IP-Rotation und CAPTCHA-Lösung bewältigt Octoparse komplexe Scraping-Aufgaben effizient und wandelt Webseiten in strukturierte Daten für die Lead-Generierung, Marktforschung und mehr um.
Web Scraping
ParseHub
ParseHub ist ein leistungsstarkes No-Code Web-Scraping-Tool, mit dem Benutzer Daten von jeder Website über eine einfache Point-and-Click-Oberfläche extrahieren können. Es ist für die Verarbeitung komplexer, dynamischer Websites mit JavaScript, AJAX, Formularen und unendlichem Scrollen konzipiert. Daten können nach Zeitplan gesammelt, als JSON/Excel exportiert oder über eine API abgerufen werden, was es ideal für die Lead-Generierung, Marktforschung und Datenaggregation macht.
Web Scraping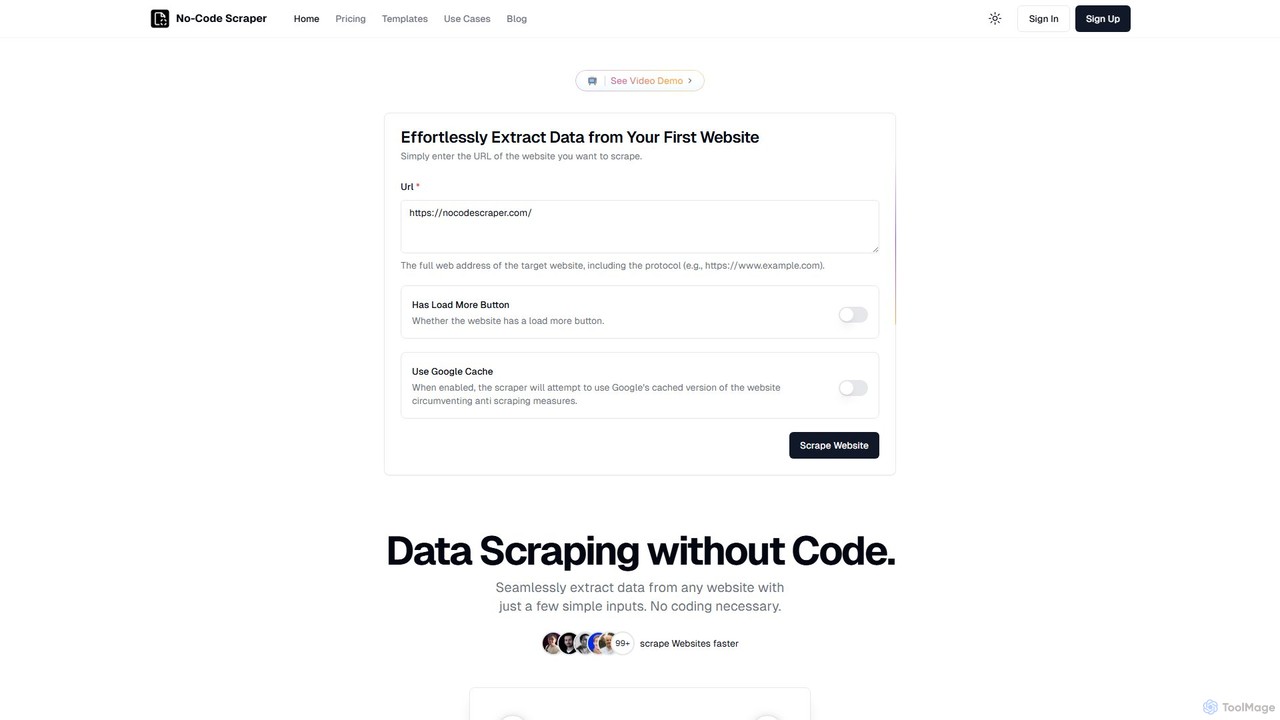
No-Code Scraper
No-Code Scraper ist eine KI-gestützte Plattform, die es Benutzern ermöglicht, Daten von jeder Website zu extrahieren, ohne eine einzige Zeile Code zu schreiben. Sie verwendet große Sprachmodelle, um die Datenextraktion, -bereinigung und -strukturierung zu automatisieren und macht Web Scraping für jeden zugänglich, zuverlässig und effizient.
Web Scraping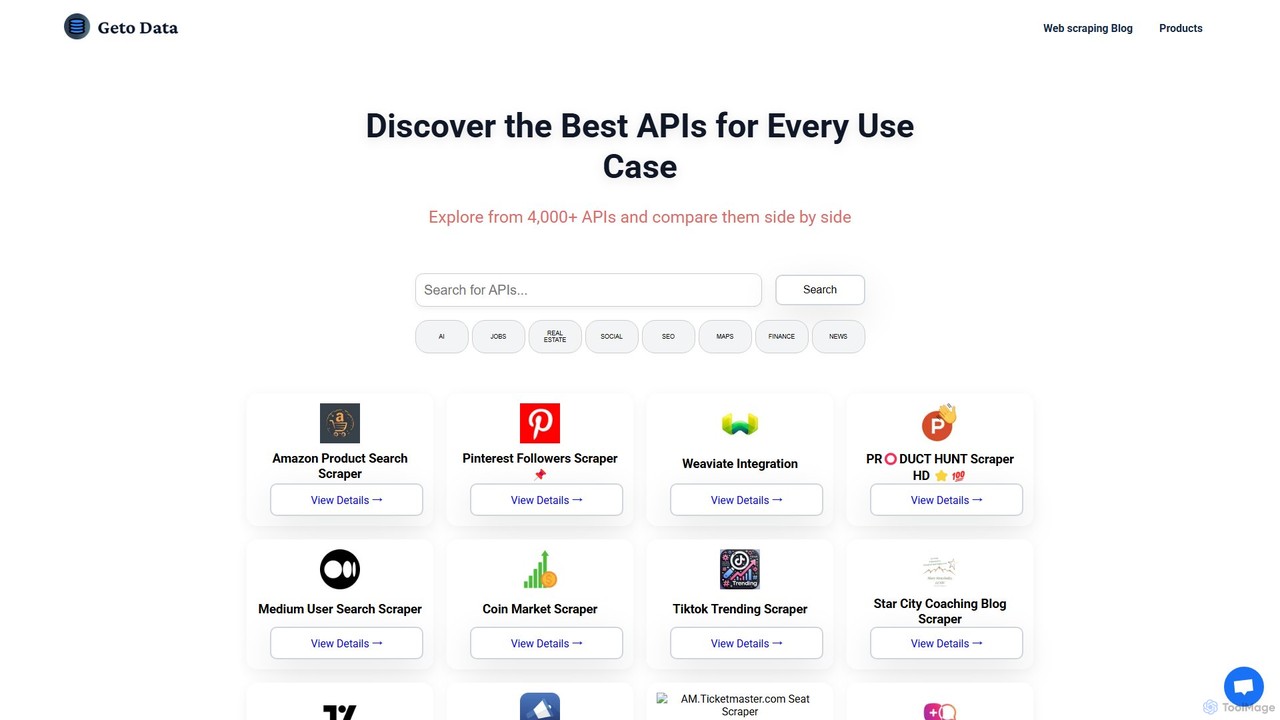
GetOData
Ein umfassendes Verzeichnis zum Entdecken, Vergleichen und Nutzen von über 4.000 vorgefertigten APIs und No-Code-Web-Scrapern. Extrahieren Sie strukturierte Daten von Websites für Marktforschung, Lead-Generierung und Prozessautomatisierung, ohne Code zu schreiben.
Analysen
Crawlora
Crawlora ist eine KI-gestützte No-Code-Web-Scraping-Plattform, die es Benutzern ermöglicht, mühelos Daten von jeder Website zu extrahieren. Die intelligente Point-and-Click-Oberfläche vereinfacht die Datenextraktion und ermöglicht es Ihnen, Webseiten in strukturierte Daten (CSV, JSON) umzuwandeln, ohne eine einzige Zeile Code zu schreiben. Ideal für Marktforschung, Lead-Generierung und Preisüberwachung.
Datenextraktion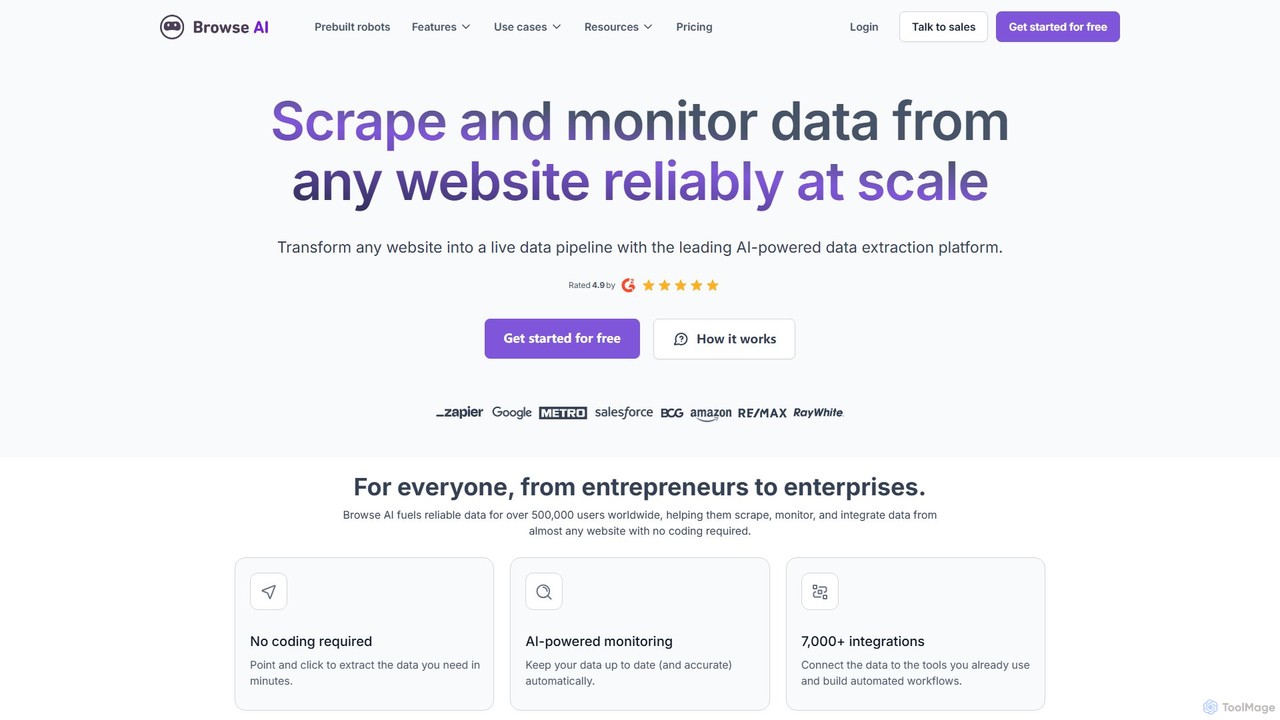
Browse AI
Browse AI ist eine No-Code-Plattform, die es Benutzern ermöglicht, Daten von jeder Website zu extrahieren und zu überwachen. Trainieren Sie einfach einen Roboter, um Informationen zu scrapen, Websites in Tabellenkalkulationen oder APIs umzuwandeln und Änderungen automatisch zu verfolgen. Es ist für Vermarkter, Forscher und Entwickler konzipiert, um die Datenerfassung ohne Programmierung zu automatisieren, und bietet vorgefertigte Roboter und nahtlose Integrationen mit Tools wie Google Sheets und Zapier.
Web Scraping
FetchFox Comments (0)
Sign in to comment.
AnmeldenNo comments yet.