

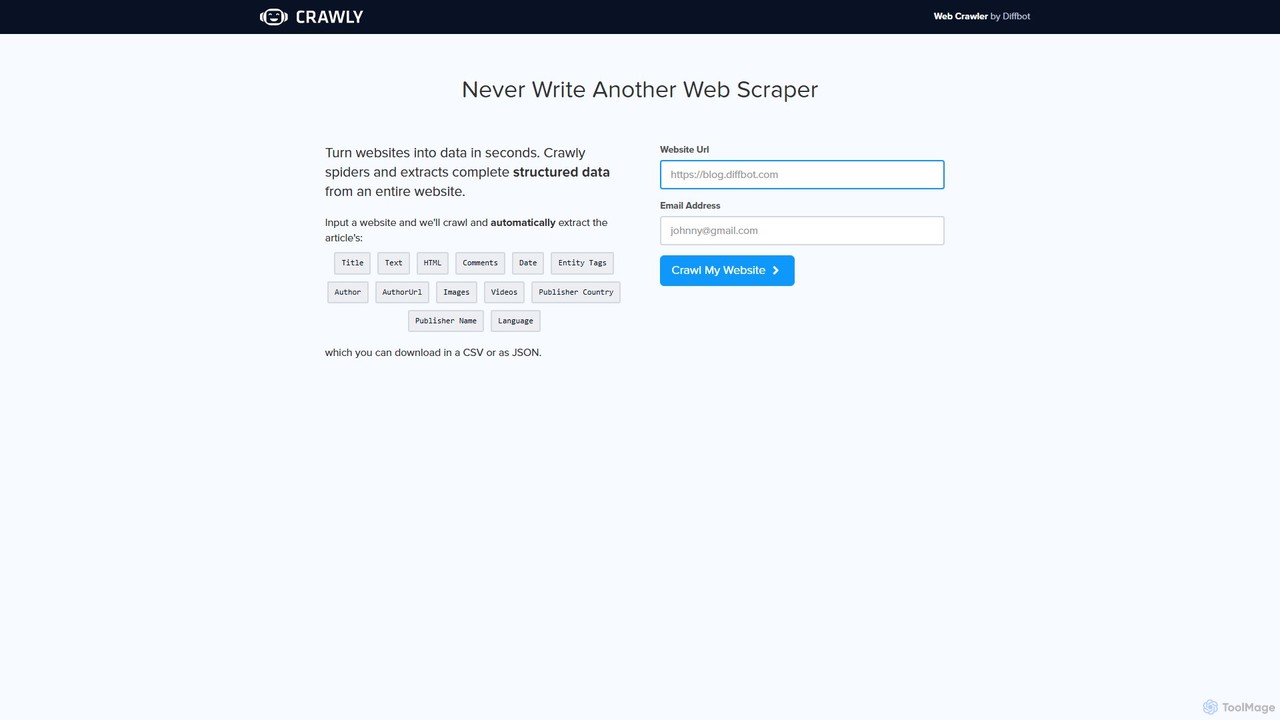
Crawly Overview
Crawly ist ein leistungsstarker und intelligenter Web-Crawler, der von Diffbot, einem führenden Anbieter von KI-gestützter Datenextraktion, entwickelt wurde. Er wurde entwickelt, um die manuellen und technischen Herausforderungen des Web-Scrapings vollständig zu beseitigen. Anstatt komplexen Code zu schreiben oder fragile Selektoren zu verwenden, die bei Website-Updates brechen, nutzt Crawly fortschrittliche künstliche Intelligenz, einschließlich Computer Vision und Natural Language Processing, um Webseiten wie ein Mensch zu verstehen und zu interpretieren. Dies ermöglicht es, automatisch vollständige, strukturierte Daten von einer gesamten Website mit nur einer URL als Eingabe zu identifizieren und zu extrahieren.
Das Kernversprechen von Crawly lautet: 'Websites in Sekundenschnelle in Daten verwandeln'. Es navigiert durch eine Website, folgt Links und analysiert die Struktur jeder Seite, um zwischen verschiedenen Inhaltstypen wie Artikeln, Produkten, Diskussionen und Bildergalerien zu unterscheiden. Die extrahierten Daten werden dann in einem sauberen, strukturierten Format organisiert, das sofort für Anwendungen, Datenanalysen oder maschinelle Lernmodelle bereitsteht.
Wie man Crawly verwendet
Die Verwendung von Crawly ist so konzipiert, dass sie für jeden unglaublich einfach und zugänglich ist, unabhängig von den technischen Fähigkeiten. Der Prozess umfasst nur wenige Schritte:
- URL eingeben: Navigieren Sie zur Crawly-Website. Geben Sie im dafür vorgesehenen Eingabefeld die vollständige URL der Website ein, die Sie crawlen möchten.
- E-Mail angeben: Geben Sie Ihre E-Mail-Adresse ein. Diese wird verwendet, um Sie zu benachrichtigen und die Ergebnisse zu liefern, sobald der Crawl abgeschlossen ist.
- Crawl starten: Klicken Sie auf die Schaltfläche 'Crawl My Website'. Die KI-Engine von Crawly beginnt dann, die gesamte Website zu durchsuchen, Seiten zu analysieren und Informationen zu extrahieren.
- Daten herunterladen: Sobald der Vorgang abgeschlossen ist, erhalten Sie die extrahierten Daten. Sie können sie in praktischen, strukturierten Formaten wie JSON oder CSV herunterladen, was den Import in Datenbanken, Tabellenkalkulationen oder andere Software erleichtert.
Kernfunktionen von Crawly
- KI-gestützte automatische Extraktion: Nutzt die fortschrittliche KI von Diffbot, um Daten aus Artikeln, Produkten, Diskussionen und mehr automatisch zu erkennen und zu extrahieren, ohne manuelle Konfiguration.
- Umfassende Datenfelder: Extrahiert einen reichen Satz von Datenpunkten, einschließlich Titel, Text, HTML, Kommentare, Datum, Autor, Autor-URL, Bilder, Videos, Herausgeberinformationen (Land, Name) und Sprache.
- Entitätserkennung: Identifiziert und markiert automatisch Entitäten im Text, wie Personen, Organisationen und Orte, und fügt eine weitere Ebene wertvoller Metadaten hinzu.
- Vollständiges Website-Crawling: Im Gegensatz zu Einzelseiten-Scrapern navigiert Crawly durch eine gesamte Website, um Daten umfassend zu sammeln.
- Strukturierte Datenausgabe: Liefert saubere, gut strukturierte Daten in den Formaten JSON oder CSV, wodurch die Notwendigkeit der Nachbearbeitung und Datenbereinigung entfällt.
- No-Code-Lösung: Erfordert keine Programmierkenntnisse oder Wissen über Web-Scraping-Technologien, was es für Vermarkter, Forscher und Geschäftsanalysten zugänglich macht.
- Robust und widerstandsfähig: Da es die semantische Struktur des Inhalts versteht, wird es nicht leicht durch Änderungen am Website-Layout beeinträchtigt, ein häufiges Problem bei herkömmlichen Scrapern.
Anwendungsfälle für Crawly
Crawly ist ein vielseitiges Werkzeug, das für eine breite Palette von Anwendungen geeignet ist:
- Marktforschung: Sammeln Sie automatisch Produktinformationen, Preise, Kundenbewertungen und Erwähnungen in den Nachrichten von Wettbewerbern, um einen Wettbewerbsvorteil zu erzielen.
- Lead-Generierung: Extrahieren Sie Kontaktdaten, Unternehmensinformationen und Schlüsselpersonal von Unternehmenswebsites und Online-Verzeichnissen.
- Content-Aggregation: Erstellen Sie einen benutzerdefinierten Newsfeed oder eine Content-Plattform, indem Sie Artikel, Blog-Posts und Videos aus mehreren Quellen aggregieren.
- Daten für maschinelles Lernen: Erstellen Sie große, hochwertige Datensätze für das Training von maschinellen Lernmodellen, wie z. B. Sentiment-Analysen von Produktbewertungen oder Trendanalysen aus Nachrichtenartikeln.
- Markenüberwachung: Verfolgen Sie in Echtzeit, wie Ihre Marke, Produkte oder Führungskräfte im Web erwähnt werden.
Vorteile von Crawly
Der Hauptvorteil von Crawly liegt in seiner Einfachheit und Leistungsfähigkeit. Es demokratisiert die Webdatenextraktion und ermöglicht es Nicht-Entwicklern, Aufgaben auszuführen, die normalerweise ein Team von Ingenieuren erfordern würden. Es spart immense Mengen an Zeit und Ressourcen, indem es den gesamten Scraping-Prozess automatisiert. Darüber hinaus gewährleistet sein KI-gesteuerter Ansatz eine höhere Genauigkeit und größere Widerstandsfähigkeit als herkömmliche Methoden und liefert einen zuverlässigen Strom hochwertiger Daten. Als Produkt von Diffbot wird es von unternehmenstauglicher Technologie unterstützt, der große Konzerne weltweit vertrauen.
Preise und Pläne
Crawly bietet einen kostenlosen Test-Crawl direkt von seiner Homepage an, der es den Benutzern ermöglicht, seine Fähigkeiten durch Eingabe einer URL und einer E-Mail-Adresse zu testen. Dies soll eine Probe der strukturierten Daten liefern, die das Tool produzieren kann. Für umfangreichere Anforderungen, wie z. B. groß angelegtes Crawling, häufige Datenextraktion oder API-Zugriff für die programmatische Nutzung, würden Benutzer normalerweise die gesamte Suite von Tools abonnieren, die von seiner Muttergesellschaft Diffbot angeboten wird. Die Preisgestaltung von Diffbot ist gestaffelt, mit Plänen für Startups, Unternehmen und große Konzerne, die unterschiedliche Stufen von API-Aufrufen und Funktionen bieten.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 2.6K
- 2026-1: 784
- 2026-2: 640
- 2026-3: 1.0K
- 2026-4: 475
- 2026-5: 1.8K
Geography
Top 5 countries / regions
- 🇳🇬Nigeria82.4%
- 🇩🇪Deutschland9.9%
- 🇨🇦Kanada7.7%
Top keywords
| Keyword | Cost per click |
|---|---|
| crawl url | $0.00 |
| crawly | $0.00 |
| online web crawler | $0.00 |
| website crawler | $2.37 |
| website crawler online | $0.00 |
Crawly Alternatives
webscrapeai
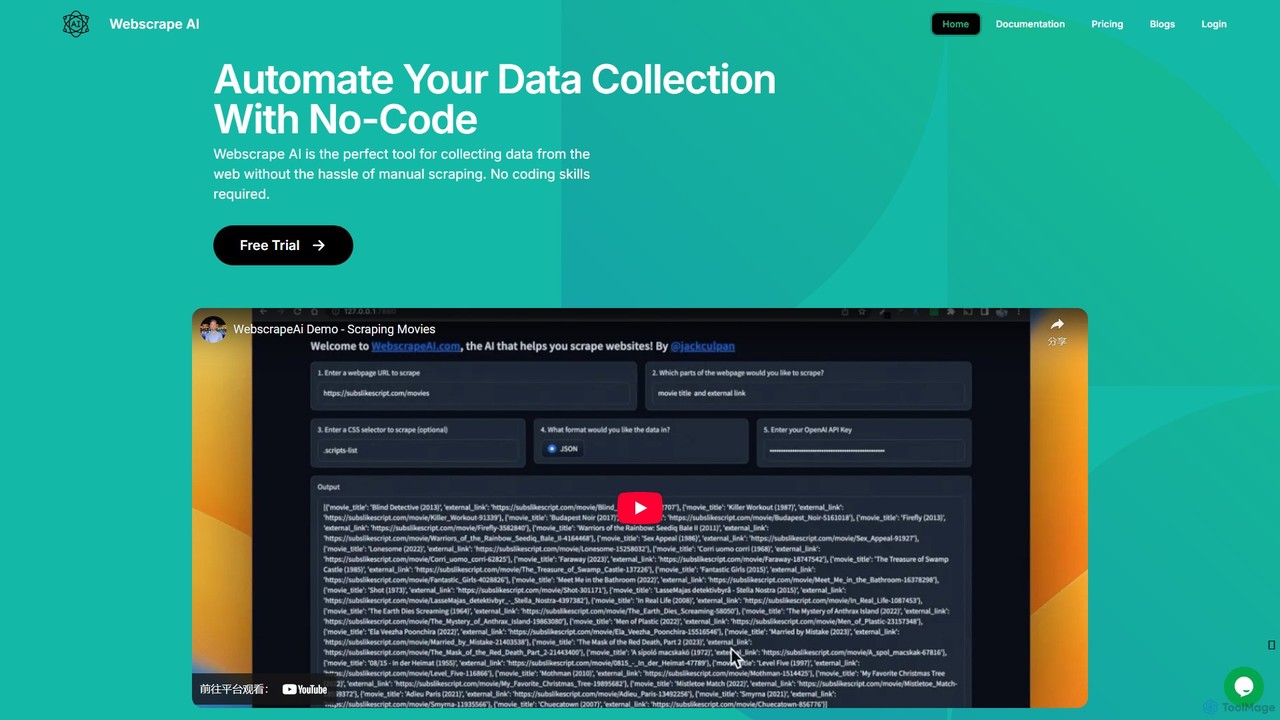
WebscrapeAI ist eine No-Code, KI-gestützte Plattform zur Automatisierung der Web-Datenerfassung. Geben Sie einfach eine URL an und spezifizieren Sie die benötigten Daten, und die KI übernimmt den gesamten Scraping-Prozess. Es unterstützt dynamische Websites, Massen-Scraping, Proxy-Integration und bietet eine API für Entwickler, was die Datenextraktion schnell, genau und für jeden zugänglich macht.
Web Scraping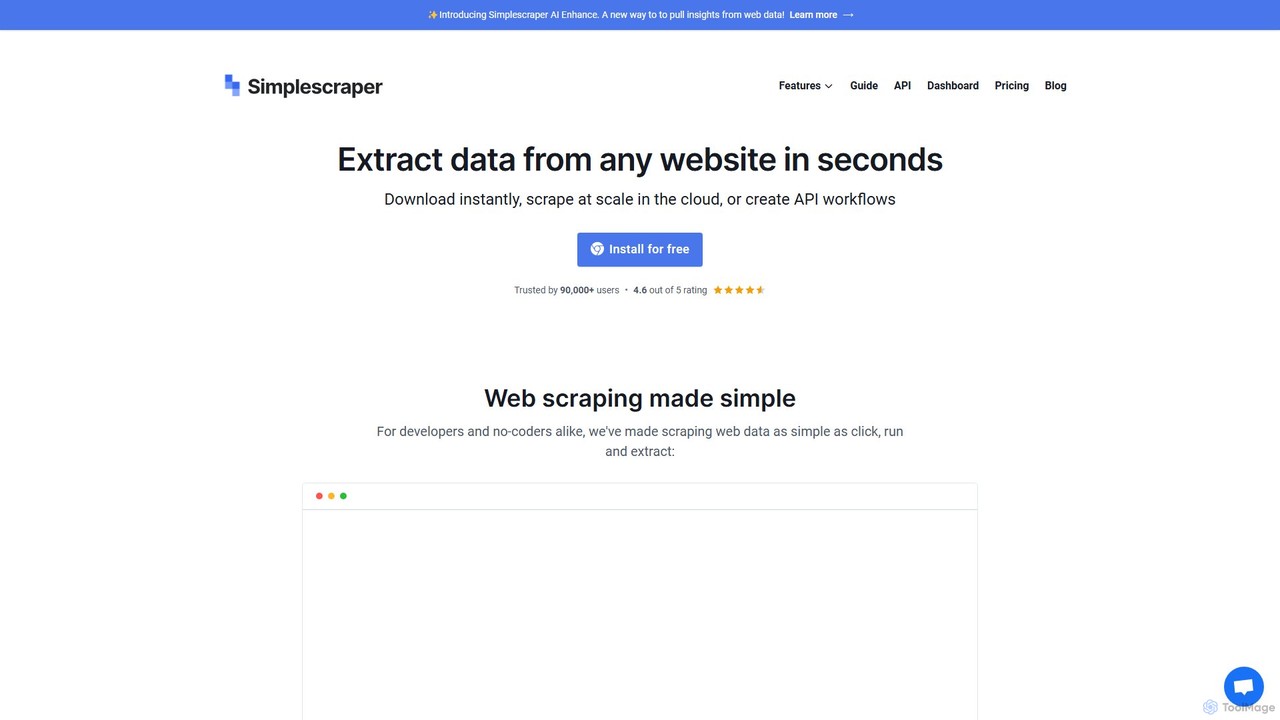
Simplescraper
Simplescraper ist ein leistungsstarkes Web-Scraping-Tool, das in Sekundenschnelle Daten von jeder Website extrahiert. Es bietet eine benutzerfreundliche Chrome-Erweiterung für die Datenauswahl ohne Code, cloudbasierte Automatisierung für groß angelegtes Scraping und eine innovative KI-Enhance-Funktion, um mit einfachen Anweisungen Erkenntnisse zu gewinnen. Verwandeln Sie Websites in strukturierte Daten (CSV, JSON) oder sofortige APIs und integrieren Sie sie mit Tools wie Google Sheets und Airtable.
Web Scraping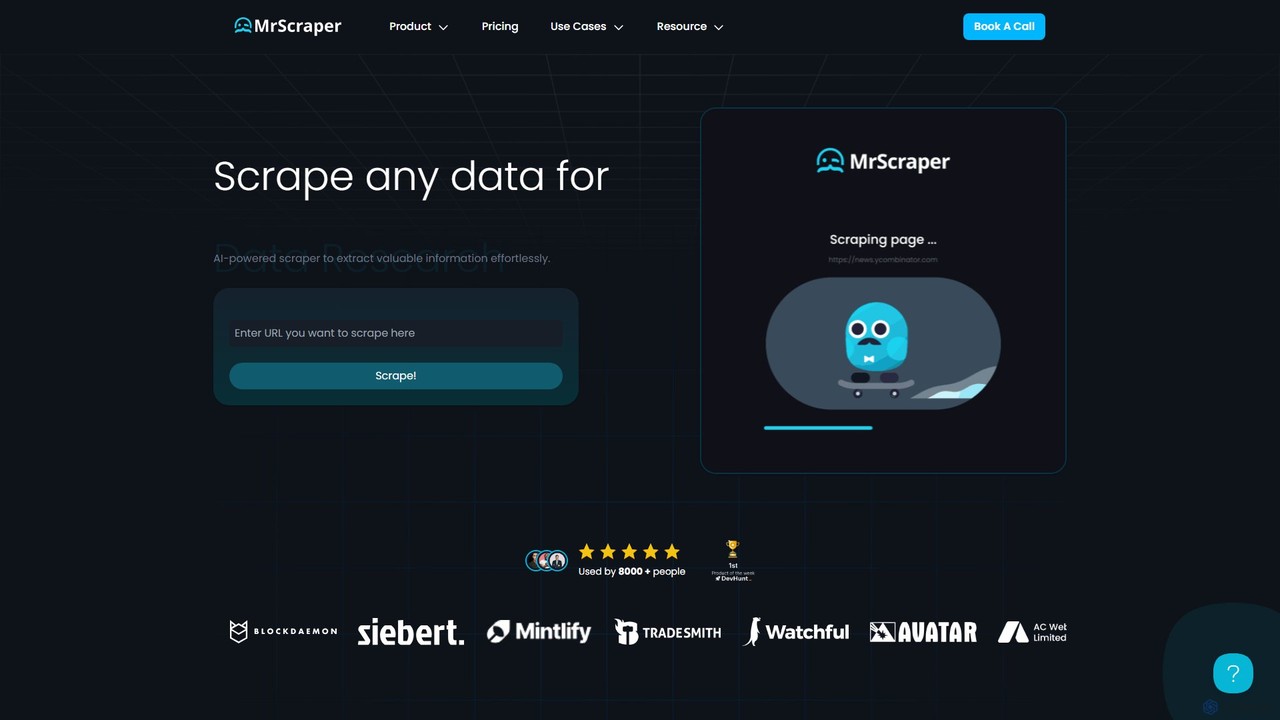
MrScraper
MrScraper ist ein KI-gestütztes No-Code-Web-Scraping-Tool, mit dem Benutzer mühelos strukturierte Daten von jeder Website extrahieren können. Es automatisiert den Datenerfassungsprozess, umgeht Anti-Bot-Maßnahmen wie CAPTCHAs und IP-Sperren und ist somit ideal für Preisintelligenz, Marktforschung und Lead-Generierung.
Web Scraping
SingleAPI
SingleAPI ist ein GPT-4-gestütztes Tool, das jede Website sofort in eine strukturierte JSON-API umwandelt. Es vereinfacht Web-Scraping, Datenextraktion und Datenanreicherung, ohne dass Code oder Selektoren geschrieben werden müssen, und ermöglicht Benutzern den mühelosen Zugriff auf Webdaten für verschiedene Anwendungen.
Web Scraping
Bright Data
Bright Data ist die weltweit führende Web-Datenplattform und bietet eine umfassende Suite von Tools, einschließlich Proxy-Netzwerken, KI-gestützten Web-Scrapern und sofort einsatzbereiten Datensätzen. Sie ermöglicht es Unternehmen, große Mengen öffentlicher Web-Daten für KI-Training, Marktforschung und Wettbewerbsanalyse zu sammeln.
Business IntelligenceCrawly Categories
Crawly Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
webscrapeai
WebscrapeAI ist eine No-Code, KI-gestützte Plattform zur Automatisierung der Web-Datenerfassung. Geben Sie einfach eine URL an und spezifizieren Sie die benötigten Daten, und die KI übernimmt den gesamten Scraping-Prozess. Es unterstützt dynamische Websites, Massen-Scraping, Proxy-Integration und bietet eine API für Entwickler, was die Datenextraktion schnell, genau und für jeden zugänglich macht.
Web ScrapingSimplescraper
Simplescraper ist ein leistungsstarkes Web-Scraping-Tool, das in Sekundenschnelle Daten von jeder Website extrahiert. Es bietet eine benutzerfreundliche Chrome-Erweiterung für die Datenauswahl ohne Code, cloudbasierte Automatisierung für groß angelegtes Scraping und eine innovative KI-Enhance-Funktion, um mit einfachen Anweisungen Erkenntnisse zu gewinnen. Verwandeln Sie Websites in strukturierte Daten (CSV, JSON) oder sofortige APIs und integrieren Sie sie mit Tools wie Google Sheets und Airtable.
Web Scraping
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Lection
Lection ist ein KI-gestützter Web-Scraping-Agent, der es Benutzern ermöglicht, strukturierte Daten von jeder Website mithilfe natürlicher Sprache zu extrahieren. Es automatisiert die Datenerfassung, integriert sich in gängige Workflows und liefert saubere, validierte Daten ohne Programmierkenntnisse.
3D
Browse AI
Browse AI ist eine No-Code-Plattform, die es Benutzern ermöglicht, Daten von jeder Website zu extrahieren und zu überwachen. Trainieren Sie einfach einen Roboter, um Informationen zu scrapen, Websites in Tabellenkalkulationen oder APIs umzuwandeln und Änderungen automatisch zu verfolgen. Es ist für Vermarkter, Forscher und Entwickler konzipiert, um die Datenerfassung ohne Programmierung zu automatisieren, und bietet vorgefertigte Roboter und nahtlose Integrationen mit Tools wie Google Sheets und Zapier.
Web Scraping
Octoparse
Octoparse ist ein leistungsstarkes No-Code-Web-Scraping-Tool, mit dem jeder ohne Programmierung Daten von Websites extrahieren kann. Es verfügt über einen visuellen Workflow-Designer, einen KI-gestützten Assistenten für eine einfache Einrichtung und Hunderte von vorgefertigten Vorlagen für beliebte Websites. Mit cloudbasierter Automatisierung, IP-Rotation und CAPTCHA-Lösung bewältigt Octoparse komplexe Scraping-Aufgaben effizient und wandelt Webseiten in strukturierte Daten für die Lead-Generierung, Marktforschung und mehr um.
Web Scraping
hystruct
hystruct ist ein KI-gestütztes Web-Scraping-Tool, das die Datenextraktion vereinfacht. Es ermöglicht Benutzern, unstrukturierte Webinhalte einfach in strukturierte Daten umzuwandeln, indem vordefinierte oder benutzerdefinierte Schemata verwendet werden, ohne dass Code erforderlich ist. Mit Integrationen wie Zapier automatisiert es Arbeitsabläufe für Marktforschung, Lead-Generierung und mehr. Es ist für jeden konzipiert, vom Anfänger bis zum Enterprise-Team.
Scraping
instantapi
instantapi ist eine KI-gestützte Web-Scraping-API, die auf Einfachheit und Geschwindigkeit ausgelegt ist. Sie ermöglicht es Benutzern, strukturierte Daten von jeder Website mit einem einzigen API-Aufruf zu extrahieren, ohne dass komplexe Programmierung oder manuelle Einrichtung erforderlich ist. Ideal für Entwickler, Datenanalysten und Unternehmen, die eine schnelle, kostengünstige und zuverlässige Datenextraktion ohne den Aufwand herkömmlicher Web-Scraper benötigen.
Datenextraktion
Curlent
Curlent ist eine KI-gestützte Web-Scraping- und Datenextraktionsplattform, die die Sammlung strukturierter Daten von jeder Website automatisiert. Sie behandelt intelligent dynamische Inhalte, Anti-Bot-Maßnahmen und komplexe Layouts und liefert saubere, gebrauchsfertige Daten über eine leistungsstarke API.
Scraping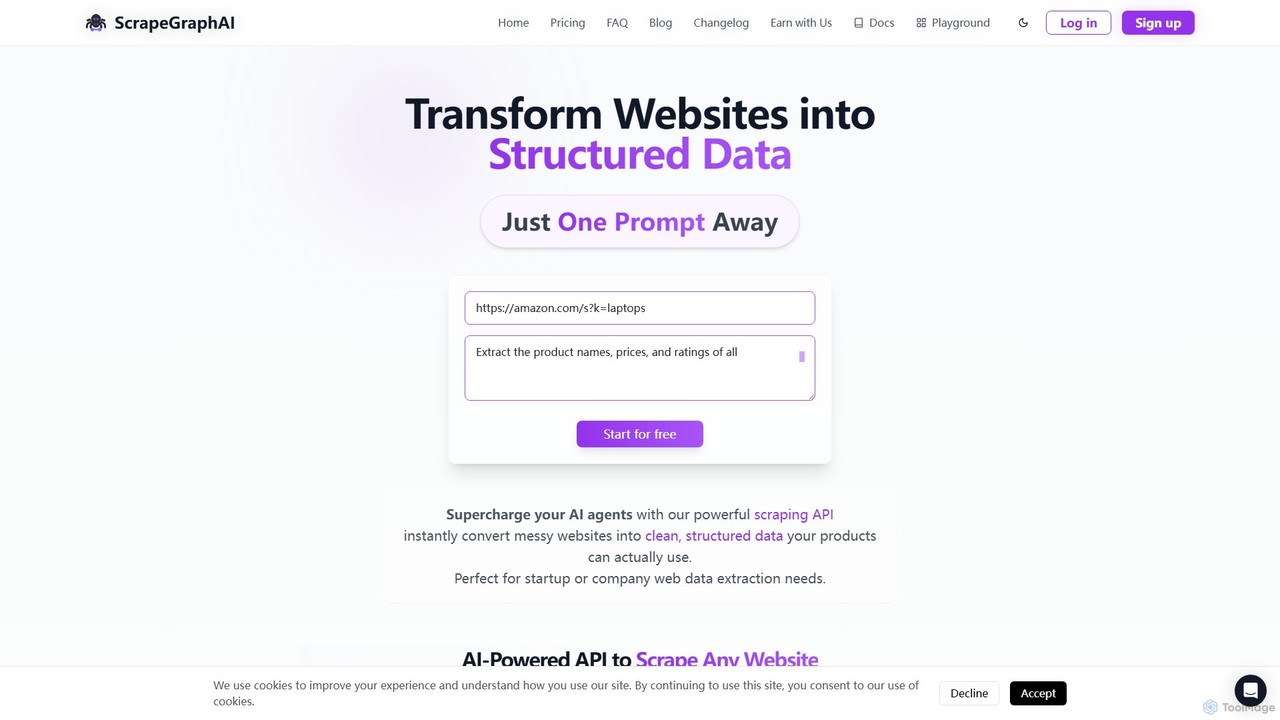
ScrapeGraphAI
ScrapeGraphAI ist eine KI-gestützte Web-Scraping-API, die unstrukturierte Websites mit einfachen Anweisungen in natürlicher Sprache in saubere, strukturierte JSON-Daten umwandelt. Entwickelt für Entwickler, KI-Agenten und automatisierte Workflows, vereinfacht es die Datenextraktion ohne komplexen Code.
Analysen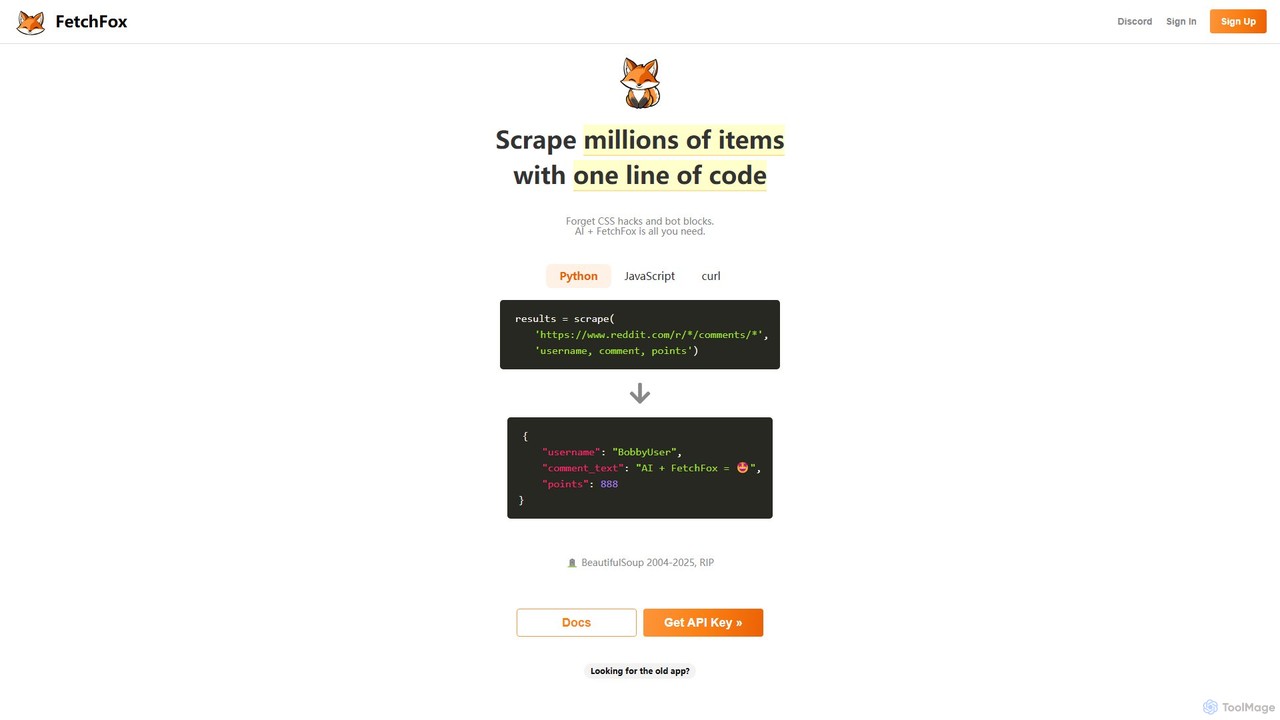
FetchFox
FetchFox ist ein KI-gestütztes Web-Scraping-Tool, das es Benutzern ermöglicht, Daten von jeder Website mit einfachen Textanweisungen zu extrahieren. Es eliminiert die Notwendigkeit komplexer Codierung oder CSS-Selektoren und handhabt automatisch Anti-Bot-Maßnahmen. Verfügbar als API, JavaScript-Bibliothek und Chrome-Erweiterung, ist es sowohl für Entwickler als auch für nicht-technische Benutzer konzipiert, um die Datenerfassung mühelos zu automatisieren.
Datenextraktion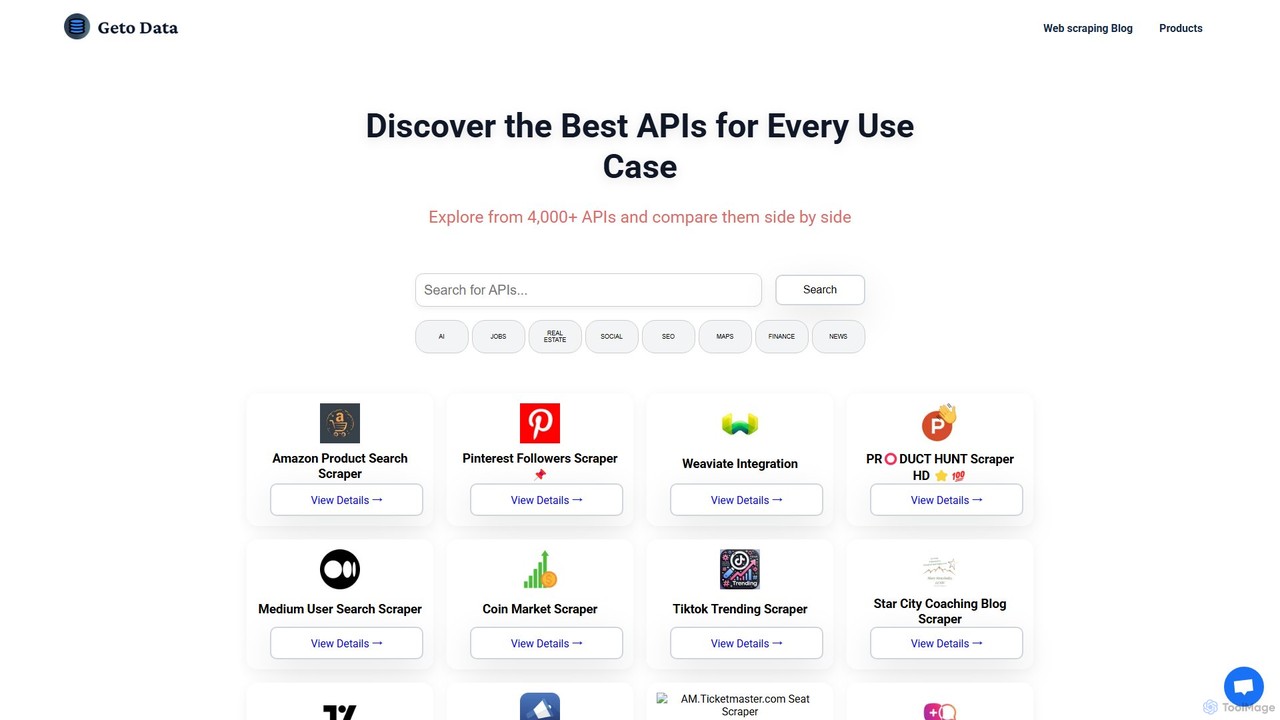
GetOData
Ein umfassendes Verzeichnis zum Entdecken, Vergleichen und Nutzen von über 4.000 vorgefertigten APIs und No-Code-Web-Scrapern. Extrahieren Sie strukturierte Daten von Websites für Marktforschung, Lead-Generierung und Prozessautomatisierung, ohne Code zu schreiben.
AnalysenMrScraper
MrScraper ist ein KI-gestütztes No-Code-Web-Scraping-Tool, mit dem Benutzer mühelos strukturierte Daten von jeder Website extrahieren können. Es automatisiert den Datenerfassungsprozess, umgeht Anti-Bot-Maßnahmen wie CAPTCHAs und IP-Sperren und ist somit ideal für Preisintelligenz, Marktforschung und Lead-Generierung.
Web ScrapingSingleAPI
SingleAPI ist ein GPT-4-gestütztes Tool, das jede Website sofort in eine strukturierte JSON-API umwandelt. Es vereinfacht Web-Scraping, Datenextraktion und Datenanreicherung, ohne dass Code oder Selektoren geschrieben werden müssen, und ermöglicht Benutzern den mühelosen Zugriff auf Webdaten für verschiedene Anwendungen.
Web Scraping
Crawlora
Crawlora ist eine KI-gestützte No-Code-Web-Scraping-Plattform, die es Benutzern ermöglicht, mühelos Daten von jeder Website zu extrahieren. Die intelligente Point-and-Click-Oberfläche vereinfacht die Datenextraktion und ermöglicht es Ihnen, Webseiten in strukturierte Daten (CSV, JSON) umzuwandeln, ohne eine einzige Zeile Code zu schreiben. Ideal für Marktforschung, Lead-Generierung und Preisüberwachung.
Datenextraktion
Crawly Comments (0)
Sign in to comment.
AnmeldenNo comments yet.