ToolMage
Anmelden

AI TOOL COMPARISON

Crawlbase vs FetchFox

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

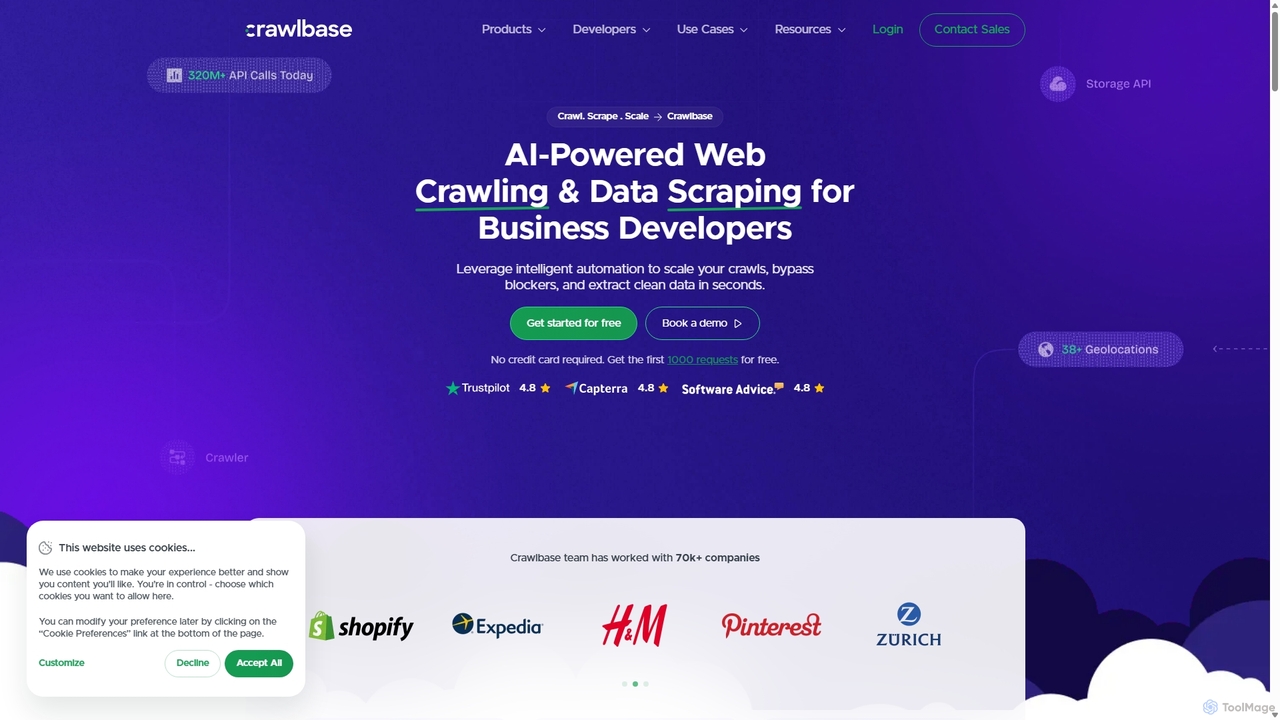
Crawlbase Produktübersicht

Crawlbase ist eine KI-gestützte Web-Crawling- und Daten-Scraping-Plattform für Entwickler und Unternehmen. Sie bietet eine Reihe von Tools, einschließlich einer Crawling-API und eines Smart Proxy, um anonym Daten von jeder Website in großem Maßstab zu extrahieren und dabei Blockaden und CAPTCHAs mit hoher Erfolgsquote zu umgehen. Sie vereinfacht die Datenerfassung für SEO, Marktforschung, E-Commerce-Intelligenz und das Training von KI-Modellen.

Preview

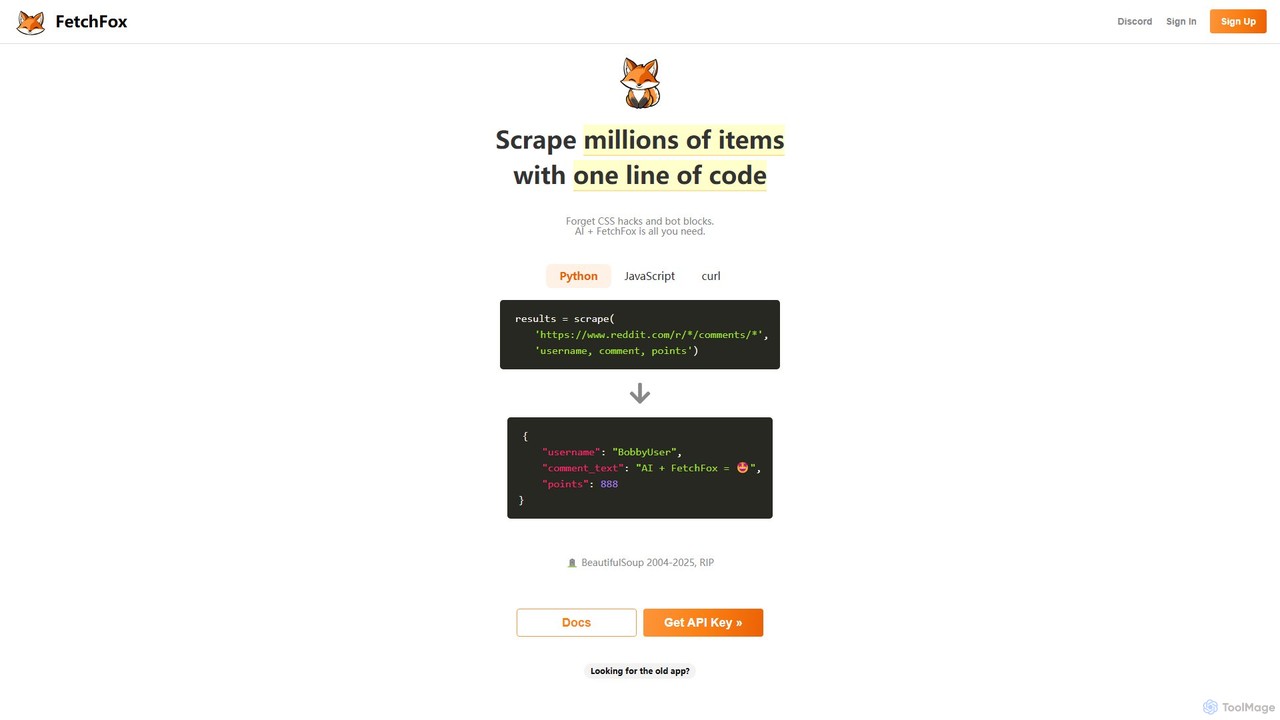
FetchFox Produktübersicht

FetchFox ist ein KI-gestütztes Web-Scraping-Tool, das es Benutzern ermöglicht, Daten von jeder Website mit einfachen Textanweisungen zu extrahieren. Es eliminiert die Notwendigkeit komplexer Codierung oder CSS-Selektoren und handhabt automatisch Anti-Bot-Maßnahmen. Verfügbar als API, JavaScript-Bibliothek und Chrome-Erweiterung, ist es sowohl für Entwickler als auch für nicht-technische Benutzer konzipiert, um die Datenerfassung mühelos zu automatisieren.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Crawlbase VS FetchFox — Kerndaten
KerndatenCrawlbaseFetchFox
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusDatenextraktionDatenextraktion
Zielgruppen und RollenGeschäftsinhaber · Datenanalyst · Marketing Manager · Produktmanager · Forscher · Vertriebsmitarbeiter · SEO-Spezialist · SoftwareentwicklerNicht verifiziert
KategorienDatenextraktion · Web Scraping · Lead-GenerierungDatenextraktion · Web Scraping · Lead-Generierung · Automatisierung
Added11.09.202513.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Crawlbase

Crawlbase ist eine umfassende, KI-gesteuerte Plattform, die den Zugang zu Webdaten demokratisieren soll. Sie ermöglicht Entwicklern, Datenwissenschaftlern und Unternehmen, das Internet in großem Maßstab zu crawlen und zu scrapen und unstrukturierte Webinhalte in saubere, strukturierte Daten umzuwandeln. Indem Crawlbase die komplexe Infrastruktur von Proxys, Browser-Automatisierung und Anti-Bot-Systemen übernimmt, können sich die Benutzer ausschließlich auf die Datennutzung konzentrieren. Die Plattform basiert auf Millionen von rotierenden Residential- und Rechenzentrums-Proxys weltweit und gewährleistet so einen anonymen und uneingeschränkten Zugriff auf Websites wie Amazon, LinkedIn, Google und mehr mit einer garantierten Verfügbarkeit von 99,9 %.

Wie man Crawlbase verwendet

Die Integration von Crawlbase in Ihren Arbeitsablauf ist unkompliziert und in wenigen Minuten erledigt:

  1. Konto erstellen: Registrieren Sie sich für ein kostenloses Crawlbase-Konto. Sie erhalten einen API-Token zur Authentifizierung. Der anfängliche Plan beinhaltet 1.000 kostenlose Anfragen, um den Dienst ohne Kreditkarte zu testen.
  2. Das richtige Werkzeug wählen: Wählen Sie das passende Produkt für Ihre Bedürfnisse. Verwenden Sie die Crawling-API für synchrone Datenanfragen in Echtzeit. Für große, laufende Projekte ist der asynchrone Crawler kostengünstiger. Wenn Sie ein einfaches Proxy-Gateway für Ihre Anwendung benötigen, ist der Smart Proxy die ideale Wahl.
  3. Eine API-Anfrage stellen: Machen Sie einen einfachen API-Aufruf an den Crawlbase-Endpunkt und übergeben Sie Ihren API-Token und die Ziel-URL, die Sie scrapen möchten. Sie können verschiedene Parameter hinzufügen, um das JavaScript-Rendering zu aktivieren, Geo-Standorte festzulegen oder spezifische Daten-Scraper zu verwenden.
  4. Daten empfangen: Crawlbase verarbeitet die Anfrage, umgeht Blockaden, Proxys und CAPTCHAs. Anschließend wird der vollständige HTML-Inhalt der Seite zurückgegeben oder, bei Verwendung eines spezifischen Scrapers (wie dem Amazon-Scraper), die Daten in einem strukturierten JSON-Format bereitgestellt.

Kernfunktionen von Crawlbase

  • Crawling-API: Eine leistungsstarke, einfach zu bedienende API, die Webseiteninhalte in Echtzeit abruft. Sie unterstützt JavaScript-Rendering für dynamische Websites und enthält integrierte Scraper für beliebte Seiten wie Amazon, die strukturierte Daten direkt liefern.
  • Der Crawler: Eine asynchrone Crawling-Lösung für massive Datenextraktionsprojekte. Er verwendet Callbacks, um Daten an Ihre Server zu liefern, was bei großen URL-Mengen Kosten, Bandbreite und Wiederholungsversuche spart.
  • Smart Proxy: Eine rotierende Proxy-Lösung, die Zugriff auf Millionen von Rechenzentrums- und Residential-IPs bietet. Sie kann leicht in jede Anwendung oder jedes Skript integriert werden, das einen zuverlässigen Proxy benötigt, um Blockaden zu vermeiden.
  • KI-gestützte Anti-Blocking-Technologie: Ausgeklügelte Algorithmen und maschinelle Lernmodelle, die automatisch IP-Blockaden, Browser-Fingerprinting, CAPTCHAs und andere Anti-Scraping-Maßnahmen handhaben und eine hohe Erfolgsquote gewährleisten.
  • Cloud-Speicher: Eine praktische Funktion, mit der Sie Ihre gecrawlten und gescrapten Daten direkt in den sicheren Cloud-Speicher von Crawlbase verschieben können, was Ihre Datenpipeline vereinfacht.
  • Globale Geolokalisierung: Greifen Sie auf Webinhalte aus über 30 verschiedenen Ländern zu, um lokalisierte Suchen durchzuführen und regionalspezifische Daten zu sammeln.

Anwendungsfälle für Crawlbase

Crawlbase ist vielseitig und unterstützt eine breite Palette von datengesteuerten Geschäftsaktivitäten:

  • E-Commerce & Einzelhandel: Überwachen Sie Wettbewerberpreise, verfolgen Sie die Produktverfügbarkeit, sammeln Sie Kundenbewertungen und analysieren Sie Produktdaten von Plattformen wie Amazon, eBay und Walmart, um Verkaufsstrategien zu optimieren.
  • Marktforschung: Sammeln Sie riesige Datenmengen für die Analyse von Markttrends, die Stimmungsanalyse aus sozialen Medien und Foren und die Identifizierung neuer Geschäftsmöglichkeiten.
  • Lead-Generierung: Automatisieren Sie die Erfassung von Kontaktinformationen und Geschäftsdetails aus professionellen Netzwerken wie LinkedIn, Online-Verzeichnissen und Unternehmenswebsites.
  • KI und Maschinelles Lernen: Stellen Sie hochwertige, strukturierte Datensätze für das Training von generativer KI und großen Sprachmodellen (LLMs) bereit. Die API kann die benötigten riesigen Mengen an Text- und Bilddaten effizient sammeln.
  • SEO-Überwachung: Verfolgen Sie Keyword-Rankings über verschiedene Suchmaschinen und Standorte hinweg, analysieren Sie die SEO-Strategien der Konkurrenz und führen Sie umfassende Website-Audits durch, ohne blockiert zu werden.

Vorteile von Crawlbase

Crawlbase bietet einen erheblichen Wettbewerbsvorteil, indem es die Komplexität des Web-Scrapings abstrahiert. Anstatt eine kostspielige und fragile interne Infrastruktur aufzubauen und zu warten, profitieren die Benutzer von einer zuverlässigen, skalierbaren und kostengünstigen Lösung. Zu den Hauptvorteilen der Plattform gehören ihr riesiges Proxy-Netzwerk, die hohe Erfolgsquote (über 99 %), die 99,9 %-ige Verfügbarkeitsgarantie und der 24/7-Experten-Support. Der entwicklerorientierte Ansatz gewährleistet eine einfache Integration und eine robuste Dokumentation, während das Engagement für die Einhaltung von Vorschriften (DSGVO & CCPA) Unternehmen Sicherheit gibt.

Preise und Pläne

Crawlbase arbeitet mit einem flexiblen und transparenten Freemium-Modell. Neue Benutzer können mit einem kostenlosen Plan beginnen, der 1.000 kostenlose Anfragen enthält, sodass sie die Funktionen der Plattform vollständig testen können, ohne eine Kreditkarte angeben zu müssen. Nach der kostenlosen Testphase basiert die Preisgestaltung auf einem Pay-as-you-go-System, bei dem die Kosten von der Anzahl der gestellten Anfragen und den genutzten Funktionen (z. B. Standardanfragen vs. JavaScript-fähige Anfragen) abhängen. Für Unternehmen mit hohem Datenbedarf bietet Crawlbase maßgeschneiderte Enterprise-Pläne an, die individuelle Preise, dediziertes Account-Management und Premium-Support bieten, um spezifische Projektanforderungen zu erfüllen.

FetchFox

FetchFox ist eine revolutionäre, KI-gestützte Web-Scraping-Plattform, die entwickelt wurde, um den Prozess der Datenextraktion aus dem Web zu vereinfachen und zu automatisieren. Es verändert grundlegend, wie Benutzer an das Web-Scraping herangehen, indem es komplexe Codierung, CSS-Selektoren und die Wartung fragiler Skripte durch einfache, natürlichsprachliche Anweisungen ersetzt. Egal, ob Sie ein Entwickler sind, der Daten in eine Anwendung integrieren muss, oder ein Geschäftsanwender, der Marktinformationen sammeln möchte, FetchFox bietet eine robuste und zugängliche Lösung.

Das Kernprinzip von FetchFox ist seine KI-Engine, die die Struktur und den Inhalt einer Webseite intelligent versteht. Benutzer beschreiben einfach die Daten, die sie extrahieren möchten, und die KI erledigt den Rest. Dies umfasst das Navigieren durch Seiten, das Identifizieren der relevanten Datenpunkte und das Strukturieren der Ausgabe in ein sauberes, nutzbares Format wie JSON. Die Plattform ist so konzipiert, dass sie widerstandsfähig ist, sich automatisch an Änderungen im Website-Layout anpasst und gängige Anti-Scraping-Technologien wie CAPTCHAs und IP-Sperren umgeht, die für traditionelle Scraping-Methoden große Hürden darstellen.

Wie man FetchFox verwendet

FetchFox bietet flexible Nutzungsmöglichkeiten, um den unterschiedlichen Bedürfnissen der Benutzer gerecht zu werden:

1. Für Entwickler (API und Bibliotheken):

  • API-Schlüssel erhalten: Melden Sie sich auf der FetchFox-Website an, um Ihren einzigartigen API-Schlüssel zu erhalten.
  • In Ihren Code integrieren: Verwenden Sie die offiziellen Python- oder JavaScript-Bibliotheken (npm install fetchfox) für eine nahtlose Integration oder stellen Sie direkte cURL-Anfragen an den API-Endpunkt.
  • Ihren Scrape-Job definieren: Geben Sie in Ihrer Anfrage die Ziel-Website(s) mit `start_urls` und einem URL-`pattern` zum Crawlen mehrerer Seiten an.
  • Eine natürlichsprachliche Anweisung schreiben: Der wichtigste Teil ist der `template`-Parameter. Hier beschreiben Sie die benötigten Datenfelder, zum Beispiel: "Extrahiere den Produktnamen, den Preis, die Kundenbewertung und den Text der ersten drei Rezensionen."
  • Ausführen und Daten empfangen: Führen Sie Ihr Skript aus, um den Scraping-Job zu starten. FetchFox verarbeitet die Anfrage und gibt die extrahierten Daten in einem strukturierten JSON-Format zurück.

2. Für nicht-technische Benutzer (Chrome-Erweiterung):

  • Erweiterung installieren: Fügen Sie die FetchFox-Erweiterung aus dem Chrome Web Store zu Ihrem Chrome-Browser hinzu.
  • Navigieren und aktivieren: Gehen Sie zu der Webseite, von der Sie Daten extrahieren möchten. Öffnen Sie die Erweiterung und geben Sie Ihren API-Schlüssel ein.
  • Eine Anweisung eingeben: Geben Sie in der Benutzeroberfläche der Erweiterung einen einfachen Befehl ein, der beschreibt, was Sie sammeln möchten, z. B. "Liste alle Jobtitel und Firmennamen auf dieser Seite auf."
  • Scraping starten: Drücken Sie die 'Go'-Taste. FetchFox analysiert die Seite, extrahiert die angeforderten Informationen und ermöglicht es Ihnen, die Ergebnisse herunterzuladen, typischerweise als CSV-Datei.

Kernfunktionen von FetchFox

  • KI-gestütztes natürlichsprachliches Scraping: Keine Notwendigkeit für XPath oder CSS-Selektoren. Sagen Sie der KI einfach in einfachem Englisch, welche Daten Sie benötigen.
  • Fortschrittliche Anti-Bot-Umgehung: Navigiert intelligent durch Anti-Scraping-Maßnahmen, einschließlich dynamischer Inhalte, CAPTCHAs und Proxy-Management.
  • Multi-Plattform-Zugriff: Nutzen Sie die leistungsstarke API, die praktischen Python/JavaScript-Bibliotheken oder die benutzerfreundliche No-Code-Chrome-Erweiterung.
  • Strukturierte Datenausgabe: Liefert automatisch saubere, gut strukturierte JSON-Daten und spart Ihnen Zeit bei der Datenbereinigung und -analyse.
  • Skalierbares Crawling: Extrahieren Sie mühelos Millionen von Elementen auf ganzen Websites, indem Sie URL-Muster definieren, denen der Crawler folgen soll.
  • Bring Your Own Key (BYOK): Eine Option, Ihren persönlichen OpenAI-API-Schlüssel zu verwenden, was Kosten senken und ein großzügigeres Kontingent an kostenlosen Elementen bieten kann.

Anwendungsfälle für FetchFox

FetchFox ist vielseitig und kann in verschiedenen Branchen und Rollen eingesetzt werden:

  • Vertrieb und Lead-Generierung: Scrapen Sie Branchenverzeichnisse, LinkedIn Sales Navigator oder berufliche Netzwerke, um gezielte Lead-Listen mit Namen, Jobtiteln, Unternehmen und Kontaktdaten zu erstellen.
  • Markt- und Wettbewerbsforschung: Sammeln Sie Produktinformationen, Preise und Kundenbewertungen von E-Commerce-Websites wie Amazon oder eBay, um Markttrends und Wettbewerbsstrategien zu analysieren.
  • Finanzdatenaggregation: Sammeln Sie Daten von Finanznachrichten-Websites, Börsenplattformen oder DeFi-Protokollen für Investitionsanalysen und Modelltraining.
  • Akademische und wissenschaftliche Forschung: Stellen Sie große Datensätze aus verschiedenen Online-Quellen, Veröffentlichungen oder öffentlichen Aufzeichnungen für akademische Studien zusammen.
  • Immobilienanalyse: Sammeln Sie Immobilienangebote, Preise und Maklerdetails von Immobilien-Websites, um die Marktbedingungen zu überwachen.

Vorteile von FetchFox

Der Hauptvorteil von FetchFox ist seine radikale Einfachheit und Leistungsfähigkeit. Es demokratisiert das Web-Scraping und macht es auch für Benutzer ohne technischen Hintergrund zugänglich. Für Entwickler beschleunigt es den Entwicklungsprozess erheblich, indem es die mühsamsten und anspruchsvollsten Aspekte des Scrapings abstrahiert. Seine Widerstandsfähigkeit gegenüber Website-Änderungen bedeutet weniger Zeit für die Wartung defekter Skripte und mehr Zeit für die Nutzung der Daten. Die Kombination aus einer leistungsstarken KI-Engine und einer robusten Infrastruktur macht es zu einem hocheffizienten und zuverlässigen Werkzeug für jede Datenextraktionsaufgabe.

Preise und Pläne

FetchFox verwendet ein unkompliziertes, transparentes Pay-as-you-go-Preismodell.

  • Kostenlose Stufe: Neue Benutzer erhalten ihre ersten 1.000 extrahierten Elemente kostenlos. Ein 'Element' entspricht einer Datenzeile (z. B. die Details eines Produkts).
  • Standardpreis: Nach der kostenlosen Stufe beträgt der Preis pauschal 1 $ pro 1.000 Elemente.
  • Bring Your Own Key (BYOK) Bonus: Wenn Sie sich dafür entscheiden, Ihren eigenen OpenAI-API-Schlüssel zu verwenden, erhalten Sie zusätzlich 10.000 kostenlose Elemente. Dies kann eine kostengünstigere Option für Benutzer mit bestehenden OpenAI-Konten sein.
  • Individuelle Pläne: Für Benutzer mit groß angelegten Scraping-Anforderungen oder komplexen Anforderungen bietet FetchFox individuelle Unternehmenspläne an. Interessenten können sich für eine Beratung an ihr Vertriebsteam wenden.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
DatenextraktionWeb ScrapingLead-Generierung
Nur Crawlbase
Keine verifizierten Daten
Nur FetchFox
Automatisierung

Tags

Gemeinsam
APIDatenextraktionData MiningLead-GenerierungWeb Scraping
Nur Crawlbase
KI-TrainingsdatenCrawlerE-Commerce-DatenProxySEO-Tools
Nur FetchFox
KI-ScraperAutomatisierungEntwicklerwerkzeugeMarktforschungNo-Code

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Crawlbase
GeschäftsinhaberDatenanalystMarketing ManagerProduktmanagerForscherVertriebsmitarbeiterSEO-SpezialistSoftwareentwickler
Nur FetchFox
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Crawlbase monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
32.4K
Ø Besuchsdauer
0:19
Seiten pro Besuch
2
Absprungrate
38.17%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 82.1K
  • 2026-01: 74.4K
  • 2026-02: 50K
  • 2026-03: 46.3K
  • 2026-04: 35.7K
  • 2026-05: 32.4K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇩🇪Germany25.96%8.4K
🇷🇺Russia22.56%7.3K
🇻🇳Vietnam18.35%5.9K
🇳🇬Nigeria17.5%5.7K
🇺🇸United States15.63%5.1K

Suchbegriffe

apifycrawlbasedeviantart scraperwebscraping at scaleпрокси в 2026 году бесплатно

FetchFox monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
40.3K
Ø Besuchsdauer
5:28
Seiten pro Besuch
4.08
Absprungrate
57.8%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.7K
  • 2026-01: 1.9K
  • 2026-02: 771
  • 2026-03: 1K
  • 2026-04: 14.8K
  • 2026-05: 40.3K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇳India45.78%18.5K
🇺🇸United States44.91%18.1K
🇪🇸Spain9.31%3.8K

Suchbegriffe

fetch foxfetchfox aifetchfoxaifetchfox.iafounding engineer equity

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Crawlbase

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
187
Likes
195

FetchFox

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
149
Likes
149

Crawlbase vs FetchFox · Vergleichs-FAQ

What do Crawlbase and FetchFox have in common?
Both tools are listed under Datenextraktion、Web Scraping、Lead-Generierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Crawlbase and FetchFox free?
Listed pricing models: Crawlbase — Freemium; FetchFox — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Crawlbase and FetchFox?
The primary listed category is Datenextraktion for Crawlbase, and Datenextraktion for FetchFox. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche